

Python函数是否存在判断方法
判断Python函数是否存在可通过hasattr()检查对象属性,2.使用'inglobals()'或'inlocals()'检查作用域内定义,3.结合callable()确保该属性可调用,4.更Pythonic的做法是使用try-except遵循EAFP原则,5.在插件系统、可选依赖或动态命令分发等场景中,显式检查函数存在性可提升程序健壮性,6.需注意作用域混淆和过度检查的陷阱,推荐配合清晰错误提示、默认回退机制或抽象基类实现优雅降级,最终方案应根据具体上下文选择。
判断Python函数是否存在可通过hasattr()检查对象属性,2. 使用'in globals()'或'in locals()'检查作用域内定义,3. 结合callable()确保该属性可调用,4. 更Pythonic的做法是使用try-except遵循EAFP原则,5. 在插件系统、可选依赖或动态命令分发等场景中,显式检查函数存在性可提升程序健壮性,6. 需注意作用域混淆和过度检查的陷阱,推荐配合清晰错误提示、默认回退机制或抽象基类实现优雅降级,最终方案应根据具体上下文选择。
在Python中判断一个函数是否存在,通常不是直接去问“它在不在那里”,而是通过检查它是否作为某个对象的属性存在,或者是否在当前作用域(全局或局部)中被定义。最常见且直接的方式是使用hasattr()函数来检查对象是否拥有某个属性,或者尝试从字典(如globals()或locals())中获取它。当然,更“Pythonic”的做法往往是尝试使用它,然后捕获可能出现的错误。
解决方案
要判断一个Python函数是否存在,我们有几种核心策略,这取决于你所说的“存在”指的是什么情境。
如果函数是某个模块(或类、实例)的成员,我们可以用hasattr()来检查。这非常直观,比如你想知道math模块里有没有一个叫sqrt的函数:
import math

if hasattr(math, 'sqrt'):
    print("math模块有sqrt函数。")
else:
    print("math模块没有sqrt函数。")

# 假设我们有一个类
class MyClass:
    def my_method(self):
        pass

if hasattr(MyClass, 'my_method'):
    print("MyClass有my_method方法。")
else:
    print("MyClass没有my_method方法。")
这种方法尤其适用于检查已导入的模块、类或实例中是否存在特定的方法或函数。它告诉你的是“这个名字的属性是否存在于这个对象上”。
而如果函数是全局作用域中的一个独立函数,或者在当前局部作用域内,我们可以通过检查globals()或locals()字典来判断。globals()返回当前模块的全局符号表,而locals()返回当前函数或模块的局部符号表。
def my_global_function():
    pass

if 'my_global_function' in globals():
    print("my_global_function在全局作用域中。")
else:
    print("my_global_function不在全局作用域中。")

def another_function_scope():
    def inner_local_function():
        pass

    if 'inner_local_function' in locals():
        print("inner_local_function在当前局部作用域中。")
    else:
        print("inner_local_function不在当前局部作用域中。")

another_function_scope()这里需要注意的是,locals()在模块级别调用时,其行为可能与globals()相似。但在函数内部,locals()会准确反映该函数的局部变量和定义。
此外,我们还可以结合callable()函数,它能判断一个对象是否可调用。因为即使一个属性存在,它也可能不是一个函数(比如它是一个变量)。
import math

if hasattr(math, 'sqrt') and callable(math.sqrt):
    print("math.sqrt存在且可调用。")

class MyClass:
    my_var = 10
    def my_method(self):
        pass

if hasattr(MyClass, 'my_var') and callable(MyClass.my_var):
    print("MyClass.my_var存在且可调用。") # 不会打印
else:
    print("MyClass.my_var存在但不可调用。")

if hasattr(MyClass, 'my_method') and callable(MyClass.my_method):
    print("MyClass.my_method存在且可调用。")
这种组合方式提供了更强的保证:不仅名字存在,而且它确实是一个可以被执行的“函数”或“方法”。
什么时候我们需要检查Python函数的存在性?
在日常编码中,我们并非总需要显式地去检查一个函数是否存在。很多时候,Python的“请求原谅而非许可”(Easier to Ask for Forgiveness than Permission, EAFP)哲学是更推荐的做法:直接尝试调用,如果出错了就捕获异常。然而,有些特定场景下,预先检查函数的存在性会显得更为合理和健壮。
比如,你在开发一个插件系统或者一个可扩展的框架。用户可以编写自己的模块或类,并注册到你的系统中。你的主程序可能需要调用这些用户提供的模块中的特定函数(例如,一个名为process_data的函数)。这时候,你不能假设用户一定提供了这个函数。在加载插件时,你可以检查这个函数是否存在,如果不存在,则给出友好的警告或使用默认行为,而不是直接崩溃。
# 模拟插件加载
def load_plugin(module_name):
    try:
        plugin_module = __import__(module_name)
        if hasattr(plugin_module, 'process_data') and callable(plugin_module.process_data):
            print(f"插件 {module_name} 提供了 process_data 函数。")
            return plugin_module.process_data
        else:
            print(f"警告:插件 {module_name} 未提供可调用的 process_data 函数。")
            return None
    except ImportError:
        print(f"错误:无法导入插件 {module_name}。")
        return None

# 假设用户提供了 plugin_a.py 和 plugin_b.py
# plugin_a.py:
# def process_data(data):
#     return data.upper()
#
# plugin_b.py:
# my_data_processor = "not a function"

processor_a = load_plugin('plugin_a')
if processor_a:
    print(processor_a("hello"))

processor_b = load_plugin('plugin_b') # 这里会触发警告
另一个场景是处理可选依赖。你的代码可能依赖于某个库的某个特定功能,但这个功能可能只存在于该库的较新版本中。为了保持兼容性,你可以检查这个新功能是否存在,如果不存在,就回退到旧的实现方式。
还有,在进行一些动态分发或命令模式的实现时,你可能根据字符串名称来查找并执行对应的函数。在这种情况下,预先检查可以避免运行时错误。
# 动态命令执行
commands = {
    "greet": lambda name: print(f"Hello, {name}!"),
    "farewell": lambda name: print(f"Goodbye, {name}!")
}

user_input = "greet" # 假设用户输入
if user_input in commands and callable(commands[user_input]):
    commands[user_input]("Alice")
else:
    print(f"未知命令:{user_input}")
这些情况都表明,在设计更灵活、更具容错性的系统时,显式检查函数存在性是很有价值的。
callable()与hasattr()有什么区别?
callable()和hasattr()虽然都能用于判断某种“存在”,但它们关注的侧重点截然不同,因此在实际使用中不能互相替代,而是常常结合使用。
hasattr(object, name)的作用是检查object是否有一个名为name的属性。它只关心名字是否存在于对象的属性字典中,而不关心这个属性的值是什么类型,或者它是否可以被调用。比如,一个类实例可能有一个属性叫data,它是一个列表;或者一个方法叫process。hasattr都会返回True,只要这个名字存在。
class Example:
    value = 10
    def method(self):
        pass

obj = Example()

print(hasattr(obj, 'value'))   # True,因为obj有value属性
print(hasattr(obj, 'method'))  # True,因为obj有method属性
print(hasattr(obj, 'non_existent')) # False而callable(object)的作用是检查object本身是否是一个可调用的对象。这意味着它能否像函数一样被加上括号()来执行。可调用的对象包括:函数、方法、类(调用类会创建实例)、某些内置函数、以及实现了__call__方法的类的实例。callable()不关心对象的名字,只关心对象本身是否具备被调用的能力。
def my_function():
    pass

class MyClass:
    def __call__(self):
        print("Instance is callable!")

my_instance = MyClass()

print(callable(my_function))   # True
print(callable(MyClass))       # True (类本身是可调用的,用来创建实例)
print(callable(my_instance))   # True (实例实现了__call__方法)
print(callable(123))           # False (整数不可调用)
print(callable("hello"))       # False (字符串不可调用)
那么,它们的区别就很明显了:
hasattr()关注的是“名字”是否存在于某个“容器”中。callable()关注的是“对象”本身是否具备“可调用”的特性。
当你想确保一个对象不仅有某个名字的属性,而且这个属性确实是一个可以被执行的函数或方法时,你通常会把它们结合起来使用:if hasattr(obj, 'method_name') and callable(getattr(obj, 'method_name')):。这样能确保你取出的method_name确实是个函数,避免了尝试调用一个非函数属性的TypeError。
处理不存在的函数时有哪些常见的陷阱或最佳实践?
处理可能不存在的函数时,我们确实会遇到一些小麻烦,但也总结出了一些行之有效的方法。
一个常见的“陷阱”是过于依赖显式检查,而忽略了Python的异常处理机制。虽然前面提到了显式检查的优点,但在很多情况下,直接尝试调用并捕获异常(EAFP原则)反而更简洁、更符合Python的风格。
# 假设我们想调用一个可能不存在的函数
def process_data_safe(data, processor_func_name):
    try:
        # 尝试从全局作用域获取并调用
        processor = globals()[processor_func_name]
        if callable(processor): # 额外确认是可调用的
            return processor(data)
        else:
            print(f"错误:'{processor_func_name}'存在但不可调用。")
            return None
    except KeyError:
        print(f"错误:函数'{processor_func_name}'不存在。")
        return None
    except Exception as e: # 捕获其他可能的错误
        print(f"调用'{processor_func_name}'时发生错误:{e}")
        return None

def my_processor(d):
    return d.upper()

print(process_data_safe("hello", "my_processor"))
print(process_data_safe("world", "non_existent_processor"))这种模式在很多库中都有体现,比如字典的get()方法,或者文件操作时的try-finally块。它将“正常”执行流放在try块中,将“异常”处理放在except块中,逻辑更清晰。
另一个需要注意的“陷阱”是作用域问题。如果你在函数内部尝试检查一个局部函数,用globals()是找不到的。必须用locals()。但locals()在某些情况下(比如在类定义体中)可能不会包含所有预期项,或者在优化过的代码中表现不一致。因此,理解变量和函数的作用域是关键。
最佳实践方面,除了EAFP原则,还有一些值得思考的地方:
- 清晰的错误消息: 无论是通过
if检查还是try-except,当函数不存在或不可用时,提供清晰、有帮助的错误或警告信息至关重要。这能帮助调试和用户理解。 - 默认行为或回退机制: 如果一个函数是可选的,当它不存在时,你的程序不应该崩溃,而是应该优雅地降级到某个默认行为,或者使用一个备用的实现。这在插件系统或配置解析中非常有用。
- 抽象基类(ABCs)或接口: 对于更大型、更结构化的项目,特别是涉及到插件或多态性时,与其在运行时检查每个函数,不如定义一个抽象基类或一个“接口”,明确规定所有实现类必须提供哪些方法。这样,你可以在类实例化时就检查其是否符合接口,而不是等到调用时才发现方法不存在。
from abc import ABC, abstractmethod

class PluginInterface(ABC):
    @abstractmethod
    def process_data(self, data):
        pass

class MyGoodPlugin(PluginInterface):
    def process_data(self, data):
        return data.upper()

class MyBadPlugin: # 没有实现process_data
    pass

def load_and_use_plugin(plugin_class, data):
    if issubclass(plugin_class, PluginInterface): # 检查是否是接口的子类
        try:
            plugin_instance = plugin_class()
            print(f"处理结果: {plugin_instance.process_data(data)}")
        except TypeError as e: # 如果抽象方法未实现,实例化时会报错
            print(f"错误:插件 {plugin_class.__name__} 未完全实现接口:{e}")
    else:
        print(f"错误:插件 {plugin_class.__name__} 不符合 PluginInterface。")

load_and_use_plugin(MyGoodPlugin, "hello")
load_and_use_plugin(MyBadPlugin, "world") # 提示不符合接口
这种方式将检查前置,确保了类型的正确性,是一种更“契约式”的编程风格。
总的来说,选择哪种方法取决于你的具体需求和代码的上下文。对于简单的、一次性的检查,hasattr()或in globals()可能足够。对于需要容错的动态行为,EAFP是首选。而对于需要强制遵循某种结构的大型系统,ABCs则提供了更强大的类型检查和设计模式。
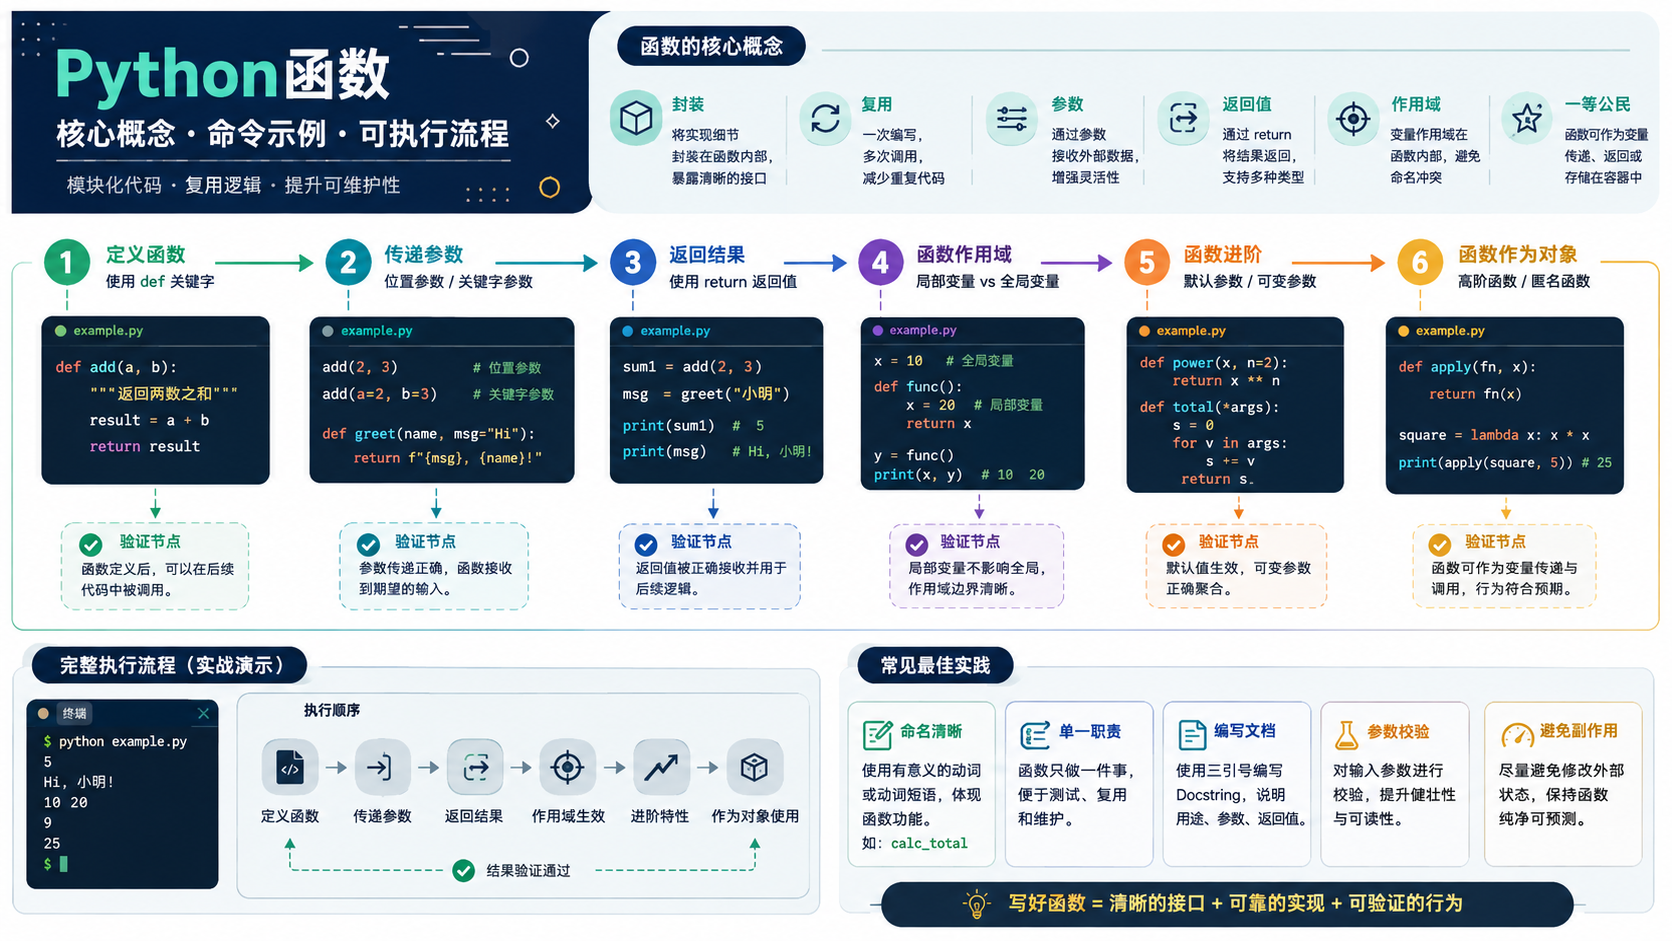
本文详解 python函数 的开发准备与实操流程,涵盖虚拟环境创建、依赖安装及系统验证,附带决策图辅助排错,帮助开发者构建稳定的Python运行环境。
是的,Python函数可以动态添加属性,1.可用于存储元数据、缓存或状态标记;2.操作方式为通过点语法直接赋值;3.常见于装饰器、框架设计中;4.需避免命名冲突、注意可读性与类型检查;5.最佳实践包括使用functools.wraps、明确用途并加强文档化,此机制体现了Python“一切皆对象”的设计哲学且应谨慎合理使用。
Python函数命名冲突的常见场景包括:导入多个模块时同名函数被覆盖、同一作用域内重复定义函数、与内置函数或标准库函数重名、以及大型项目中因缺乏统一规划导致的无意识命名重复。最典型的例子是使用frommoduleimport*或连续导入两个同名函数,后导入的会静默覆盖前者;在同一文件中定义两个同名函数也会导致后者覆盖前者而不报错;将自定义函数命名为len、sum等内置函数名会破坏原有功能;在大型项目中不同模块各自定义同名函数如parse_data,若未通过模块路径区分调用,极易引发逻辑错误。这些问题的核心
Python函数可通过闭包保存内部状态,核心在于嵌套函数引用并捕获外部函数的局部变量,即使外部函数已执行完毕,这些变量仍被保留。闭包需满足三个条件:函数嵌套、内部函数引用外部非全局变量、外部函数返回内部函数。与普通嵌套函数不同,闭包在外部函数结束后仍可访问其作用域中的变量,形成“持久化”状态。典型应用包括装饰器、工厂函数(如生成不同乘法器)、回调函数等,能实现轻量级状态封装。但需注意循环中变量延迟绑定问题(如for循环中i始终为最终值),可通过默认参数或立即调用外层函数解决;同时避免闭包捕获大对象导致内存
是的,Python函数可以通过类型提示指定返回值类型,从而提升代码可读性、可维护性,并支持静态类型检查工具如mypy进行类型验证。1.使用->符号在函数参数列表后标注返回值类型,例如defgreet(name:str)->str:returnf"Hello,{name}!";2.对于无返回值的函数,可标注为->None;3.复杂返回类型可用typing.Union[str,int,None]或Python3.10+的str|int|None表示联合类型;4.生成器函数应使用typing.
使用布尔值时应直接在if语句中判断,避免与True比较;2.采用描述性函数名提升可读性;3.利用any()和all()简化多条件判断;4.使用not增强逻辑清晰度;5.将复杂逻辑拆分为多个小函数并用逻辑运算符合并结果;6.避免嵌套过深,通过提前返回减少层级;7.编写单元测试覆盖各种输入及边界情况;8.使用mock隔离外部依赖确保测试独立性;9.保持测试用例独立且完整,确保布尔函数的可靠性与可维护性。
递归遍历嵌套列表的核心是函数调用自身处理子元素,直至遇到非列表元素并收集结果。代码通过isinstance判断元素类型,若为列表则递归遍历,否则收集数据。该方法结构清晰、逻辑直观,尤其适合深度不确定的嵌套结构。相比迭代,递归代码更简洁、易读,能自然映射树状数据结构,但存在栈溢出风险,尤其在嵌套过深时受Python默认递归深度限制。此外,递归函数调用开销较大,性能略逊于迭代,调试也较复杂。为收集特定数据,可让函数返回结果列表并逐层合并,或使用全局变量累积。迭代方案通过显式栈模拟遍历过程,虽代码稍复杂,但无深
凯撒密码通过固定位移实现加密,仅处理英文字母,非字母字符保留不变;2.XOR加密利用异或运算的可逆性,同一函数和密钥可完成加解密;3.这些方法适用于非敏感数据混淆,如配置文件或游戏存档,但不具备抗攻击能力;4.解密凯撒密码需反向位移,XOR则直接复用加密函数与密钥;5.简单加密不应用于敏感信息保护,应使用专业加密库如cryptography。
Python函数处理字符串的核心是封装常用操作,如大小写转换、去空格、替换等,通过定义函数调用内置方法(如.lower()、.strip()、.replace())实现代码复用与模块化,提升可读性和维护性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



