

Symfony 将MongoDB文档转为数组方法
在Symfony中将MongoDB文档转换为数组最直接的方式是使用DoctrineODM提供的toArray()方法,适用于简单文档结构;2.常见应用场景包括构建RESTfulAPI响应、数据导出、日志调试、表单预填充和缓存处理;3.toArray()方法的主要局限性在于不递归转换嵌套的嵌入式或引用文档,可能导致数组中仍包含对象实例;4.更灵活的替代方案是使用SymfonySerializer组件的normalize()方法,支持递归序列化、序列化组(serializationgroups)和自定义上下文
在 Symfony 中将 MongoDB 文档转换为数组最直接的方式是使用 Doctrine ODM 提供的 toArray() 方法,适用于简单文档结构;2. 常见应用场景包括构建 RESTful API 响应、数据导出、日志调试、表单预填充和缓存处理;3. toArray() 方法的主要局限性在于不递归转换嵌套的嵌入式或引用文档,可能导致数组中仍包含对象实例;4. 更灵活的替代方案是使用 Symfony Serializer 组件的 normalize() 方法,支持递归序列化、序列化组(serialization groups)和自定义上下文,能完整处理复杂嵌套结构并精确控制输出字段,推荐用于生产环境中的复杂序列化需求。
在 Symfony 中将 MongoDB 文档转换为数组,最直接且常用的方式是利用 Doctrine ODM 提供的 toArray() 方法。如果你使用的是原生的 MongoDB PHP 驱动,则需要手动遍历游标或文档对象来构建数组。但通常,在 Symfony 项目里,我们更倾向于通过 Doctrine ODM 来操作 MongoDB,它能大大简化这个过程。
解决方案
在 Symfony 项目里,当你通过 Doctrine ODM 从 MongoDB 获取到一个文档对象(比如一个 User 或 Product 文档实例)后,将其转换为 PHP 数组是一个非常常见的需求,尤其是在构建 RESTful API 响应时。
首先,你需要确保你的文档类已经通过 Doctrine ODM 映射正确。假设你有一个 Product 文档:
// src/Document/Product.php
namespace App\Document;

use Doctrine\ODM\MongoDB\Mapping\Annotations as MongoDB;

#[MongoDB\Document]
class Product
{
    #[MongoDB\Id]
    protected ?string $id = null;

    #[MongoDB\Field(type: 'string')]
    protected string $name;

    #[MongoDB\Field(type: 'float')]
    protected float $price;

    // ... getters and setters
}
从数据库获取文档通常会通过 DocumentManager:
// 假设在你的控制器或服务中
use Doctrine\ODM\MongoDB\DocumentManager;
use App\Document\Product;
use Symfony\Component\HttpFoundation\JsonResponse;
use Symfony\Bundle\FrameworkBundle\Controller\AbstractController;

class ProductController extends AbstractController
{
    public function showProduct(string $id, DocumentManager $dm): JsonResponse
    {
        $product = $dm->getRepository(Product::class)->find($id);

        if (!$product) {
            throw $this->createNotFoundException('Product not found');
        }

        // 核心步骤:使用 toArray() 方法
        $productArray = $product->toArray();

        // 此时 $productArray 应该是一个包含文档顶层字段的 PHP 数组
        // 例如:['id' => '...', 'name' => '...', 'price' => '...']

        return new JsonResponse($productArray);
    }
}
toArray() 方法会尝试将文档的属性转换为一个关联数组。不过,这里有个小坑,它默认情况下可能不会递归地处理所有嵌套的文档或引用。如果你有嵌套的嵌入式文档或集合,它们可能仍然是对象实例,而不是完全展开的数组。这在实际项目中经常会遇到,需要额外注意。
在 Symfony 中,将 MongoDB 文档转换为数组的常见场景有哪些?
将 MongoDB 文档转换为数组,在 Symfony 应用开发中,简直是家常便饭。最常见的,也是我个人觉得最核心的场景,就是构建 API 响应。当你开发一个 RESTful API 时,客户端通常期望接收 JSON 格式的数据,而 PHP 数组是转换为 JSON 最自然不过的中间形态。把一个文档对象直接返回给 JsonResponse,虽然 Symfony 也能处理,但如果文档内部结构复杂,或者你需要控制哪些字段对外暴露,转换成数组并进行精细化调整就显得尤为重要。
除了 API,还有一些场景也经常用到:
- 数据导出或与第三方系统集成: 当你需要将 MongoDB 中的数据导出为 CSV、Excel 或者发送给其他不支持对象直接传递的系统时,数组是通用的数据结构。
- 日志记录和调试: 在开发或排查问题时,将一个复杂的文档对象转换成数组,然后通过
dump()或日志工具打印出来,能让你更直观地看到数据结构,比直接打印对象要清晰得多。 - 表单预填充: 尽管 Symfony Form 组件通常能直接绑定对象,但在某些复杂场景下,或者你需要对数据进行预处理才能填充表单时,先将文档转为数组可能会更灵活。
- 缓存: 有时候,为了缓存某个文档的精简视图,将其序列化为数组后存储,可以减少缓存的体积,并且在读取时避免反序列化整个对象图谱。
这些场景都指向一个核心目的:将 Doctrine ODM 的领域模型对象,转换成更通用、更易于传输或处理的数据格式。
处理 MongoDB 文档中嵌套数据结构时,toArray() 方法有哪些局限性?
toArray() 方法确实方便,但它并非万能药,尤其是在处理 MongoDB 文档中常见的嵌套数据结构时,它的局限性就会显现出来。我遇到过不少开发者,包括我自己,最初都想当然地认为 toArray() 会“智能”地递归转换所有子文档和集合,但事实往往不是这样。
主要的局限性在于:
非递归转换: 默认情况下,
toArray()通常只处理文档的顶层字段。如果你的文档中包含嵌入式文档(@MongoDB\EmbedOne或@MongoDB\EmbedMany)或者引用文档(@MongoDB\ReferenceOne或@MongoDB\ReferenceMany),这些嵌套的字段在转换后很可能仍然是 Doctrine ODM 的文档对象实例,而不是它们自身也被转换成了数组。这意味着,你得到的是一个“半成品”数组,里面还夹杂着对象。例如,如果你的
Product文档里有一个嵌入的Details文档:// src/Document/Product.php #[MongoDB\Document] class Product { // ... #[MongoDB\EmbedOne(targetDocument: Details::class)] protected Details $details; // ... } // src/Document/Details.php #[MongoDB\EmbeddedDocument] class Details { #[MongoDB\Field(type: 'string')] protected string $description; // ... }当你调用
$product->toArray()时,$productArray['details']可能仍然是一个Details对象,而不是['description' => '...']这样的数组。引用文档的处理: 对于通过
ReferenceOne或ReferenceMany关联的文档,toArray()更不会去自动加载并转换它们。它只会返回这些引用的 ID,或者一个 Doctrine ODM 的代理对象(proxy object),除非这些引用已经被显式加载。这对于需要完整关联数据的 API 来说,是个大问题。性能考量: 即使你尝试手动递归转换,如果文档结构非常深,或者包含大量嵌入式数据,手动遍历和转换可能会导致性能问题,尤其是在循环中触发额外的数据库查询(N+1 问题)。
这些局限性意味着,对于复杂的文档结构,仅仅依赖 toArray() 是不够的。你需要更强大、更灵活的序列化工具来确保所有数据都能按照预期转换成数组。
除了 toArray(),Symfony 中还有哪些更灵活的方式来序列化 MongoDB 文档?
当 toArray() 无法满足需求,特别是涉及到复杂的嵌套结构、选择性字段暴露或自定义格式时,Symfony 的 Serializer 组件就成了我们的首选利器。这几乎是 Symfony 处理任何对象序列化到数组(或 JSON/XML)的标准和最强大的方法。
以下是几种更灵活的序列化方式:
Symfony Serializer 组件: 这是最推荐的方案。它提供了一个高度可配置的序列化/反序列化机制。
基本用法: 你可以注入
Symfony\Component\Serializer\SerializerInterface服务,然后调用其normalize()方法将对象转换为数组。use Symfony\Component\Serializer\SerializerInterface; use App\Document\Product; use Symfony\Component\HttpFoundation\JsonResponse; use Symfony\Bundle\FrameworkBundle\Controller\AbstractController; use Doctrine\ODM\MongoDB\DocumentManager; class ProductController extends AbstractController { public function showProduct(string $id, DocumentManager $dm, SerializerInterface $serializer): JsonResponse { $product = $dm->getRepository(Product::class)->find($id); if (!$product) { throw $this->createNotFoundException('Product not found'); } // 使用 normalize() 方法将文档对象转换为数组 // 第一个参数是对象,第二个参数是格式(通常是 'json' 或 'array') // 第三个参数是上下文数组,可以传递序列化组等选项 $productArray = $serializer->normalize($product, 'json',
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
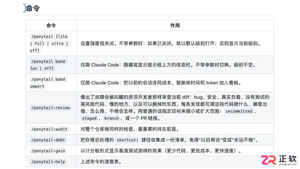
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
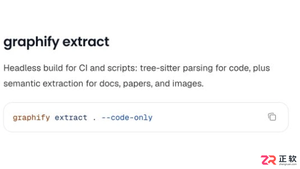
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
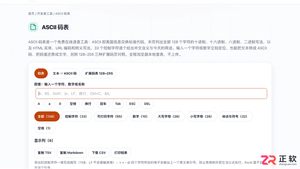
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。
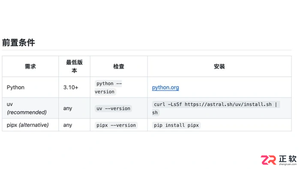
面向需要在本地部署Graphify工具的开发人员,本文详解基于Python 3.10+环境的安装流程。针对用户常遇到的依赖冲突问题,推荐使用uv或pipx创建独立运行环境。内容涵盖graphifyy官方包的安装验证、CLI命令可用性检查,以及针对Claude Code等编码助手的技能注册步骤,帮助读者快速完成从环境准备到功能集成的全过程。
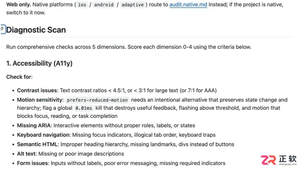
面向需要优化前端界面的开发者,Impeccable借助AI编程助手辅助改进具体页面。它常用于评审页面技术质量、调整移动端与桌面端布局,以及简化复杂界面以降低认知负荷。使用时需针对不同目标选择专用命令,如audit用于检查问题,adapt用于设备适配,distill用于精简内容。本文介绍如何通过明确指令聚焦单一任务,避免一次性重构整个项目,并在修改后通过实际业务流程验证功能完整性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



