

多对多有序关联与级联删除策略详解
本教程深入探讨了在SQLAlchemy中如何构建和管理具有特定顺序的多对多(N:M)关系,并着重解决了级联删除操作中的常见挑战。通过使用关联对象模式,我们不仅能够存储关系中的额外数据(如顺序),还能确保在父对象(如文件夹)被删除时,其关联的子对象(如项目)能够被正确地级联删除,避免数据孤立。文章提供了详细的模型定义、关键配置解析及验证测试,旨在帮助开发者实现健壮的数据模型。

1. 引言:有序关联与级联删除的挑战
在数据模型设计中,我们经常遇到需要维护对象之间顺序的场景,例如在一个文件夹中按照特定顺序排列项目。当这种关系是多对多(N:M)时,即一个文件夹可以包含多个项目,一个项目也可以属于多个文件夹,情况会变得复杂。更进一步,如果要求一个项目只能属于一个文件夹(即实际上是 1:N 关系,但通过 N:M 结构实现额外属性),并希望在删除文件夹时,其关联的项目也能被自动删除,这就需要精心配置 SQLAlchemy 的关系和级联策略。
最初,开发者可能尝试在父对象中存储一个 ID 列表来维护顺序,但这容易导致数据不一致。更健壮的方法是使用关联对象(Association Object)模式,它允许在关系表中存储额外的数据,例如 order 字段。然而,即使使用了关联对象,正确的级联删除配置也常常是难点,尤其是在涉及到多个对象间的删除依赖时。
2. 使用关联对象实现有序关系
为了在多对多关系中存储额外的属性(如 order),SQLAlchemy 推荐使用关联对象模式。在这种模式下,我们引入一个中间表(即关联对象)来连接两个主表,并在中间表中定义额外属性。
2.1 初始模型设计(存在级联删除问题)
以下是使用关联对象实现有序关系,但级联删除存在问题的模型结构:
from sqlalchemy import Column, Integer, BigInteger, ForeignKey
from sqlalchemy.orm import relationship, declarative_base

Base = declarative_base()

class Folder(Base):
    __tablename__ = "folder"
    id = Column(Integer, primary_key=True)

    # 通过 item_associations 关系管理关联对象
    item_associations = relationship(
        "FolderItemAssociation",
        back_populates="folder",
        order_by="desc(FolderItemAssociation.order)", # 按顺序排序
        single_parent=True,  # N:M -> 1:M,表示关联对象有单一父级
        cascade="all, delete-orphan", # 当Folder删除时,关联对象也删除
    )

class FolderItemAssociation(Base):
    __tablename__ = "folder_item_association"

    project_id = Column(
        Integer,
        ForeignKey("folder.id", ondelete="CASCADE"),
        primary_key=True,
    )
    item_id = Column(
        Integer,
        ForeignKey("item.id", ondelete="CASCADE"),
        primary_key=True,
        unique=True,  # 关键:一个 Item 只能与一个 Folder 关联
    )
    order = Column(
        BigInteger,
        autoincrement=True, # 尝试自动递增,可能需要数据库特定配置
    )

    folder = relationship(
        "Folder",
        back_populates="item_associations",
    )
    item = relationship(
        "Item",
        back_populates="folder_association",
        # 缺少关键的 cascade 和 single_parent 配置
    )

class Item(Base):
    __tablename__ = "item"
    id = Column(Integer, primary_key=True)

    folder_association = relationship(
        "FolderItemAssociation",
        back_populates="item",
        passive_deletes=True, # 允许数据库层面的级联删除
        uselist=False, # 因为 item_id 在关联表中是 unique,所以一个 Item 只有一个关联
    )
在这个设计中,FolderItemAssociation 表存储了 folder_id、item_id 以及 order。item_id 上的 unique=True 约束确保了每个 Item 实例只能被一个 Folder 关联。Folder 与 FolderItemAssociation 之间配置了 cascade="all, delete-orphan",这意味着当 Folder 被删除时,其关联的 FolderItemAssociation 记录也会被删除。
然而,测试发现,当 Folder 被删除时,FolderItemAssociation 记录确实被删除了,但关联的 Item 对象却仍然存在,成为了“孤儿”数据。这是因为 FolderItemAssociation 到 Item 的关系没有正确配置级联删除。
3. 解决级联删除问题:关键配置解析
要确保 Folder 删除时 Item 也能被级联删除,我们需要在 FolderItemAssociation 到 Item 的关系上添加 cascade="all, delete-orphan" 和 single_parent=True。
3.1 核心原理
- 当 Folder 被删除时,由于 Folder.item_associations 关系上的 cascade="all, delete-orphan",所有与该 Folder 关联的 FolderItemAssociation 记录会被删除。
- 当 FolderItemAssociation 记录被删除时,由于其 item 关系上的 cascade="all, delete-orphan",它所关联的 Item 对象也会被删除。
single_parent=True 在 FolderItemAssociation.item 关系中的作用是至关重要的。它告诉 SQLAlchemy,FolderItemAssociation 是 Item 的“唯一父级”之一,允许通过此关系进行 delete-orphan 操作。结合 unique=True 在 FolderItemAssociation.item_id 上的约束(一个 Item 只能被一个 Folder 关联),这确保了当该关联记录被删除时,如果 Item 没有其他父级,它将被视为孤儿并被删除。
3.2 修正后的模型定义
import sys
from sqlalchemy import create_engine, Column, Integer, String, BigInteger, ForeignKey
from sqlalchemy.orm import declarative_base, Session, relationship

Base = declarative_base()

# --- 数据库连接配置 (示例,请根据实际环境修改) ---
# username, password, db = sys.argv[1:4]
# engine = create_engine(f"postgresql+psycopg2://{username}:{password}@/{db}", echo=False)

class Folder(Base):
    __tablename__ = "folder"
    id = Column(Integer, primary_key=True)

    item_associations = relationship(
        "FolderItemAssociation",
        back_populates="folder",
        order_by="desc(FolderItemAssociation.order)",
        single_parent=True,
        cascade="all, delete-orphan",
    )

    def __repr__(self):
        return f"Folder(id={self.id}, item_associations={', '.join(repr(assoc) for assoc in self.item_associations)})"


class FolderItemAssociation(Base):
    __tablename__ = "folder_item_association"

    project_id = Column(
        Integer,
        ForeignKey("folder.id", ondelete="CASCADE"),
        primary_key=True,
    )
    item_id = Column(
        Integer,
        ForeignKey("item.id", ondelete="CASCADE"),
        primary_key=True,
        unique=True,  # 确保一个 Item 只能关联到一个 Folder
    )
    order = Column(
        BigInteger,
        # autoincrement=True, # 注意:BigInteger 的 autoincrement 在某些数据库(如 PostgreSQL)可能需要序列支持
    )

    folder = relationship(
        "Folder",
        back_populates="item_associations",
    )
    item = relationship(
        "Item",
        back_populates="folder_association",
        # --- 关键修改:添加 cascade 和 single_parent ---
        cascade="all, delete-orphan",
        single_parent=True
    )

    def __repr__(self):
        return f"Assoc(id={(self.project_id, self.item_id)}, order={self.order}, item={repr(self.item)})"

class Item(Base):
    __tablename__ = "item"
    id = Column(Integer, primary_key=True)

    folder_association = relationship(
        "FolderItemAssociation",
        back_populates="item",
        passive_deletes=True, # 允许数据库层面的级联删除(如果适用)
        uselist=False,
    )

    def __repr__(self):
        return f"Item(id={self.id})"

# Base.metadata.create_all(engine) # 实际运行时需要创建表
注意事项:
- order 列的 autoincrement: 对于 BigInteger 类型的 order 列,autoincrement=True 在某些数据库(如 PostgreSQL)中可能不会自动填充。你可能需要手动管理 order 值,或者使用数据库的序列(sequence)功能。
- Folder.items 关系: 在原始问题中,Folder 类还有一个 items 关系,使用 secondary="folder_item_association"。当显式管理关联对象时,这个 secondary 关系可能会引起混淆。为了简化和明确职责,建议将其移除或设置为 viewonly=True。本教程中的修正版本已将其移除。
- passive_deletes=True: 在 Item.folder_association 关系中,passive_deletes=True 表示 SQLAlchemy 不会在 Python 对象层面主动处理删除,而是依赖数据库的 ON DELETE CASCADE 约束来完成。这通常用于优化性能,但在某些复杂场景下可能需要谨慎使用。
4. 实践验证:级联删除测试用例
为了验证上述配置是否正确,我们可以编写一系列测试用例来模拟不同的删除场景。
# 假设 engine 和 Base 已经定义
# from sqlalchemy import create_engine, ...
# from sqlalchemy.orm import Session
# Base.metadata.create_all(engine) # 确保表已创建

# 示例:使用 SQLite 内存数据库进行测试
from sqlalchemy import create_engine
engine = create_engine("sqlite:///:memory:", echo=False)
Base.metadata.create_all(engine)

def reset(session):
    """重置数据库状态,清空所有表数据"""
    session.query(Folder).delete()
    session.query(FolderItemAssociation).delete()
    session.query(Item).delete()
    session.commit()
    assert_counts(session, (0, 0, 0))

def assert_counts(session, expected_counts):
    """验证各表的记录数量"""
    counts = get_counts(session)
    assert counts == expected_counts, f'Expected {expected_counts} but got {counts}'

def get_counts(session):
    """获取各表的记录数量"""
    return (
        session.query(Folder).count(),
        session.query(FolderItemAssociation).count(),
        session.query(Item).count(),
    )

def create_sample_folders(session):
    """创建示例数据"""
    folder1 = Folder(
        item_associations=[
            FolderItemAssociation(item=Item()),
            FolderItemAssociation(item=Item())
        ]
    )
    session.add(folder1)
    folder2 = Folder(
        item_associations=[
            FolderItemAssociation(item=Item()),
            FolderItemAssociation(item=Item())
        ]
    )
    session.add(folder2)
    session.commit()

    print(repr(folder1))
    print(repr(folder2))

def test_folder_deletion_cascades_to_items():
    """测试:删除 Folder 时,所有关联的 Item 及其关联记录应被删除。"""
    print("\n--- Running test_folder_deletion_cascades_to_items ---")
    with Session(engine) as session:
        reset(session)
        create_sample_folders(session)
        assert_counts(session, (2, 4, 4)) # 2个Folder, 4个Association, 4个Item

        # 删除第一个 Folder
        session.delete(session.query(Folder).first())
        session.commit()

        # 预期:剩下1个Folder, 2个Association, 2个Item
        assert_counts(session, (1, 2, 2))
        reset(session)

def test_item_deletion_does_not_delete_folder():
    """测试:删除 Item 时,Folder 不应被删除,但关联记录应被删除。"""
    print("\n--- Running test_item_deletion_does_not_delete_folder ---")
    with Session(engine) as session:
        reset(session)
        create_sample_folders(session)
        assert_counts(session, (2, 4, 4))

        # 删除第一个 Item
        session.delete(session.query(Item).first())
        session.commit()

        # 预期:2个Folder, 3个Association, 3个Item
        assert_counts(session, (2, 3, 3))
        reset(session)

def test_association_deletion_cascades_to_item():
    """测试:删除 FolderItemAssociation 时,其关联的 Item 应被删除,Folder 不应被删除。"""
    print("\n--- Running test_association_deletion_cascades_to_item ---")
    with Session(engine) as session:
        reset(session)
        create_sample_folders(session)
        assert_counts(session, (2, 4, 4))

        # 删除第一个 FolderItemAssociation
        session.delete(session.query(FolderItemAssociation).first())
        session.commit()

        # 预期:2个Folder, 3个Association, 3个Item
        assert_counts(session, (2, 3, 3))
        reset(session)

# 运行所有测试
test_folder_deletion_cascades_to_items()
test_item_deletion_does_not_delete_folder()
test_association_deletion_cascades_to_item()
运行这些测试,你会发现当 Folder 被删除时,其关联的 FolderItemAssociation 和 Item 都会被正确删除,达到了预期的级联效果。同时,删除 Item 或 FolderItemAssociation 只会影响其自身及其直接关联,不会波及 Folder。
5. 总结与最佳实践
通过本教程,我们学习了如何在 SQLAlchemy 中使用关联对象模式来管理具有顺序的多对多关系,并解决了复杂的级联删除问题。关键在于:
- 使用关联对象: 当需要在关系中存储额外数据(如 order)时,始终使用关联对象模式。
- 明确关系方向: 理解你的业务逻辑中,哪个对象是“父级”,哪个是“子级”,即使在 N:M 关系中也可能存在这种逻辑上的父子关系(例如一个 Item 只能属于一个 Folder)。
- 精确配置 cascade 和 single_parent:
- 在父对象到关联对象的 relationship 上设置 cascade="all, delete-orphan",确保父对象删除时关联对象也删除。
- 在关联对象到子对象的 relationship 上也设置 cascade="all, delete-orphan" 和 single_parent=True,这是确保子对象被级联删除的关键。single_parent=True 结合 unique=True 约束(如果适用)能够正确地标识“孤儿”子对象。
- 审慎使用 secondary 关系: 当显式管理关联对象时,如果 secondary 关系(如 Folder.items)与关联对象关系(如 Folder.item_associations)同时存在,可能会导致混淆。建议移除 secondary 关系或将其设置为 viewonly=True。
- 验证级联行为: 始终通过编写测试用例来验证你的级联删除配置是否符合预期,避免数据孤立或意外删除。
掌握这些技巧,将使你能够构建更健壮、更符合业务逻辑的 SQLAlchemy 数据模型。
Cursor新增实时语音对话,支持在Agent运行任务时交流并听取进度,覆盖Agents Window、IDE、网页端与iOS,语音通话需登录账号并开启麦克风权限。
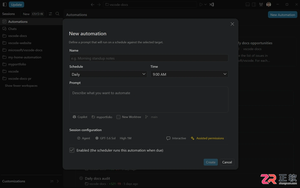
VS Code 1.145新增本地Cron调度,扩展远程Agent预览能力;后续1.145.1与1.145.2修正遥测归属和事件路由。文中区分正式、预览及实验性功能。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
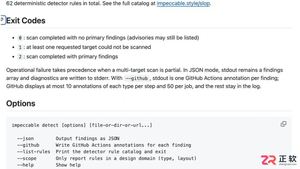
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
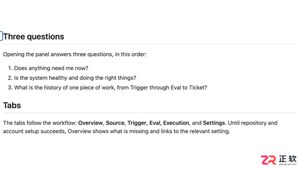
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
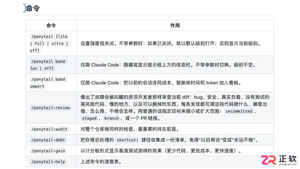
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
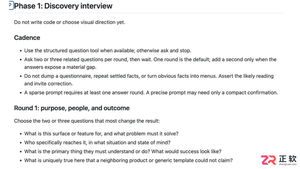
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
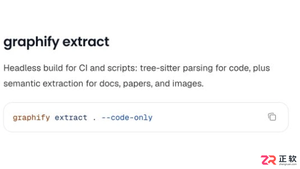
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
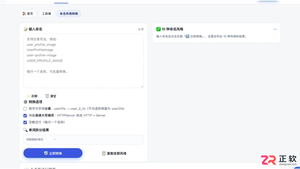
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
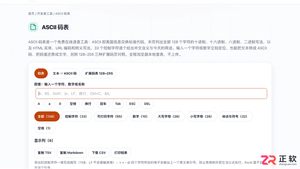
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



