

C++结构体跨平台对齐问题解决方法
C++结构体跨平台大小不一致主因是编译器对内存对齐和数据类型大小的处理差异,可通过#pragmapack或__attribute__((packed))强制紧凑对齐,结合固定宽度整型如int32_t,并采用序列化技术解决字节序和兼容性问题。
C++结构体跨平台大小不一致主因是编译器对内存对齐和数据类型大小的处理差异,可通过#pragma pack或__attribute__((packed))强制紧凑对齐,结合固定宽度整型如int32_t,并采用序列化技术解决字节序和兼容性问题。
C++结构体在不同平台编译后大小不一致,主要原因是编译器对数据成员的内存对齐方式不同。要解决这个问题,核心在于显式地控制结构体的内存对齐方式,确保在所有目标平台上都遵循相同的规则,或者干脆放弃直接传输原始结构体,转而采用更通用的序列化手段。
解决方案
说实话,解决C++结构体跨平台编译时因对齐导致的大小不一致问题,没有一劳永逸的“银弹”,但我们有一些非常有效的策略可以组合使用。最直接的方法就是强制编译器按照我们指定的规则进行对齐。
首先,我们可以使用编译器提供的对齐控制指令。对于GCC和Clang,__attribute__((packed)) 是个好东西,它能告诉编译器不要在结构体成员之间插入填充字节,让结构体尽可能紧凑。比如:
struct __attribute__((packed)) MyPackedStruct {
    char a;
    int b;
    short c;
};这样一来,无论在哪个平台,MyPackedStruct 的大小都会是 sizeof(char) + sizeof(int) + sizeof(short),也就是 1 + 4 + 2 = 7个字节(假设int是4字节,short是2字节)。但要注意,访问未对齐的数据可能会导致性能下降,甚至在某些体系结构上引发硬件异常,所以使用时要权衡利弊。
对于微软的Visual C++,我们通常用 #pragma pack(push, 1) 和 #pragma pack(pop) 来实现类似的效果:
#pragma pack(push, 1) // 设置对齐字节为1
struct MyPackedStruct {
    char a;
    int b;
    short c;
};
#pragma pack(pop) // 恢复默认对齐
这里的 1 表示将对齐字节设置为1,也就是不进行任何填充。这两种方式虽然语法不同,但目的都是一样的:强制结构体紧凑排列。
从C++11开始,标准引入了 alignas 关键字,这提供了一个更标准化的方式来控制对齐。虽然它主要用于增加对齐(比如强制一个结构体按64字节对齐),但你也可以用它来确保所有平台都至少按照某个最小对齐值来处理,避免意外的填充。不过,alignas(1) 这种用法并不常见,因为通常我们会希望默认对齐或者更严格的对齐。
除了显式对齐,我们还应该尽量使用固定宽度整数类型,比如 int8_t, uint16_t, int32_t, uint64_t 等。这些类型在不同平台上的大小是确定的,不会因为 int 在32位系统是4字节、在64位系统也是4字节(但long可能不同)而产生歧义。
最后,也是最根本的解决思路,如果你需要跨平台进行数据交换(比如网络传输或文件存储),直接传输原始结构体字节流其实是个“危险动作”。更好的做法是采用序列化(Serialization)机制。这意味着你将结构体中的数据成员逐个提取出来,按照一个定义好的协议(比如Google Protocol Buffers、FlatBuffers,或者自己设计一套简单的二进制协议)转换为字节流,然后在接收端再反序列化(Deserialization)回去。这样不仅解决了对齐问题,还能顺便处理字节序(Endianness)问题,让你的数据传输真正做到平台无关。
为什么C++结构体在不同平台编译后大小会不一样?
这事儿说起来,核心原因在于编译器为了优化内存访问效率,会在结构体成员之间插入一些“填充字节”(padding bytes)。你想啊,处理器访问内存通常是按照一定字长(比如4字节或8字节)来读取的,如果一个数据成员没有对齐到它大小的整数倍地址上,处理器可能就需要进行多次内存访问,或者做一些额外的位操作才能取到完整数据,这会大大降低性能。
不同的编译器、不同的操作系统、不同的处理器架构,它们对“最佳对齐”的理解和默认规则都不一样。
- 默认对齐规则: 大多数系统遵循一个基本原则:结构体中每个成员的起始地址,必须是其自身大小的整数倍(或者说是编译器默认对齐值和成员大小中的较小值的整数倍)。比如,一个
int类型通常要求4字节对齐,double可能要求8字节对齐。如果前面有个char(1字节),后面跟着一个int(4字节),那么char后面就会被填充3个字节,确保int从4字节的倍数地址开始。 - 编译器差异: GCC、Clang、MSVC这些编译器,它们各自有一套默认的对齐策略。虽然大致相似,但在细节上可能有所不同。例如,某个编译器默认对齐是8字节,而另一个是4字节,这就会直接影响到结构体的最终大小。
- 处理器架构: 32位系统和64位系统对数据类型的处理也有差异。比如,
long类型在32位系统上通常是4字节,但在64位系统上可能是8字节。这直接改变了成员的大小,进而影响了填充。即使成员大小不变,64位处理器为了效率,可能倾向于更严格的对齐(比如8字节对齐),导致更多填充。 - 结构体总大小对齐: 整个结构体的大小通常也会被填充,以确保下一个结构体实例能够正确对齐。结构体的总大小会是其最大成员对齐值的整数倍。
这些因素交织在一起,就导致了同一个C++结构体,在不同编译环境下,最终的内存布局和大小会变得不一样。这在跨平台通信或者持久化存储时,简直是个噩梦。
如何选择合适的对齐策略来确保C++结构体跨平台兼容性?
选择对齐策略,其实是在性能、内存占用和兼容性之间做权衡。没有一个“放之四海而皆准”的完美方案,得看你的具体应用场景。
如果你的目标是网络协议或文件格式,需要字节流严格一致,那么强制紧凑对齐(__attribute__((packed)) 或 #pragma pack(1))通常是首选。它确保了结构体内部没有填充,大小固定。但要注意,访问未对齐数据可能带来性能损失,在某些嵌入式系统上甚至可能引发硬件异常。所以,你可能需要在性能关键路径上避免直接访问这些打包结构体的成员,或者确保你的目标平台能够高效处理未对齐访问。我个人经验是,这种场景下,打包是必须的,但如果性能要求极高,通常还会结合手动序列化/反序列化,避免直接操作打包后的原始内存。
对于内存中的数据结构,如果不需要跨平台直接传输其原始字节流,那么通常保持编译器默认对齐是最好的选择。因为编译器会根据目标平台的特性来选择最优对齐方式,这通常能带来最佳的内存访问性能。在这种情况下,如果你只是在同一个平台的不同编译配置下遇到大小不一致,那通常是编译选项(比如对齐字节数)设置不同导致的,统一编译选项即可。
如果你的需求介于两者之间,或者你需要更细粒度的控制,C++11引入的 alignas 关键字提供了一个标准化的方式来增加对齐。你可以强制某个结构体或成员按照更大的边界对齐,这有助于在特定硬件上获得更好的性能,同时也能确保在支持 alignas 的编译器上行为一致。但它不能用于减少对齐到1字节,所以对于严格打包的需求,还是得依赖编译器特定的扩展。
我的建议是:
- 优先使用固定宽度整数类型(
int32_t,uint664_t等)。这能从根本上减少因类型大小不确定导致的差异。 - 明确对齐需求。 如果是数据传输,倾向于严格打包;如果是内存操作,倾向于默认对齐。
- 测试,测试,再测试。 在所有目标平台上进行测试,验证结构体的大小和成员偏移量是否一致。
sizeof()和offsetof()是你的好朋友。 - 考虑序列化。 这是最稳妥、最灵活的跨平台数据交换方案,虽然增加了代码复杂度和运行时开销,但从长远来看,它能省去无数的兼容性麻烦。
除了显式对齐,还有哪些方法可以避免C++结构体跨平台数据传输问题?
除了显式控制对齐,我们还有很多更通用、更健壮的方法来处理跨平台数据传输的问题。说白了,就是不要指望直接把内存里的结构体“原样”扔过去,因为不同平台对内存的理解可能完全不一样。
使用成熟的序列化库: 这是我个人最推荐的方案,尤其是在复杂的系统或需要长期维护的项目中。
- Protocol Buffers (Protobuf): Google开发的,高效、跨语言、跨平台。你定义数据结构(
.proto文件),然后编译器生成代码,帮你序列化和反序列化。它处理了对齐、字节序、甚至数据版本兼容性问题。 - FlatBuffers: 也是Google的,特点是零拷贝序列化,数据可以直接从缓冲区读取,不需要额外的解析步骤,非常适合性能敏感的场景。
- Cap'n Proto: 另一个零拷贝序列化库,号称比Protobuf更快。
- Boost.Serialization: 如果你项目已经在使用Boost,这是一个功能强大的C++专用序列化库,支持多种格式(二进制、XML等)。
- JSON/XML: 对于人类可读性要求高的场景,或者需要与其他语言轻松互操作时,JSON或XML是很好的选择。虽然它们比二进制格式占用更多空间,解析也慢一些,但在Web服务和配置管理中非常流行。
这些库的优点是它们为你抽象了底层细节,你只需要关心数据结构本身,而不用操心字节序、对齐、甚至数据版本兼容性。
- Protocol Buffers (Protobuf): Google开发的,高效、跨语言、跨平台。你定义数据结构(
手动序列化与反序列化: 如果项目规模小,或者有非常特殊的性能要求,你也可以自己动手。
- 逐字段处理: 不要一次性复制整个结构体,而是将每个字段单独写入(或读取)到字节流中。
- 处理字节序(Endianness): 这是个大坑。不同的处理器架构可能使用不同的字节序(大端序或小端序)。比如,
0x12345678在小端序机器上内存是78 56 34 12,在大端序机器上是12 34 56 78。你需要使用像htons(host to network short),ntohl(network to host long) 这样的函数来统一字节序,通常网络字节序被定义为大端序。 - 固定宽度整数类型: 前面提过,
int8_t,uint16_t这些是基础。
例如,一个简单的手动序列化可能长这样:
// 假设我们有一个结构体 struct MyData { uint32_t id; uint16_t version; // ... }; // 序列化函数 void serialize(const MyData& data, std::vector& buffer) { // 假设网络字节序是大端 uint32_t net_id = htonl(data.id); uint16_t net_version = htons(data.version); buffer.insert(buffer.end(), (char*)&net_id, (char*)&net_id + sizeof(net_id)); buffer.insert(buffer.end(), (char*)&net_version, (char*)&net_version + sizeof(net_version)); // ... 其他字段 } // 反序列化函数 void deserialize(const std::vector & buffer, MyData& data) { size_t offset = 0; uint32_t net_id; memcpy(&net_id, buffer.data() + offset, sizeof(net_id)); data.id = ntohl(net_id); offset += sizeof(net_id); uint16_t net_version; memcpy(&net_version, buffer.data() + offset, sizeof(net_version)); data.version = ntohs(net_version); offset += sizeof(net_version); // ... 其他字段 } 数据版本管理: 无论你选择哪种序列化方法,一旦数据结构发生变化,旧版本的数据可能就无法被新代码正确解析。因此,在你的协议中加入版本号是至关重要的。当接收到数据时,先检查版本号,然后根据版本号决定如何解析数据。这可能是最容易被忽视,但后期维护中最能体现价值的一个点。
总之,当你需要跨平台传输数据时,不要偷懒直接传输原始结构体。花点时间设计一个健壮的序列化/反序列化机制,无论是借助成熟库还是自己实现,都能大大提高你的代码的健壮性和可维护性。
深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
C++类构造与析构函数详解 C++这门语言,可以说是从C语言这棵大树上衍生出的高级果实,如今的应用普及度有目共睹。作为一种静态类型的通用编程语言,它厉害的地方在于融合了多种编程哲学——无论是传统的面向过程,还是主流的面向对象,乃至数据抽象、泛型编程这些高级概念,它都能很好地支持。正因为这份卓越的扩展
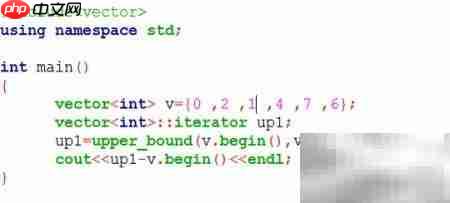
C++中std::upper_bound用法解析 在C++标准模板库(STL)的算法工具箱里,upper_bound() 绝对算得上是一把精准的“探针”。它的核心任务很明确:在一个已经排好序的区间 [first, last) 内,帮你快速定位到第一个**严格大于**指定值 value 的那个元素。这
C++中“常”概念全景解析:从对象、成员到指针与引用 在C++的世界里,“常量性”是一个强大的保障机制。它不仅仅是一个const关键字那么简单,而是构建健壮、安全程序的重要基石。今天,我们就来系统梳理一下围绕“常”的一系列概念:常成员、常对象、常指针与常引用。理解它们,是写出高质量C++代码的关键一
直接用SQLiteCAPI绑定结构体需要手动处理字段展平与顺序对齐,ORM库虽省代码但存在隐式行为风险。小项目建议原生绑定,中大型项目可搭配编译期校验使用轻量ORM。绑定std::string需传指针与长度,注意生命周期;浮点字段比较需设误差范围。
编程是编写程序指令,让设备按意图运行,常用Python、C等语言或Scratch图形化编程。学习编程能跟上科技时代,锻炼自学与解决问题能力,提升逻辑思维,代表行动力,推动事物前进。各司其职,编程者尽本分。
编程被争论是否为艺术。从定义看,编程是技能表达,但并非所有编程都是应用开发。写代码如音乐、文章,有独特风格。好代码需耐心与逻辑能力。编程是艺术,但应用开发不等同于编程艺术。
解决编程问题后的痛快、完成作品的成就感、获取知识的满足感,以及用代码实现简化生活的惊喜与踏实,这些是编程独有的乐趣,只有真正写代码的人才能体会其中的酸甜苦辣、惊喜与满足,令人回味无穷。
Scratch图形化编程以拖拽积木块方式启蒙少儿编程思维,无需记忆代码语法。通过素材库、即时反馈和社区协作,帮助孩子在创作中理解顺序执行、条件判断等核心概念,锻炼逻辑、创造力和问题解决能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



