

Python字典遍历方法全解析
答案是使用.items()方法可同时获取键和值,最推荐遍历字典键值对的方式。直接forkeyindict遍历键最简洁,.values()适用于仅需值的场景,Python3.7+字典保持插入顺序,遍历时不应修改原字典,建议用字典推导式或遍历副本来安全操作,避免将视图对象转为列表以提升性能。
答案是使用 .items() 方法可同时获取键和值,最推荐遍历字典键值对的方式。直接 for key in dict 遍历键最简洁,.values() 适用于仅需值的场景,Python 3.7+ 字典保持插入顺序,遍历时不应修改原字典,建议用字典推导式或遍历副本来安全操作,避免将视图对象转为列表以提升性能。
Python遍历字典,通常指的是逐个访问字典中的键、值,或者同时访问键值对。最直接的方式是迭代字典本身(默认遍历键),或者显式地使用.keys()、.values()、.items()方法来获取你想要遍历的部分。
解决方案
当我第一次接触Python字典遍历时,也曾纠结于到底用哪种方式最好。其实没有绝对的“最好”,只有最适合当前场景的。
遍历键 (默认行为或使用
.keys()): 这是最常见的,也是字典对象本身迭代时的默认行为。如果你只需要键来做一些判断或者作为其他操作的索引,这非常方便。my_dict = {'apple': 1, 'banana': 2, 'cherry': 3} # 方式一:直接遍历字典(默认遍历键) print("--- 遍历键 (直接遍历) ---") for key in my_dict: print(f"键: {key}") # 方式二:使用 .keys() 方法 print("\n--- 遍历键 (使用 .keys()) ---") for key in my_dict.keys(): print(f"键: {key}")个人感觉,直接
for key in my_dict:更简洁,也更符合Python的“禅意”。.keys()看起来更明确一点,但功能上是等价的。遍历值 (使用
.values()): 如果你只关心字典里存储的数据,而键对你来说不重要,那么.values()方法就是你的首选。print("\n--- 遍历值 (使用 .values()) ---") for value in my_dict.values(): print(f"值: {value}")这在统计、聚合数据时特别有用,比如计算所有值的总和。
遍历键值对 (使用
.items()): 这大概是我在日常工作中用得最多的方式了。当一个操作需要同时知道键和它对应的值时,.items()是不二之选。它返回一个由(key, value)元组组成的视图。print("\n--- 遍历键值对 (使用 .items()) ---") for key, value in my_dict.items(): print(f"键: {key}, 值: {value}")这种多重赋值(unpacking)的方式,让代码读起来非常直观。
Python字典遍历时如何同时获取键和值?
这个问题,其实上面“解决方案”里已经提到了,但既然是用户可能关心的,那我们再深入聊聊。最标准、最Pythonic的做法,无疑是使用 dict.items() 方法。
data = {'name': 'Alice', 'age': 30, 'city': 'New York'}

# 推荐方式:使用 .items()
print("--- 使用 .items() 获取键和值 ---")
for k, v in data.items():
    print(f"属性: {k}, 对应值: {v}")
这种方式效率很高,因为它避免了在循环内部通过键去查找值,减少了一次哈希查找的开销。我见过一些新手朋友,可能会先遍历键,然后在循环体里用 data[key] 去取值。
# 不太推荐的方式(效率稍低,但在某些特定场景下也可用)
print("\n--- 不太推荐的方式(先遍历键,再取值)---")
for k in data: # 遍历键
    v = data[k] # 根据键获取值
print(f"属性: {k}, 对应值: {v}")虽然这两种方式结果一样,但从性能角度看,尤其是在字典很大的时候,data.items() 会更优。因为它一次性提供了键值对,避免了重复的字典查找操作。而且,代码也更简洁明了,一眼就能看出你在处理键和值。
Python字典遍历的顺序是固定的吗?
这是一个非常好的问题,因为它涉及到Python版本演进中的一个重要变化。在Python 3.7及更高版本中,字典的遍历顺序是插入顺序。也就是说,你插入键值对的顺序,就是你遍历它们时得到的顺序。这在Python 3.6中是实现细节,但在3.7中被正式纳入语言规范。
在此之前(Python 3.6及更早,特别是Python 2),字典是无序的。这意味着你不能依赖遍历字典时键值对出现的顺序。每次运行程序,或者每次重新构建字典,遍历顺序都可能不同。这在调试时会让人头疼,因为你不能指望一个稳定的输出。
# Python 3.7+ 的行为
my_ordered_dict = {'first': 1, 'second': 2, 'third': 3}
print("\n--- Python 3.7+ 字典遍历顺序 ---")
for k, v in my_ordered_dict.items():
    print(f"{k}: {v}")

# 尝试改变插入顺序
my_ordered_dict_2 = {'third': 3, 'first': 1, 'second': 2}
print("\n--- 改变插入顺序后的遍历 ---")
for k, v in my_ordered_dict_2.items():
    print(f"{k}: {v}")
可以看到,输出的顺序和插入的顺序是完全一致的。这个特性对于需要保持数据顺序的场景非常有用,比如解析JSON配置文件,或者构建一些需要有序处理的结构。如果你需要一个总是按照特定顺序(比如字母顺序)遍历的字典,你就需要在遍历前对键进行排序,例如 for k in sorted(my_dict.keys()):。但对于大多数日常使用,Python 3.7+ 的默认行为已经足够好,并且非常方便。
Python字典遍历的最佳实践和常见误区?
聊到最佳实践和误区,我觉得有几点是值得拎出来反复强调的。
最佳实践:
优先使用
.items()进行键值对遍历: 如前所述,这不仅效率高,代码也更清晰。避免在遍历时修改字典(除非你真的知道自己在做什么): 这是一个非常常见的陷阱。当你正在遍历一个集合时,如果同时修改它(添加、删除元素),Python的迭代器可能会失效,导致
RuntimeError: dictionary changed size during iteration。 如果你确实需要在遍历过程中修改字典,一个安全的做法是遍历字典的副本,或者先收集需要修改的键,然后在循环结束后再进行修改。# 错误示例(会报错或行为异常) # for k, v in my_dict.items(): # if v == 2: # del my_dict[k] # 运行时会报错 # 安全的做法:遍历副本或收集键 original_dict = {'a': 1, 'b': 2, 'c': 3, 'd': 4} keys_to_delete = [] for k, v in original_dict.items(): if v % 2 == 0: keys_to_delete.append(k) for k in keys_to_delete: del original_dict[k] print(f"\n--- 安全修改后的字典: {original_dict} ---")或者使用字典推导式(Dictionary Comprehension)来创建一个新的字典,这通常是更简洁、更Pythonic的方式。
original_dict = {'a': 1, 'b': 2, 'c': 3, 'd': 4}
new_dict = {k: v for k, v in original_dict.items() if v % 2 != 0}
print(f"--- 使用字典推导式创建新字典: {new_dict} ---")
考虑字典视图对象的特性:
keys(),values(),items()返回的都是字典视图(dict views)。这些视图是动态的,它们反映了字典的最新状态。这意味着如果你在获取视图后修改了字典,视图也会随之更新。这既是优点,也可能是一个需要注意的地方。
常见误区:
- 假设Python 2的无序特性: 很多从Python 2转过来的开发者,或者不了解新版本特性的,可能会错误地认为字典遍历是无序的。虽然为了代码的健壮性,不依赖顺序总是好的,但在Python 3.7+ 中,你确实可以信赖插入顺序。
- 过度使用
dict.get()或in操作符来检查键是否存在: 虽然dict.get()在取值时提供默认值很方便,in检查键是否存在也很常见。但在遍历时,如果已经通过items()获取了键值对,就没必要再做额外的键存在性检查了。 - 对大型字典进行不必要的列表转换: 例如
list(my_dict.keys())。除非你确实需要一个键的列表副本进行其他操作(比如排序后修改),否则直接迭代视图对象通常更高效,因为它避免了创建整个列表的内存开销。视图对象是迭代器,它们按需提供元素。
总的来说,理解不同遍历方式的特点和它们背后的Python机制,能帮助我们写出更高效、更健壮、更符合Python风格的代码。我个人在遇到性能瓶颈或者需要处理复杂字典逻辑时,会反复思考这些细节,因为一个小小的选择,有时就能带来很大的不同。
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
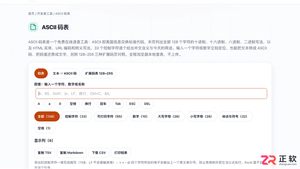
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。
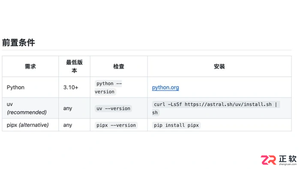
面向需要在本地部署Graphify工具的开发人员,本文详解基于Python 3.10+环境的安装流程。针对用户常遇到的依赖冲突问题,推荐使用uv或pipx创建独立运行环境。内容涵盖graphifyy官方包的安装验证、CLI命令可用性检查,以及针对Claude Code等编码助手的技能注册步骤,帮助读者快速完成从环境准备到功能集成的全过程。
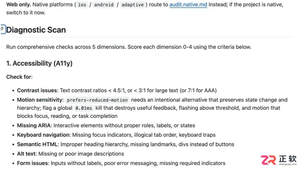
面向需要优化前端界面的开发者,Impeccable借助AI编程助手辅助改进具体页面。它常用于评审页面技术质量、调整移动端与桌面端布局,以及简化复杂界面以降低认知负荷。使用时需针对不同目标选择专用命令,如audit用于检查问题,adapt用于设备适配,distill用于精简内容。本文介绍如何通过明确指令聚焦单一任务,避免一次性重构整个项目,并在修改后通过实际业务流程验证功能完整性。
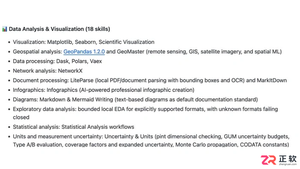
面向需要使用AI辅助科研工作的用户,Scientific Agent Skills通过封装常用工具的操作规范,帮助AI Agent完成数据整理、统计分析、科学绘图及专业研究工作流。针对科研中工具调用复杂、流程断层的痛点,本文介绍其核心能力:串联Polars等库进行数据检查与清洗;利用statistical-analysis技能指导组间比较、回归分析及结果报告规范;以及执行如scanpy单细胞测序等专业领域分析流程。注意实际效果取决于所选技能、依赖环境及数据条件,关键结论仍需人工核对。
面向需要区分DeepSeek交互模式的用户,本文对比DeepSeek SuperAgent原型与网页聊天的核心差异。网页聊天提供即时问答入口,适合临时咨询;SuperAgent围绕代码仓库接收事件、判断授权并管理工单,需部署Harness及运行主机。文章从工作流程、权限机制及协作方式解析两者定位,帮助用户根据是否需持续跟进Issue或交付PR选择合适工具,避免混淆模型等级与功能边界。
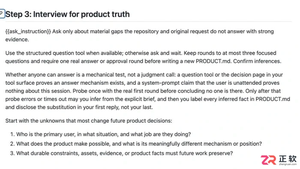
面向使用AI编程助手进行前端开发的用户,介绍Impeccable工具在维护产品一致性与视觉规范中的工作流。针对开发中容易忽视的设计细节与上下文缺失问题,本文详解如何通过/impeccable init建立产品上下文,利用/impeccable document记录DESIGN.md视觉规则,并通过critique和polish命令评审与优化特定页面。同时涵盖终端命令行检测npx impeccable detect的使用场景,帮助开发者在限定范围内高效完成代码修改与流程验证。
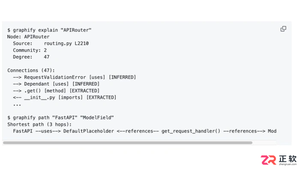
面向需要快速上手陌生项目的开发者,Graphify通过构建代码与文档的知识图谱,帮助理清函数调用关系及模块依赖。它能将代码结构与设计文档、PDF等多模态资料整合,为AI编码助手提供精准的项目上下文。本文介绍如何使用explain和path命令追踪调用路径,处理不同格式的输入文件,以及根据任务需求选择查询、更新或导出HTML、JSON等格式,从而高效定位线索并核查影响范围。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



