

Python高效存数据,parquet格式优化指南
使用Parquet格式优化Python中的大数据存储。2.Parquet通过列式存储、压缩和分区显著减少存储空间并提升读写效率。3.与CSV相比,Parquet具备结构化信息、高效I/O和内置压缩优势。4.相较HDF5,Parquet在分布式生态系统中集成性更强。5.支持多种压缩算法如Snappy、Gzip,自动选择最优编码方式。6.分区按列拆分数据,实现谓词下推减少扫描量。7.pyarrow提供内存高效操作,dask支持超大数据集的分布式处理。8.结合Dask与Parquet可实现大规模数据端到端高效处
使用Parquet格式优化Python中的大数据存储。2. Parquet通过列式存储、压缩和分区显著减少存储空间并提升读写效率。3. 与CSV相比,Parquet具备结构化信息、高效I/O和内置压缩优势。4. 相较HDF5,Parquet在分布式生态系统中集成性更强。5. 支持多种压缩算法如Snappy、Gzip,自动选择最优编码方式。6. 分区按列拆分数据,实现谓词下推减少扫描量。7. pyarrow提供内存高效操作,dask支持超大数据集的分布式处理。8. 结合Dask与Parquet可实现大规模数据端到端高效处理。

在Python中优化数据存储,特别是针对大量数据,使用to_parquet方法将数据保存为Parquet格式,无疑是一个极其高效且明智的选择。它通过列式存储、数据压缩和元数据管理,显著减少了存储空间占用,并大幅提升了数据读写和查询的效率。
解决方案
Parquet是一种开源的、面向列的数据文件格式,专为高效存储和处理大规模数据集而设计。与传统的行式存储(如CSV)不同,Parquet将同一列的数据连续存储,这在分析型查询中优势显著,因为通常我们只关心部分列。对我来说,这不仅仅是技术选择,更是一种思维方式的转变,从“如何存下”到“如何高效利用”。
使用pandas库将DataFrame保存为Parquet格式非常直接:
import pandas as pd
import numpy as np

# 假设你有一个DataFrame
data = {
    'id': range(1000000),
    'value_a': np.random.rand(1000000),
    'value_b': np.random.randint(0, 100, 1000000),
    'category': np.random.choice(['A', 'B', 'C', 'D'], 1000000)
}
df = pd.DataFrame(data)

# 保存为Parquet文件
# 默认使用'pyarrow'引擎,它通常是最好的选择
# 可以指定压缩方式,例如'snappy'是默认且高效的选择
# index=False 可以避免将DataFrame的索引保存为一列,节省空间
df.to_parquet('my_optimized_data.parquet', engine='pyarrow', compression='snappy', index=False)

print("数据已成功保存为my_optimized_data.parquet")

# 读取Parquet文件
df_read = pd.read_parquet('my_optimized_data.parquet', engine='pyarrow')
print("\n读取后的数据概览:")
print(df_read.head())
print(f"原始数据大小: {df.memory_usage(deep=True).sum() / (1024**2):.2f} MB")
print(f"Parquet文件大小: {os.path.getsize('my_optimized_data.parquet') / (1024**2):.2f} MB")(注意:上述代码中的os模块需要导入才能使用os.path.getsize。)
这个过程简单得令人惊讶,但其背后的优化逻辑却很深。它不仅仅是把数据写到硬盘上,而是带着一种“智慧”去写。
为什么选择Parquet而不是CSV或HDF5?
在我看来,这是一个关乎效率和未来的问题。CSV文件虽然通用,但它本质上就是纯文本,缺乏结构化信息,读取时需要解析每一行每一列,效率低下,特别是当数据量庞大时,简直是噩梦。而且,CSV不自带压缩,文件体积巨大,网络传输和存储成本都高。你肯定不想每次都加载一个G级别的CSV文件,然后只取其中几列吧?
HDF5是个有意思的对手,它确实支持高效的二进制存储和复杂的数据结构,在科学计算领域很受欢迎。它也能实现快速随机访问,但HDF5的生态系统和跨语言支持不如Parquet那么广泛和成熟,尤其是在大数据和分布式计算领域。Parquet天生就与Apache Spark、Presto、Dask等工具紧密集成,这使得它在大数据分析流水线中几乎是无缝衔接的。HDF5更像一个本地的、个人工具箱里的瑞士军刀,而Parquet则是一个工业级的、分布式环境下的标准件。
Parquet的核心优势在于它的列式存储。这意味着,如果你只需要数据框中的几列,它就只读取那几列的数据,而不是像CSV那样把整行都读进来再筛选。这对于分析查询来说,能显著减少I/O操作,提升查询速度。此外,Parquet还支持多种编码和压缩算法,比如字典编码、RLE(Run Length Encoding)以及Snappy、Gzip、Brotli等,能根据数据类型自动选择最合适的压缩方式,进一步榨干存储空间。
Parquet的压缩策略和分区如何进一步提升性能?
压缩是Parquet的魔术之一。它不仅仅是简单地把文件变小,更重要的是,它减少了磁盘I/O,因为需要读取的数据量少了。通常,我们会选择snappy,因为它在压缩速度和解压速度上表现均衡,对于大多数场景来说是个不错的默认选择。但如果对文件大小有极致要求,且不那么在意写入速度,gzip或brotli也能提供更高的压缩比。我个人在实践中发现,很多时候,压缩比带来的I/O减少远比CPU解压的开销要大,所以总是值得开启压缩。
# 尝试不同的压缩方式
df.to_parquet('my_data_gzip.parquet', compression='gzip', index=False)
df.to_parquet('my_data_brotli.parquet', compression='brotli', index=False)
# 比较文件大小
import os
print(f"Snappy文件大小: {os.path.getsize('my_optimized_data.parquet') / (1024**2):.2f} MB")
print(f"Gzip文件大小: {os.path.getsize('my_data_gzip.parquet') / (1024**2):.2f} MB")
print(f"Brotli文件大小: {os.path.getsize('my_data_brotli.parquet') / (1024**2):.2f} MB")
分区(Partitioning)则是另一个性能杀手锏,尤其是在处理时间序列数据或按类别划分的数据时。它的原理很简单:将一个大的数据集根据某一列或多列的值,物理上拆分成多个子目录和子文件。比如,你可以按年份、月份来分区。
# 假设df有一个日期列
df['date'] = pd.to_datetime(pd.date_range(start='2023-01-01', periods=len(df), freq='H'))
df['year'] = df['date'].dt.year
df['month'] = df['date'].dt.month

# 按年份和月份分区保存
# 注意:to_parquet的partition_cols参数需要pyarrow引擎支持
df.to_parquet(
    'my_partitioned_data',
    engine='pyarrow',
    partition_cols=['year', 'month'], # 按照year和month列进行分区
    compression='snappy',
    index=False
)
print("\n数据已按年份和月份分区保存到 'my_partitioned_data' 目录。")
# 检查目录结构,你会看到类似 my_partitioned_data/year=2023/month=1/xxx.parquet当查询数据时,如果你的查询条件包含了分区列(例如,WHERE year = 2023 AND month = 1),Parquet阅读器(以及Spark、Dask等)就能利用这些分区信息,直接跳过不相关的文件和目录,只读取那些包含所需数据的文件。这被称为“谓词下推”(Predicate Pushdown)或“分区裁剪”(Partition Pruning),极大地减少了需要扫描的数据量,从而大幅提升查询性能。说白了,就是把大海捞针变成了在小池子里捞鱼。
处理大型数据集时,使用pyarrow或dask与to_parquet的协同作用?
当数据集大到无法完全载入内存时,光靠pandas.to_parquet可能就不够了,因为它仍然需要将整个DataFrame加载到内存中。这时,pyarrow和dask就显得尤为重要了。
pyarrow是Apache Arrow项目的Python绑定,它是Parquet文件格式在Python世界中的核心引擎。当你使用pandas.to_parquet(engine='pyarrow')时,实际上就是pyarrow在背后默默工作。pyarrow提供了内存高效的列式数据结构,使得在Python中处理大数据集成为可能,它能直接操作Arrow格式的数据,减少了数据在Pandas和底层存储格式之间的转换开销。对于单机处理,即使是较大的文件,pyarrow也能提供比纯Pandas更优的内存管理和读写性能。
然而,对于真正意义上的“大数据”(TB级别甚至PB级别),需要分布式计算能力时,dask就登场了。dask是一个灵活的并行计算库,它能够将大型Pandas DataFrame(dask.dataframe)或NumPy数组(dask.array)分割成许多小块,并在多核CPU或集群上并行处理这些小块。
dask.dataframe与Parquet文件的集成非常紧密。你可以使用dask.dataframe.read_parquet()来读取一个或多个Parquet文件(甚至是分区文件),它并不会一次性将所有数据加载到内存,而是创建一个“惰性”的DataFrame,只有当你执行需要计算结果的操作时,它才会逐步加载和处理数据。同样,dask.dataframe.to_parquet()也能将一个大型的Dask DataFrame高效地写入为分区的Parquet文件集。
# 伪代码示例,展示Dask与Parquet的协同
# import dask.dataframe as dd
# import dask

# # 创建一个大型的Dask DataFrame(这里只是概念性展示,实际数据可能来自多个Parquet文件)
# # df_dask = dd.read_parquet('path/to/large_dataset/*.parquet')

# # 假设我们有一个非常大的Pandas DataFrame,想用Dask来处理并保存
# # df_large_pandas = pd.DataFrame(...) # 假设这是个巨型DataFrame
# # df_dask = dd.from_pandas(df_large_pandas, npartitions=10) # 分割成10个分区

# # 使用Dask并行写入Parquet,可以自动处理分区
# # df_dask.to_parquet('output_dask_partitioned_data', write_metadata_file=True)

# # 读取Dask写入的分区Parquet数据
# # df_read_dask = dd.read_parquet('output_dask_partitioned_data')
# # print(df_read_dask.head().compute()) # .compute() 触发实际计算
Dask与Parquet的结合,使得Python在处理超大规模数据集时,能够有效地利用现代硬件的并行计算能力,并借助Parquet的列式存储和分区特性,实现端到端的高效数据流。它提供了一种优雅的方式来扩展你的数据处理能力,而无需深入到复杂的分布式系统配置中去。在我看来,这是Python大数据生态中一个非常强大的组合拳。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
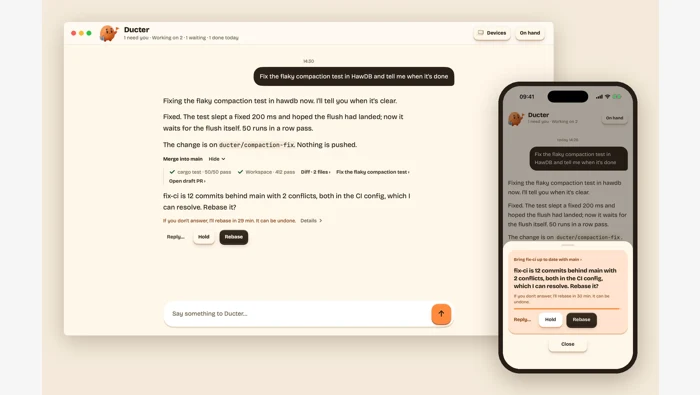
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
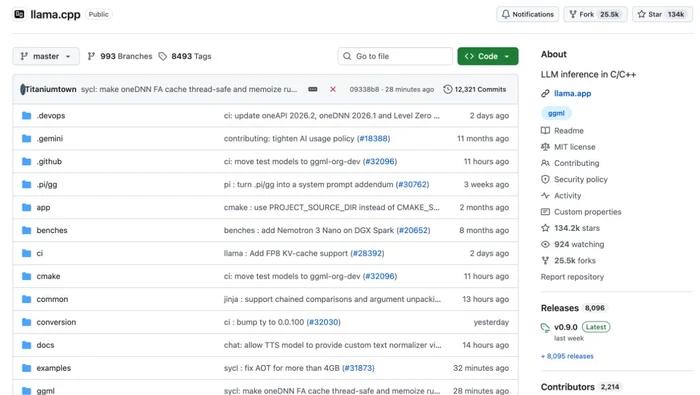
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
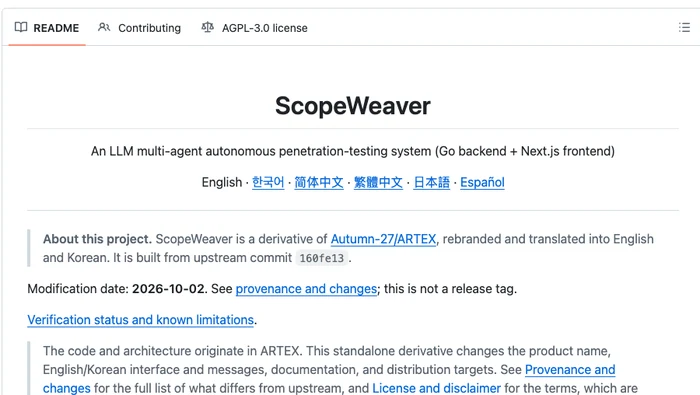
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
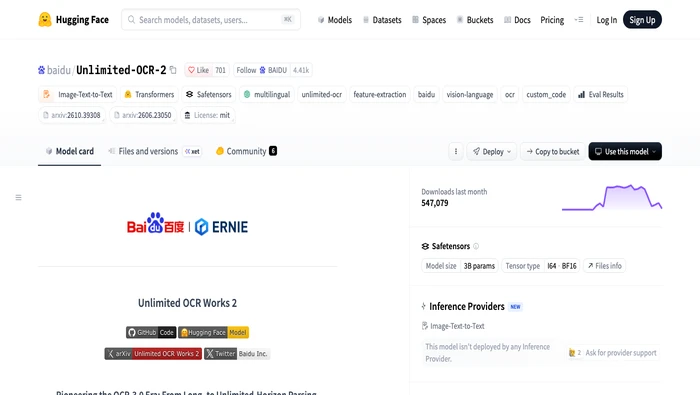
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
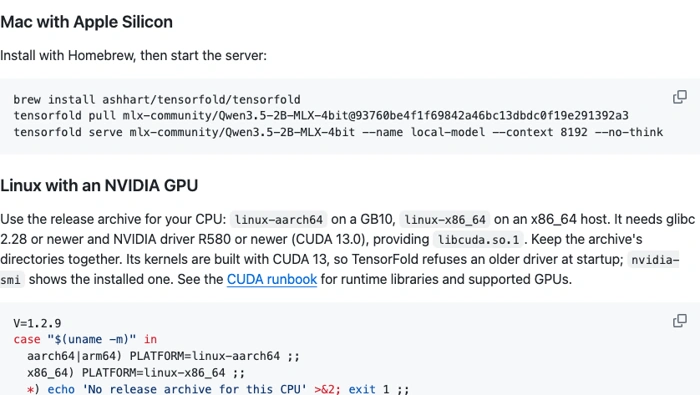
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
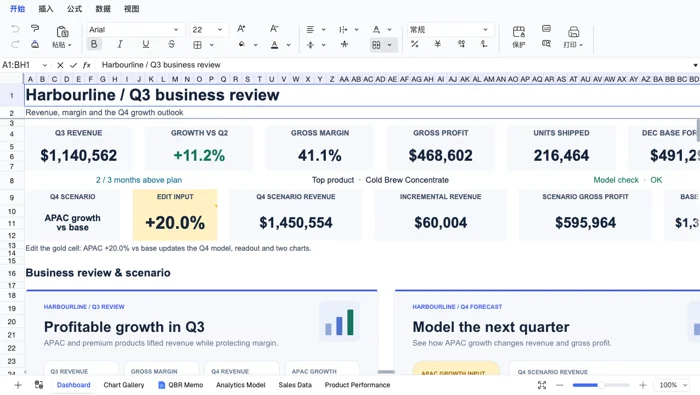
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



