

pandas的数据格式怎么转换和设置方法教程
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。
Pandas 读取数据时默认依赖推断机制,这往往导致整数列被读作浮点数,或长文本占用过多内存。类型不匹配不仅是显示问题,更是后续计算报错和内存溢出的根源。理解转换机制而非机械调用函数,是构建稳定数据管道的第一步。
为什么自动推断会失效
Pandas 的 read_csv 或 DataFrame 构造函数在初始化时会扫描前几行数据以猜测类型。如果某列包含缺失值 NaN,Pandas 通常会将整数列升级为 float64,因为原生 NumPy 整数类型不支持空值。此外,混合了数字和特殊字符(如 "1,000" 或 "N/A")的列会被直接判定为 object 字符串类型。
这种隐式转换在数据量较小时不可见,但在大规模聚合或连接操作时,object 类型会导致向量化操作失效,迫使 Pandas 退化为缓慢的逐行循环。更严重的是,浮点数精度问题可能在金额计算中引入微小误差,最终影响业务报表的准确性。
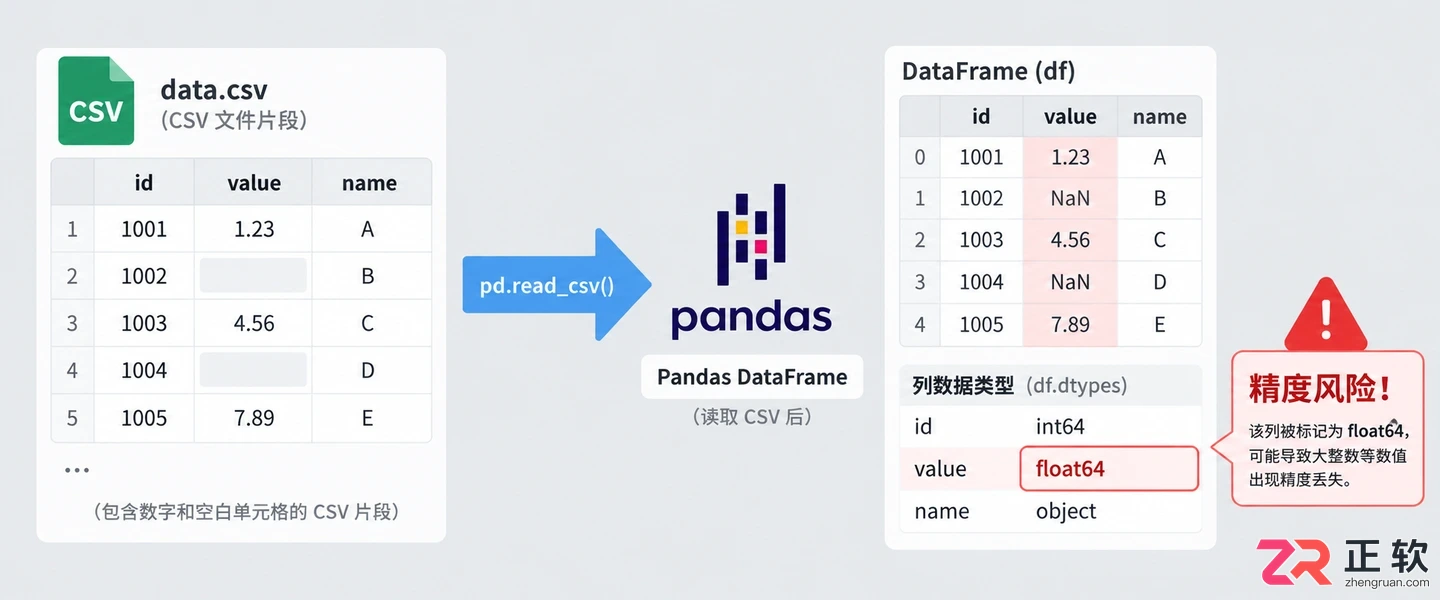
自动推断机制将含空值的整数列误判为浮点型
核心转换方法的因果逻辑
修正类型不能仅靠 astype 一把梭,需根据数据脏污程度选择策略。
1. 使用 astype 进行强制映射
当数据干净且目标类型明确时,astype 是最直接的工具。它执行严格的类型转换,遇到无法解析的值会直接抛出异常。
import pandas as pd

df = pd.DataFrame({'id': ['1', '2', '3'], 'score': ['90', '85', '88']})

# 正确用法:确保所有值均可转换
df['id'] = df['id'].astype(int)
df['score'] = df['score'].astype(float)

print(df.dtypes)
输出结果显示 id 变为 int64,score 变为 float64。若数据中存在空字符串或非数字字符,此步骤将中断执行。因此,astype 适用于清洗后的数据或已知规范的输入源。
2. 使用 to_numeric 处理脏数据
对于可能包含噪声的数值列,pd.to_numeric 提供了 errors 参数来控制行为。设置为 'coerce' 时,无法解析的值会被转换为 NaN,而不是报错。
raw_data = pd.Series(['100', '200', 'error', '300'])

# 将不可转换值设为 NaN
clean_data = pd.to_numeric(raw_data, errors='coerce')

print(clean_data)
输出中 "error" 变为 NaN,其余保持数值类型。这一步是数据清洗的关键环节,它允许我们在转换过程中识别并隔离异常值,随后再决定是填充还是删除。
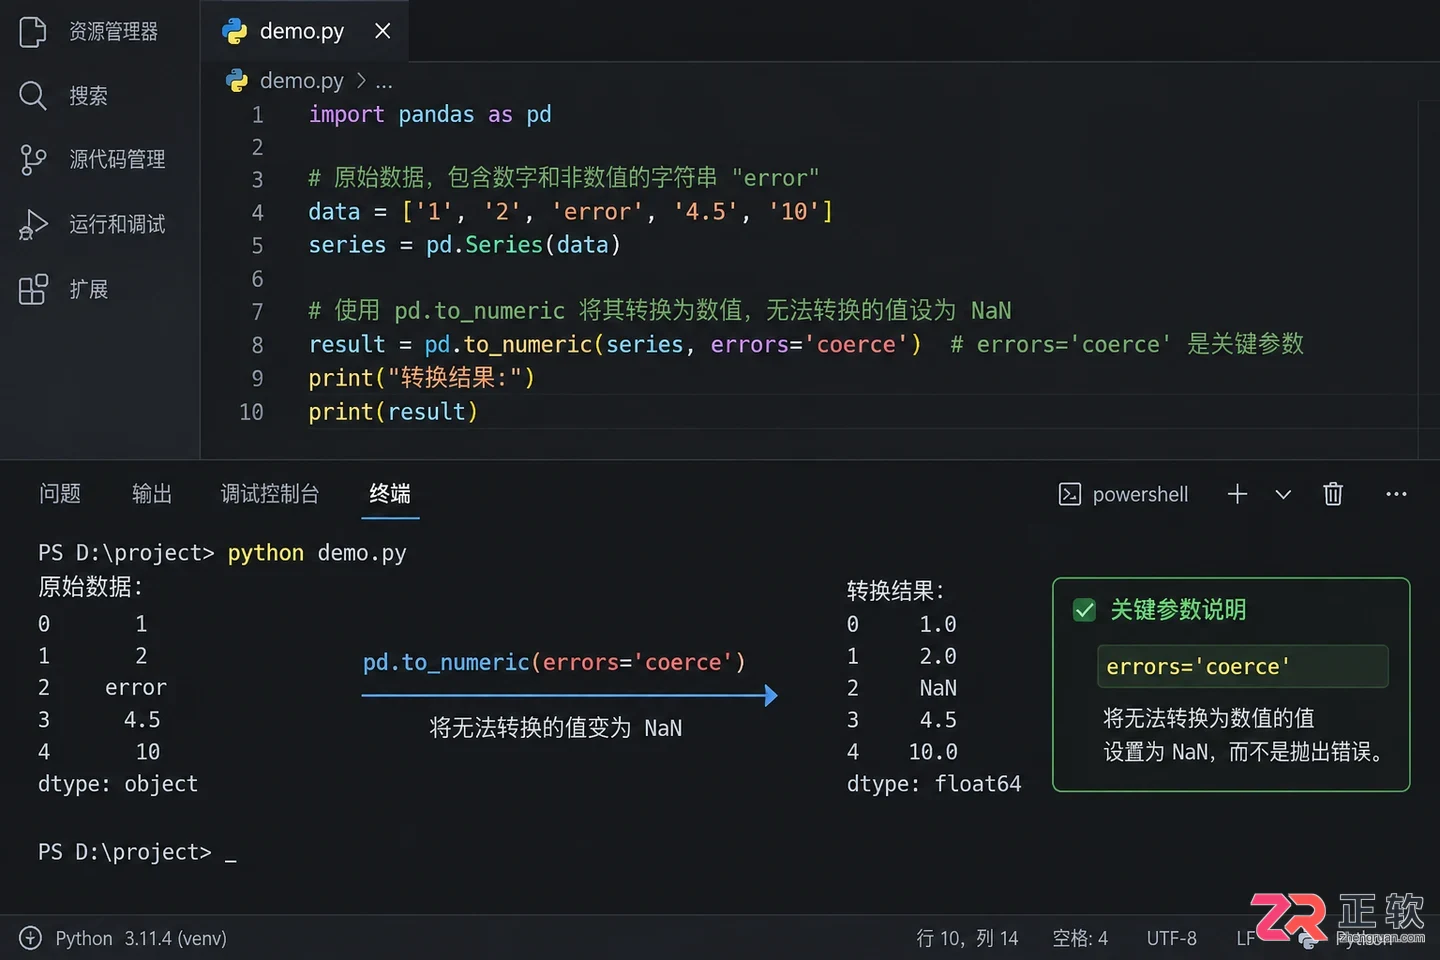
使用errors='coerce'将非法值转换为NaN
3. 使用 convert_dtypes 优化内存
Pandas 1.0+ 引入了 nullable 数据类型(如 Int64, string)。convert_dtypes() 方法能自动将列转换为这些新类型,它们原生支持缺失值,无需将整数升级为浮点数。
df_mixed = pd.DataFrame({'a': [1, 2, None], 'b': ['x', 'y', 'z']})

df_optimized = df_mixed.convert_dtypes()

print(df_optimized.dtypes)
输出显示列 a 变为 Int64(注意大写 I),列 b 变为 string。这不仅保留了整数语义,还显著降低了内存占用,特别是在处理大量分类文本时。
特定场景的精准控制
通用转换之外,日期和分类数据需要专门的解析逻辑。
1. 日期时间的解析陷阱
不要手动分割字符串来构建日期。使用 pd.to_datetime 并指定 format 参数可以大幅提升解析速度并避免歧义。
dates = pd.Series(['2023-01-01', '2023-02-15'])

# 指定格式加速解析
dt_series = pd.to_datetime(dates, format='%Y-%m-%d')
若日期格式复杂或不统一,可省略 format,但需接受性能损耗。解析后的 datetime64 类型支持直接提取年、月、日等属性,这是字符串类型无法做到的。
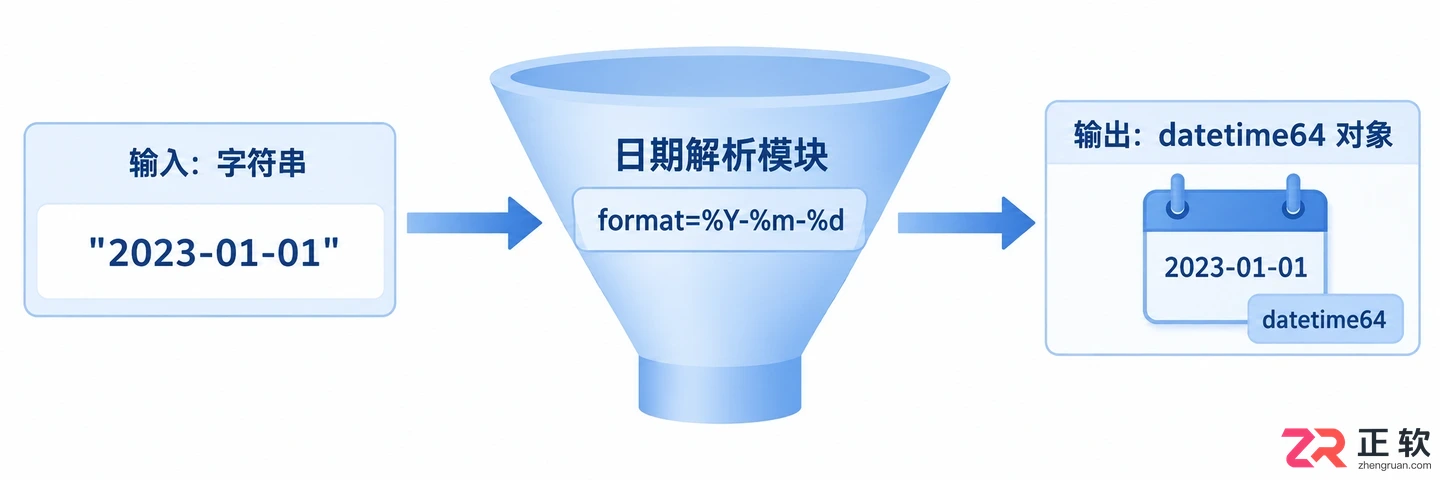
指定format参数提升日期解析效率
2. 分类数据的内存压缩
对于基数较低(唯一值较少)的字符串列,转换为 category 类型可将内存占用降低一个数量级。
gender = pd.Series(['Male', 'Female', 'Male', 'Female'] * 1000)

gender_cat = gender.astype('category')

print(f"原始内存: {gender.memory_usage(deep=True)} bytes")
print(f"分类内存: {gender_cat.memory_usage(deep=True)} bytes")
输出对比会显示显著的内存节省。但需注意,分类类型不适合高基数列(如用户 ID),因为其内部字典维护成本可能超过节省的空间。
何时停止转换
并非所有列都需要严格类型化。如果某列仅用于展示或作为唯一标识符(如 UUID),保持 object 或 string 类型即可。过度优化类型会增加代码复杂度,且在频繁修改数据时可能带来类型冲突的维护成本。
数据类型的选择本质上是内存、计算速度与开发便利性之间的权衡。在 ETL 流程的入口阶段完成一次性转换,并在后续操作中保持类型稳定,是避免隐性 Bug 的最佳实践。
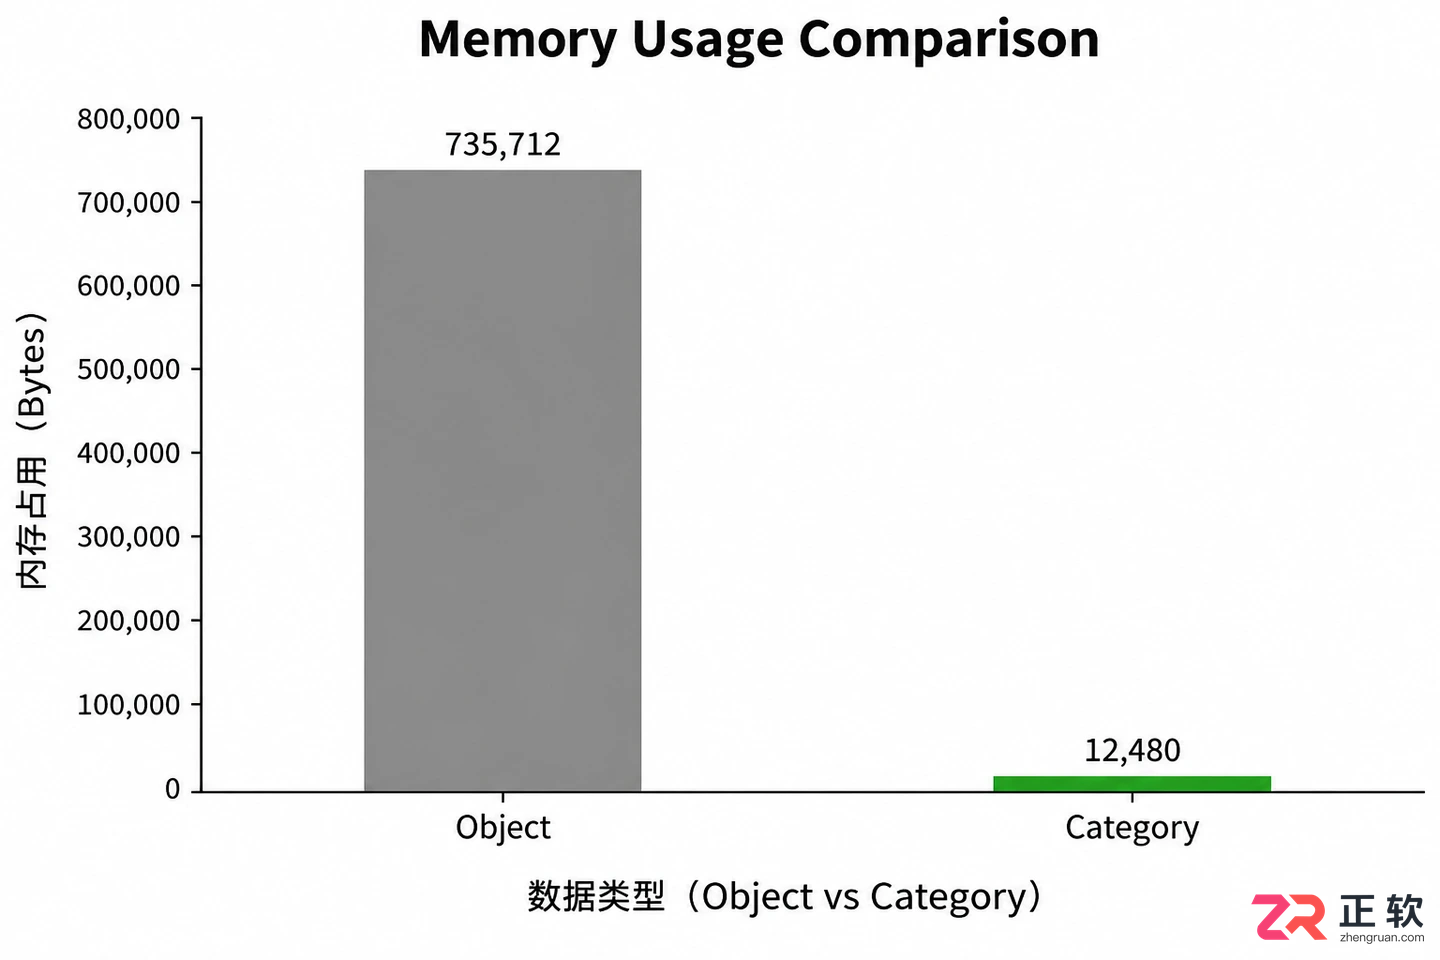
category类型显著降低高重复字符串列的内存占用
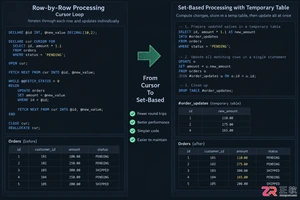
开发者常因游标逐行处理导致SQL执行缓慢。本文详解如何使用集合操作(UPDATE FROM)、临时表批量JOIN以及按主键范围分批处理来替代游标。涵盖NULL值处理、索引优化及事务一致性检查,提供可落地的代码案例与验证方法。

深入解析SQL游标导致的死锁与资源未释放问题。通过PostgreSQL与MySQL语法对比,展示如何识别长事务持锁、分析锁等待链,并提供短事务提交、异常清理及批量处理的最佳实践,确保数据库连接与锁资源及时释放。
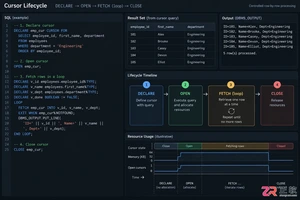
深入解析SQL游标的工作机制,包括DECLARE、OPEN、FETCH、CLOSE完整生命周期。通过代码示例说明何时使用游标处理逐行逻辑,对比集合操作的优劣,强调资源释放的重要性,为开发者提供清晰的适用边界判断标准。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。
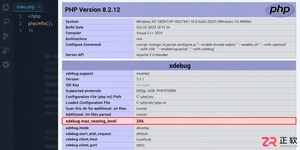
遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。
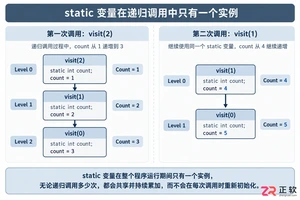
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
解决3ds Max在处理含有大量修改器的复杂场景时出现的视口卡顿问题。本教程指导用户如何定位高负载修改器,正确启用缓存功能,以及通过冻结对象和临时折叠堆栈来优化操作体验,同时确保数据安全性。
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。

详解 python pandas安装 的完整步骤,包括使用 venv 创建隔离环境、通过 pip 安装依赖及验证导入成功。提供决策图辅助排错,适用于后端开发环境搭建。

详解 python 安装pandas 的正确姿势,包括使用 venv 隔离环境、通过 python -m pip 安装依赖、验证安装结果及处理常见报错,帮助开发者构建稳定的数据处理环境。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



