

python处理csv文件的方法完整实用教程
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
处理CSV文件时,最核心的判断依据是数据规模与处理复杂度。对于小于100MB且逻辑简单的文件,Python内置的csv模块足以胜任,它轻量且无依赖;而对于需要复杂清洗、聚合或超过内存限制的大文件,pandas库则是工业级标准,但需警惕其默认行为带来的隐式类型转换陷阱。不要盲目追求Pandas的强大功能而忽略IO开销,也不要因畏惧依赖而重复造轮子处理复杂逻辑。
为什么直接open读取会乱码或错位
许多初学者直接使用open()配合split(',')来解析CSV,这在字段内容包含逗号或换行符时会立即失效。更常见的问题是编码不匹配导致的UnicodeDecodeError。
CSV本质是纯文本,但不同操作系统生成的文件编码各异。Windows Excel默认保存为GBK或CP936,而Linux和macOS多为UTF-8。当Python以默认的UTF-8尝试读取GBK文件时,遇到高位字节就会抛出异常。
# 错误示范:假设文件是GBK编码,但用UTF-8读取
try:
    with open('data.csv', 'r', encoding='utf-8') as f:
        reader = csv.reader(f)
        for row in reader:
            print(row)
except UnicodeDecodeError as e:
    print(f"解码失败: {e}")
此外,CSV规范允许字段被双引号包裹,以容纳分隔符。简单的字符串分割无法识别这种结构,导致列数错乱。必须使用遵循RFC 4180标准的解析器,如csv模块或pandas,它们能正确状态机式地处理引号和转义字符。
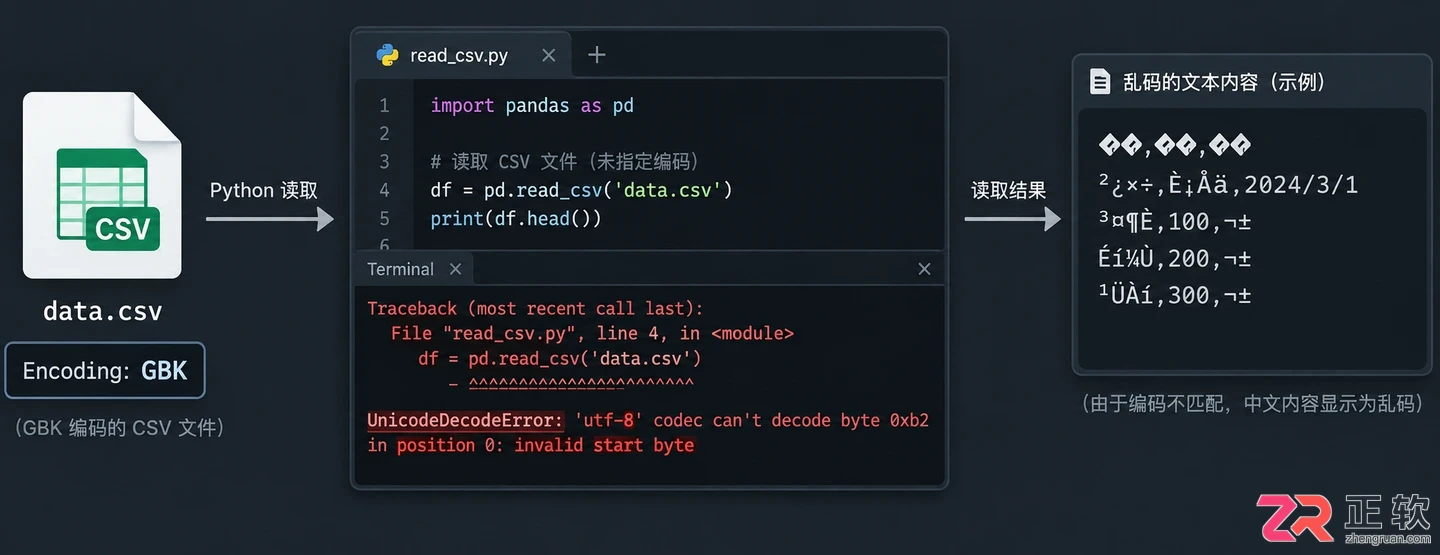
不同编码导致的乱码与解析错误对比
csv模块的标准用法与局限
csv模块是Python标准库的一部分,无需安装。它采用迭代器模式,内存占用极低,适合流式处理。
1. 正确读取带表头的文件
使用csv.DictReader可以将每一行映射为字典,键为表头名称。这比使用索引访问更具可读性,且对列顺序变化不敏感。
import csv

with open('sales.csv', 'r', encoding='utf-8-sig') as f:
    # utf-8-sig能自动处理BOM头,兼容Excel导出的UTF-8文件
    reader = csv.DictReader(f)
    for row in reader:
        # row是一个字典,例如 {'Date': '2023-01-01', 'Amount': '100'}
        print(row['Date'], row['Amount'])
注意encoding='utf-8-sig'的使用。如果文件带有BOM(Byte Order Mark),普通的utf-8会在第一列列名前留下不可见字符,导致row['Date']查找失败。
2. 写入数据的注意事项
写入时必须指定newline='',否则在Windows上会产生额外的空行。这是因为csv模块内部已处理换行符,而Python的文本模式在Windows下会将\n转换为\r\n,造成双重换行。
import csv

headers = ['Name', 'Age', 'City']
data = [
    ['Alice', 30, 'New York'],
    ['Bob', 25, 'London']
]

with open('output.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerow(headers)
    writer.writerows(data)
csv模块的局限在于它只处理字符串。 所有读取到的数字、日期都是字符串类型,需要手动转换。对于大规模数值计算,这种手动转换不仅繁琐,而且效率低下。
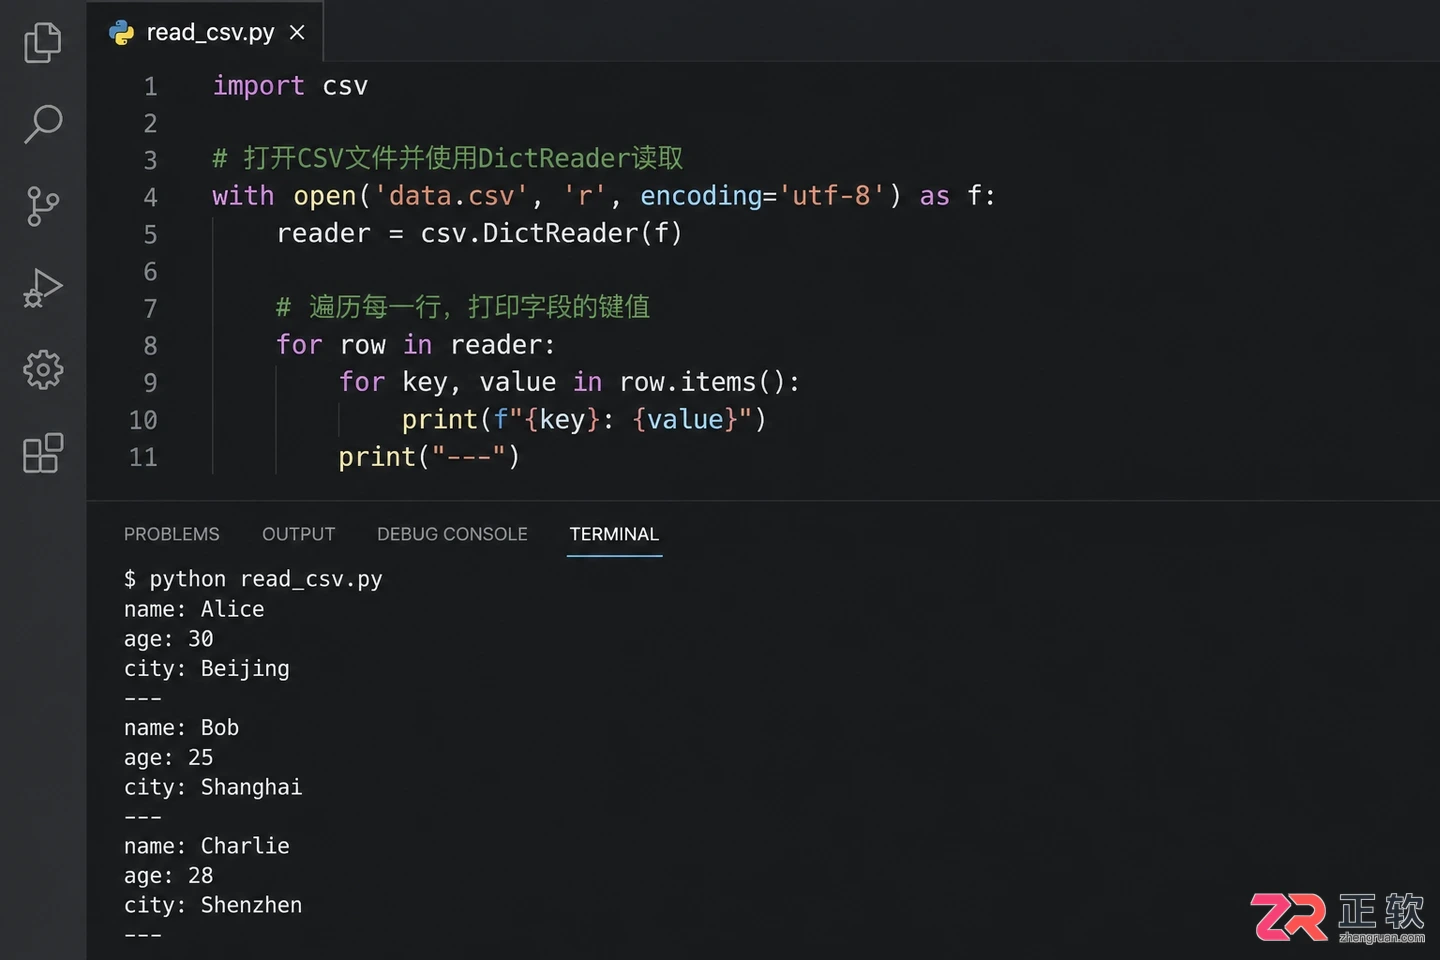
使用csv.DictReader读取数据的代码示例
Pandas处理CSV的效率与陷阱
pandas将CSV加载为DataFrame,提供了向量化操作能力。但在享受便利的同时,必须理解其背后的机制,避免性能回退。
1. 读取时的类型推断风险
pd.read_csv()会自动推断数据类型。如果某列前1000行是数字,第1001行是文本,该列会被强制转换为object类型,甚至导致后续计算报错。
import pandas as pd

# 推荐:明确指定dtype,避免推断错误和内存浪费
df = pd.read_csv('large_data.csv', dtype={'User_ID': str, 'Amount': float})
显式指定dtype不仅能防止类型混淆,还能显著降低内存占用。例如,将整数列指定为int32而非默认的int64,可节省近一半内存。
2. 大文件处理的内存边界
当CSV文件大小接近或超过可用内存时,直接read_csv会导致进程被Kill。此时不应强行增加内存,而应采用分块处理。
# 分块读取,每次处理10000行
chunk_size = 10000
chunks = []

for chunk in pd.read_csv('huge_file.csv', chunksize=chunk_size):
    # 对每个chunk进行清洗或聚合
    processed_chunk = chunk[chunk['Amount'] > 100]
    chunks.append(processed_chunk)

# 最后合并结果
result_df = pd.concat(chunks, ignore_index=True)
分块处理的本质是用时间换空间。 它避免了单次加载全部数据,但增加了I/O次数和Python层面的循环开销。如果只需简单过滤,这种方法有效;如果需要全局排序或复杂关联,分块则难以实现,此时应考虑数据库或Dask等分布式工具。
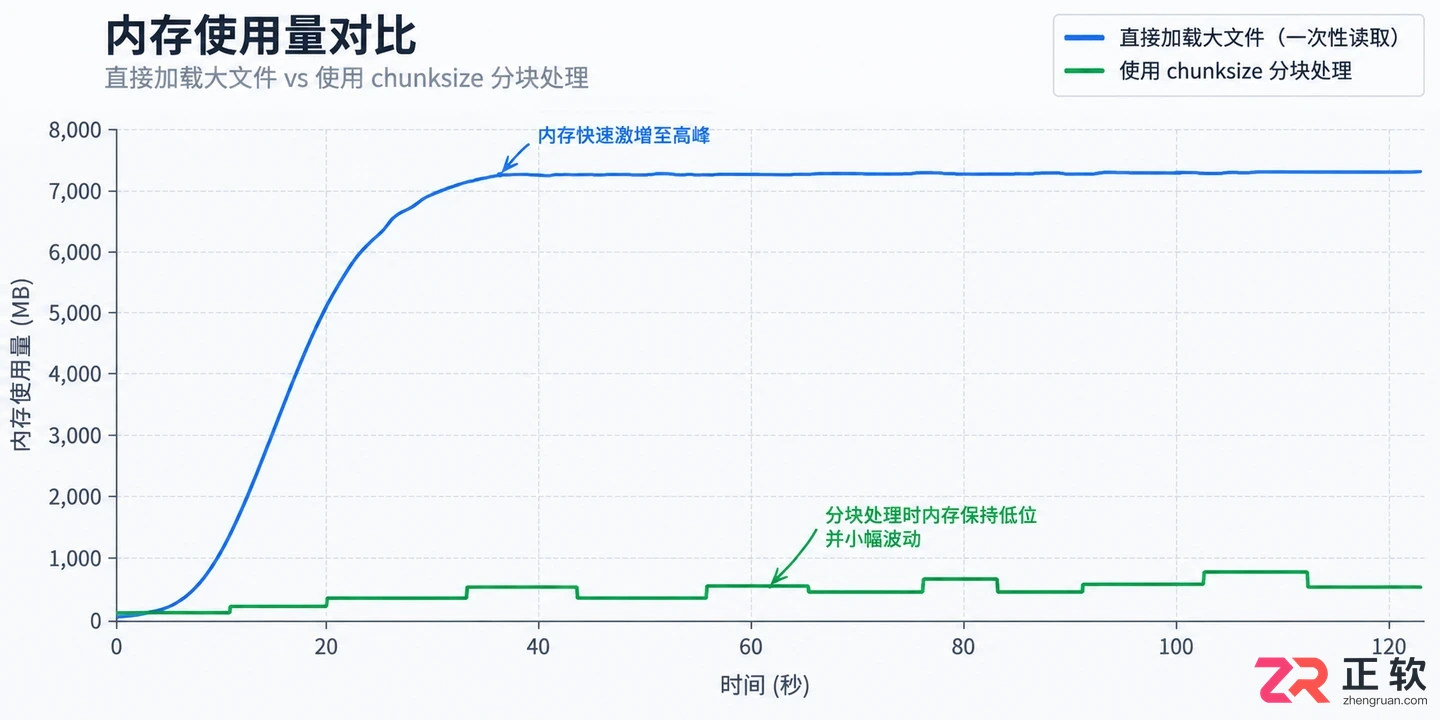
分块读取对内存占用的优化效果
3. 日期解析的性能损耗
parse_dates=True会让Pandas尝试解析所有列,耗时巨大。最佳实践是仅指定需要解析的列。
# 仅解析'Date'列,格式已知时可进一步加速
df = pd.read_csv('events.csv', parse_dates=['Date'], date_format='%Y-%m-%d')
何时不该使用Python处理CSV
尽管Python灵活,但在以下场景应果断放弃:
- 文件大于可用内存的50%且需全局操作:如全量去重、多表Join。此时应导入SQLite、PostgreSQL或使用Spark。
- 实时性要求极高的流数据:CSV是静态文件格式,不适合流式处理。应选用Kafka配合Avro或Parquet格式。
- 非结构化或半结构化数据:如果CSV中嵌套了JSON或XML,解析复杂度呈指数级上升,应直接处理原始日志格式。
选择工具的本质是权衡开发效率与运行成本。对于日常数据分析,Pandas是首选;对于系统底层集成,csv模块更可靠;对于海量数据,请转向数据库引擎。保持对数据边界的敬畏,比掌握任何库的API都更重要。

详解Navicat导入数据库的标准步骤,涵盖SQL脚本执行与CSV数据导入两种核心场景。针对导入过程中常见的字符集乱码、主键冲突及外键约束错误,提供具体的设置方法与修复建议,确保数据迁移准确无误。

学习如何使用Python高效删除列表中的重复元素。本文提供5种常见方法的代码示例,涵盖保持顺序与不保持顺序的场景,适合初学者和进阶开发者参考。

详细讲解使用Python编写Web接口的核心步骤与完整代码示例,涵盖环境准备、路由定义、数据校验、服务启动及调试测试方法。

介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。

详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。


客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。


针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。

本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



