

codex怎么读取word文档及docx文件操作教程
介绍如何利用编程工具读取和解析Word文档(docx格式),涵盖基础文本提取代码示例、结构化数据处理逻辑,以及处理复杂排版时的技术局限与替代方案。
在自动化办公和数据清洗的场景中,让代码模型或脚本直接“阅读”Word文档是一个常见需求。通常的建议是避免直接解析二进制格式的 .doc 文件,转而专注于基于XML标准的 .docx 格式。这并非因为旧格式无法读取,而是 .docx 的结构更透明,便于通过标准库进行稳定提取。理解这一前提,能帮助我们选择正确的工具链,避免在复杂的二进制解析中陷入困境。
区分文件格式的本质差异
Word文档主要有两种历史遗留格式:.doc 和 .docx。前者是微软专有的二进制格式,结构封闭且复杂;后者本质上是ZIP压缩包,内部包含一系列XML文件和资源文件夹。
对于代码处理而言,.docx 的优势在于其开放性。我们可以将其解压,直接查看 word/document.xml 中的文本节点。这种结构使得第三方库能够可靠地映射文档结构,而无需逆向工程二进制流。因此,当任务涉及批量提取文本或分析文档结构时,优先确保源文件为 .docx 格式是第一步。
使用 python-docx 提取纯文本
在Python生态中,python-docx 是处理 .docx 文件的事实标准库。它并不渲染文档视觉效果,而是专注于提取语义内容。最基本的操作是遍历文档中的所有段落,将文本拼接起来。
以下代码展示了如何读取一个名为 example.docx 的文件并提取所有段落文本:
from docx import Document

def extract_text_from_docx(file_path):
    doc = Document(file_path)
    full_text = []
    for paragraph in doc.paragraphs:
        full_text.append(paragraph.text)
    return '\n'.join(full_text)

# 使用示例
# text_content = extract_text_from_docx('example.docx')
# print(text_content)
这段代码的逻辑非常直观:加载文档对象,迭代 paragraphs 集合,获取每个段落的 text 属性。需要注意的是,paragraph.text 仅返回段落内的纯文本,不包含字体、颜色或加粗等样式信息。如果文档中包含表格,上述代码会忽略表格内容,因为表格在 python-docx 中属于独立的对象结构。
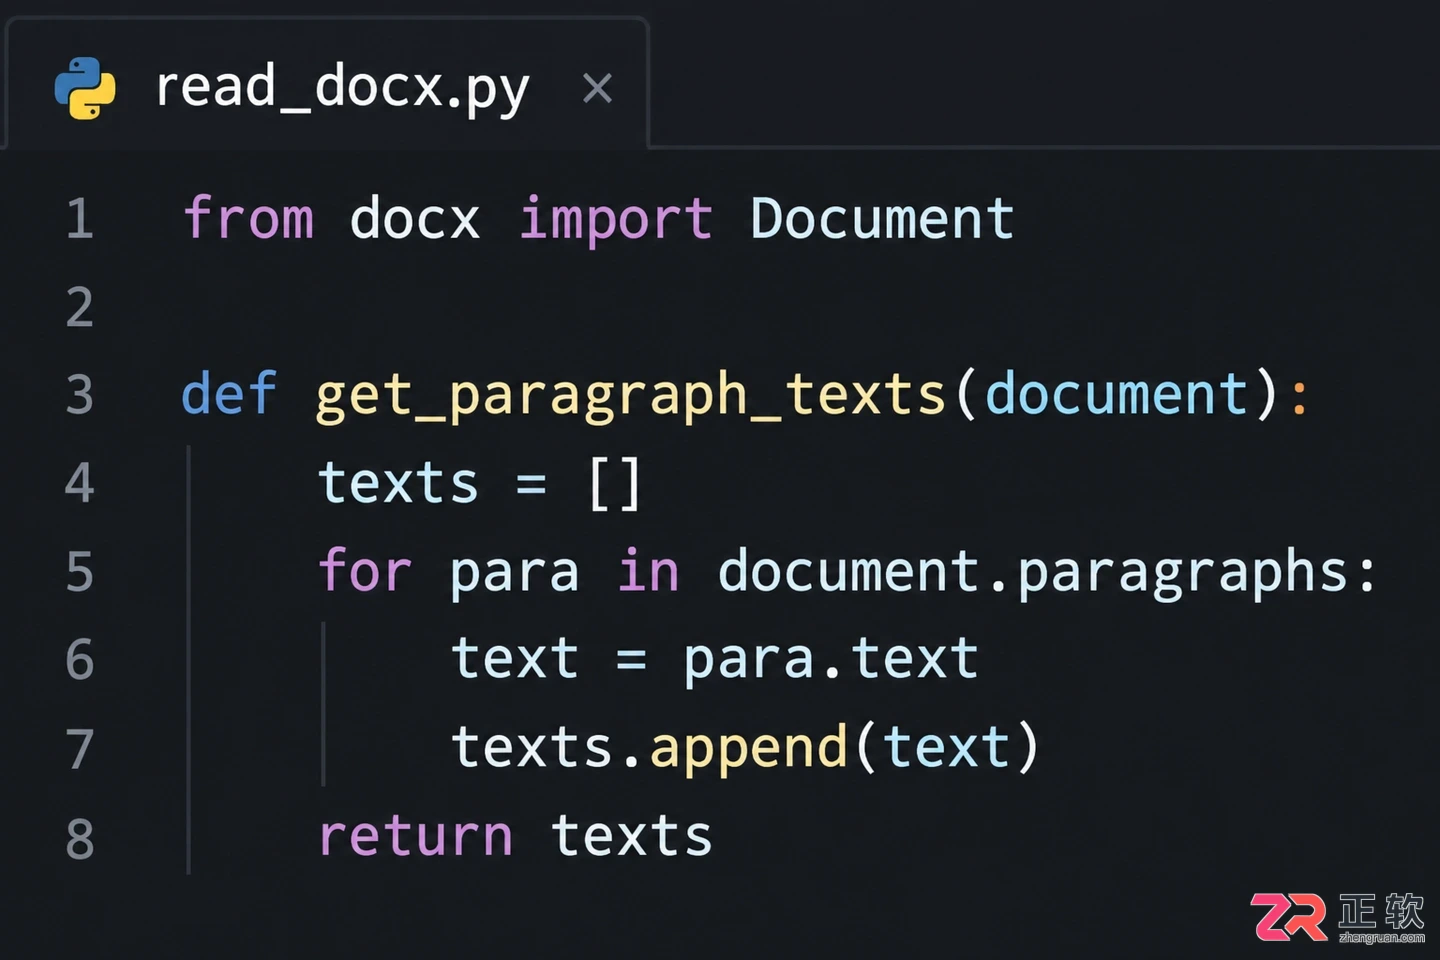
使用python-docx遍历段落提取纯文本的代码结构
处理表格与结构化数据
许多Word文档的核心价值在于表格。若只提取段落,会丢失大量关键数据。python-docx 提供了 tables 属性来访问文档中的所有表格。我们需要嵌套循环来遍历行和单元格。
def extract_tables_from_docx(file_path):
    doc = Document(file_path)
    table_data = []
    for table in doc.tables:
        for row in table.rows:
            row_data = [cell.text for cell in row.cells]
            table_data.append(row_data)
    return table_data
这种处理方式将二维表格转换为嵌套列表,便于后续存入数据库或转换为CSV。但需注意,合并单元格在处理时可能会产生空字符串或重复数据,具体行为取决于底层XML的定义方式。在实际业务中,往往需要对提取出的 row_data 进行清洗,去除首尾空白或无效字符。
保留样式的局限性
开发者常希望代码不仅能读取文字,还能保留“标题1”、“加粗”或“红色字体”等样式。然而,python-docx 的设计哲学是侧重内容而非表现。虽然可以通过 paragraph.style.name 获取段落样式名称,或通过 run 对象检查字体属性,但这会显著增加代码复杂度。
例如,一个段落可能由多个 run 组成,每个 run 可能有不同的格式。要完整重建样式,需要遍历每个段落下的所有 run,判断其 bold、italic 等属性,并自行生成标记语言(如Markdown或HTML)。这对于简单的文本提取任务来说,投入产出比极低。
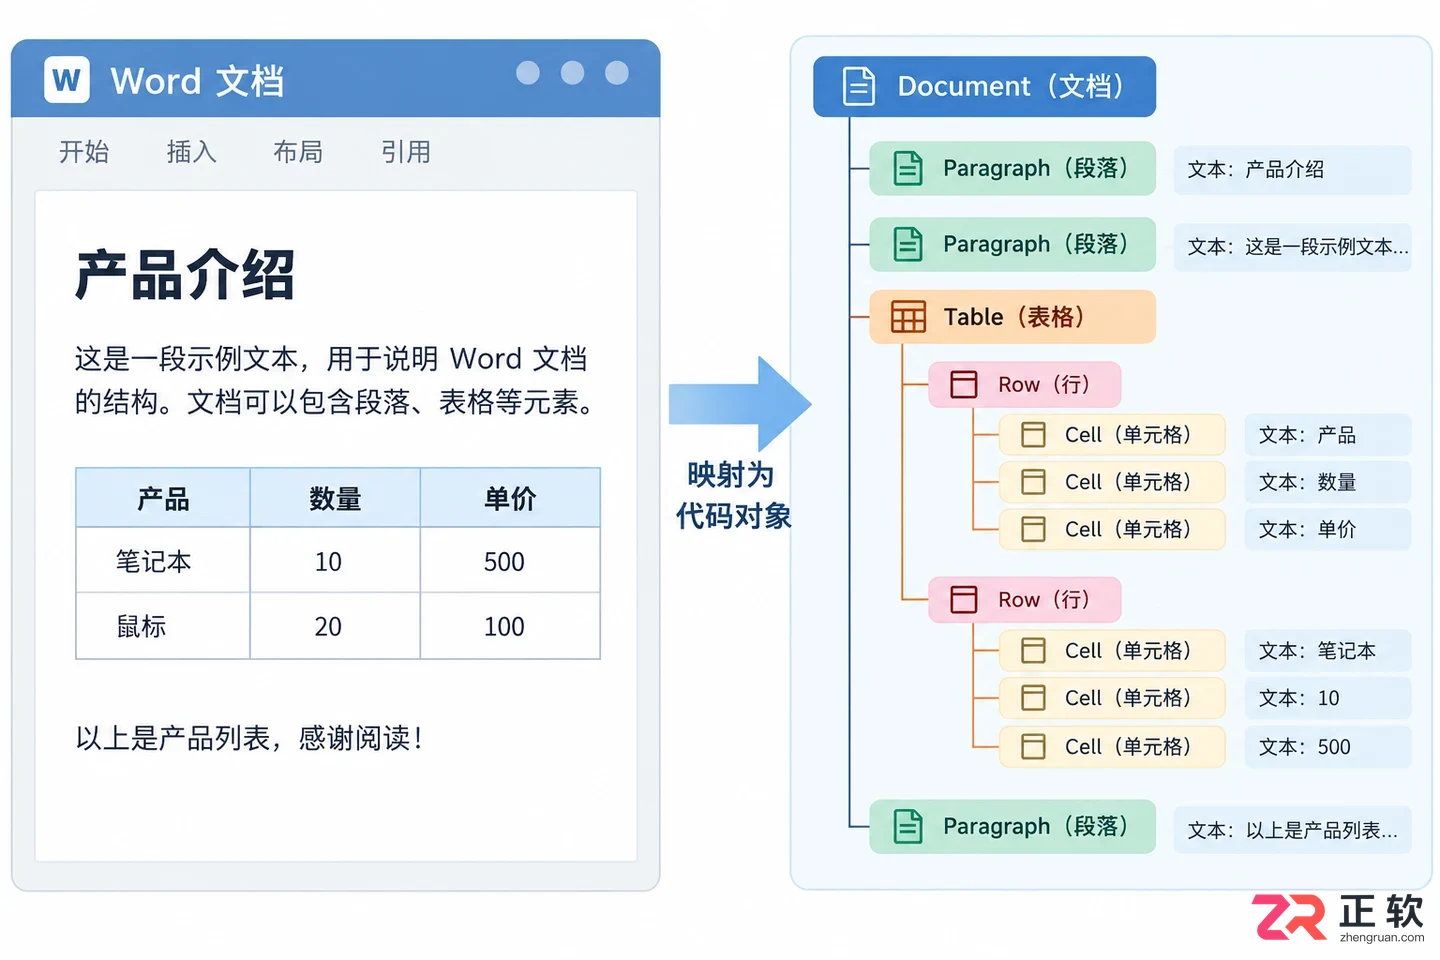
Word文档内部XML结构与python-docx对象映射示意
异常处理与文件损坏
在实际操作中,并非所有 .docx 文件都是合法的。用户可能修改了扩展名,或者文件在传输中损坏。直接调用 Document() 可能会抛出 PackageNotFoundError 或 KeyError。
健壮的代码应当包含异常捕获机制:
from docx import Document
from docx.opc.exceptions import PackageNotFoundError

def safe_extract(file_path):
    try:
        doc = Document(file_path)
        return '\n'.join([p.text for p in doc.paragraphs])
    except PackageNotFoundError:
        return "错误:文件不是有效的docx格式或已损坏"
    except Exception as e:
        return f"发生未知错误: {str(e)}"
这种防御性编程能防止因单个坏文件导致整个批处理任务中断。特别是在处理用户上传文件时,验证文件头或尝试解压测试是必要的前置步骤。
例外情况:何时不使用此方法
尽管 python-docx 适用于大多数文本提取场景,但在以下例外情况中,应考虑其他方案:
- 需要高精度视觉还原:如果目标是将Word转为PDF或图片,保持页眉页脚、分栏和图文混排的精确位置,
python-docx无能为力。此时应调用微软Office COM接口(Windows平台)或使用LibreOffice的命令行工具进行转换。 - 处理老旧 .doc 文件:对于二进制
.doc文件,python-docx完全不支持。需要使用pywin32调用Word应用程序本身,或使用antiword等专用工具,但这些方法依赖特定操作系统环境,移植性差。 - 超大文档性能瓶颈:
python-docx会将整个文档加载到内存中。对于数百兆的文档,可能导致内存溢出。此时应考虑流式解析XML,或使用专门的大文件处理库,但这牺牲了易用性。
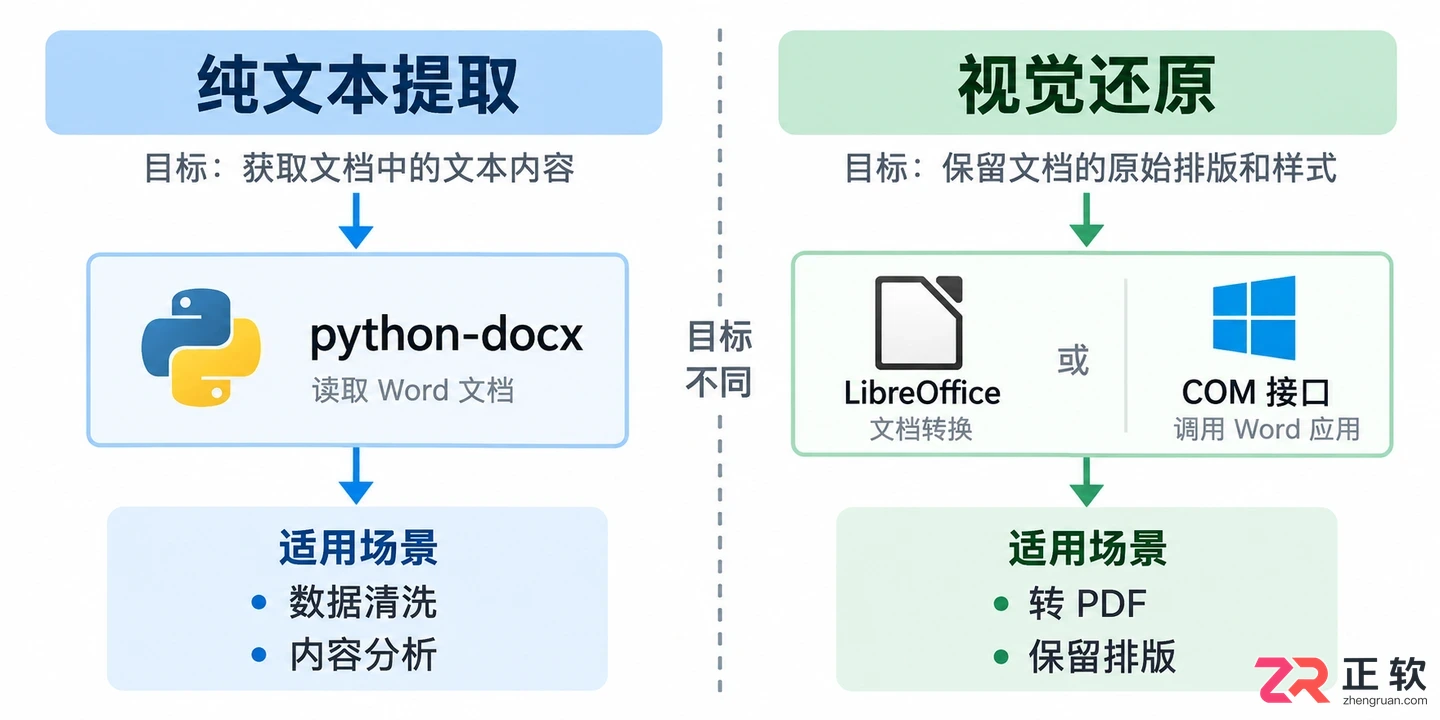
文本提取与视觉还原方案的选择逻辑
小结
读取Word文档的核心在于认清 .docx 的XML本质。使用 python-docx 可以高效提取纯文本和表格数据,适合数据清洗和内容分析任务。但它不是排版引擎,不适合用于需要保留复杂视觉样式的场景。在面对非标准文件或旧格式时,需结合异常处理和替代工具,根据具体需求权衡内容提取与格式保真的关系。
详细讲解在Python中调用C语言代码提升性能的完整实践指南,包含原理分析、编译步骤、ctypes与CFFI具体实现、性能对比及常见陷阱。
客观对比Python与C语言在心智负担、底层机制与学习反馈上的核心差异,提供清晰有据的选择标准与切实的入门学习路径。
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。
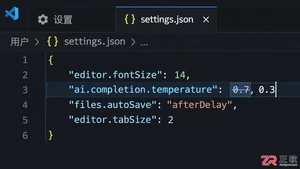
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


