

Java递归出现StackOverflowError的原因分析及栈空间优化方案
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
假设一个程序通过递归遍历树形数据,在数据量较小时运行正常,但处理层级特别深的数据时突然抛出 java.lang.StackOverflowError。这类问题通常不是Java堆内存不足,而是当前线程的调用栈被持续增长的递归调用占满。处理时应先判断递归能否正常结束,再检查递归深度和每层调用的开销,只有在递归本身合理但栈空间确实不足时,才考虑通过 -Xss 增大线程栈。
一、StackOverflowError到底是怎么产生的
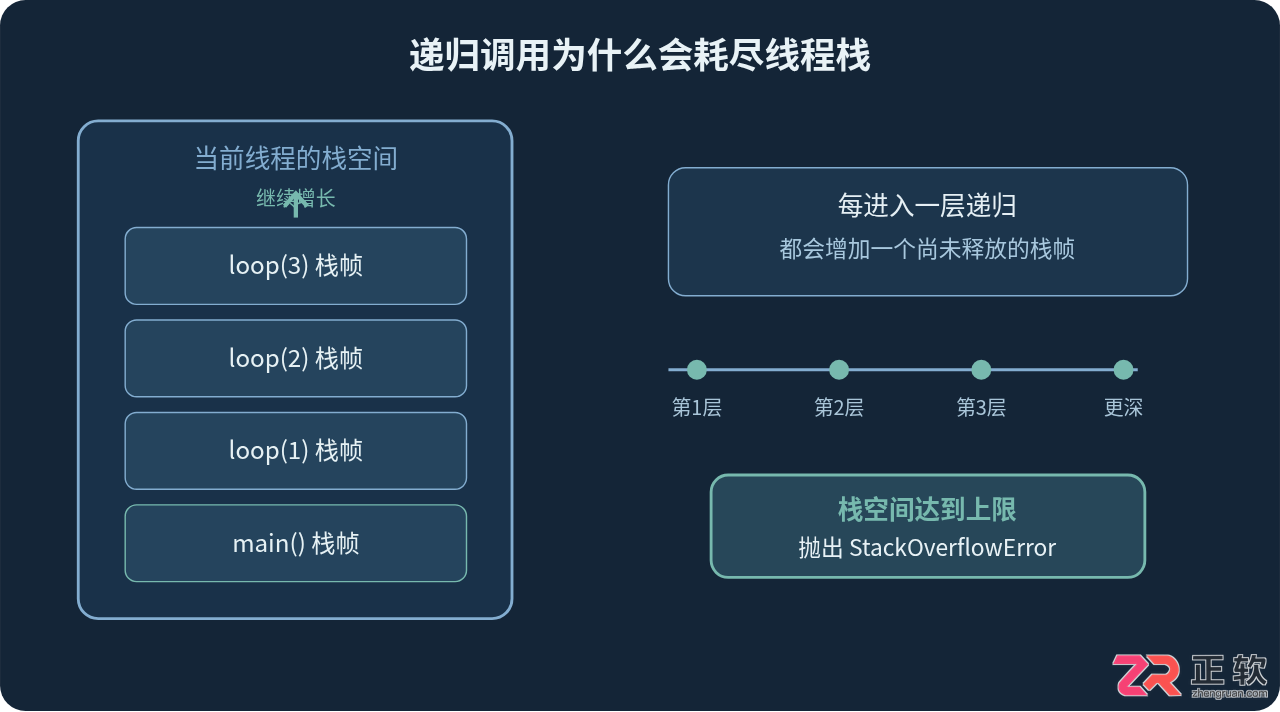
Java方法每调用一次,JVM都会为这次调用建立相应的栈帧。栈帧中需要保存方法参数、局部变量、操作数以及方法返回时所需要的信息。
普通方法调用结束后,对应的栈帧会退出,栈空间随之恢复。递归的特点是当前方法还没有返回,就再次调用了自己,因此新的栈帧会不断叠加。
例如下面这个方法没有终止条件:
public class RecursiveDemo {

    public static void loop(int n) {
        System.out.println(n);
        loop(n + 1);
    }

    public static void main(String[] args) {
        loop(1);
    }
}
运行一段时间后,可以看到类似下面的异常。
示例输出:
Exception in thread "main" java.lang.StackOverflowError
    at RecursiveDemo.loop(RecursiveDemo.java:4)
    at RecursiveDemo.loop(RecursiveDemo.java:5)
    at RecursiveDemo.loop(RecursiveDemo.java:5)
    at RecursiveDemo.loop(RecursiveDemo.java:5)
    ...
异常堆栈中同一个方法反复出现,正是典型的无限递归或递归深度过大的表现。
二、出现StackOverflowError的几种常见原因
1. 递归缺少终止条件
这是最容易发现的一种情况。方法不断调用自身,却没有任何条件阻止递归继续进行。
static int sum(int n) {
    return n + sum(n - 1);
}
即使传入的是正常数字,递归也会从 n 一直进入负数,不可能自行结束。
正确写法至少要有明确的边界:
static int sum(int n) {
    if (n <= 1) {
        return n;
    }

    return n + sum(n - 1);
}
当参数不断接近终止条件时,递归才能逐层返回。
2. 有终止条件,但参数没有向终止条件靠近
有些代码表面上已经写了出口,实际递归参数却没有发生正确变化。
static void process(int n) {
    if (n == 0) {
        return;
    }

    process(n);
}
n 永远不变,因此 n == 0 永远无法满足。这种问题在复杂业务递归中更隐蔽,例如树节点处理错误、父子节点形成环,或者某个分支忘记更新状态。
3. 递归本身正确,但数据层级过深
下面的倒计时递归逻辑没有错误:
static void countdown(int n) {
    if (n == 0) {
        return;
    }

    countdown(n - 1);
}
如果调用:
countdown(100);通常不会有什么问题。但如果实际业务输入导致递归层数达到数千、数万甚至更高,那么即使最终一定能够到达终止条件,也可能在到达之前就耗尽线程栈。
因此,“存在终止条件”和“递归深度安全”是两件不同的事情。
4. 单个栈帧开销较大
能够递归多少层并不存在一个适用于所有Java程序的固定数字。除了线程栈大小,方法本身的栈帧开销也会影响最大递归深度。
例如一个递归方法需要保存较多参数、局部状态,或者调用链中还包含其他方法,其实际能够承受的递归层数可能比一个极简递归方法更少。
三、遇到栈溢出时应该怎样排查
看到 StackOverflowError 后,不建议马上增加 -Xss。更合理的顺序是先确认程序是不是错误递归,再判断是不是正常业务产生了过深的调用链。
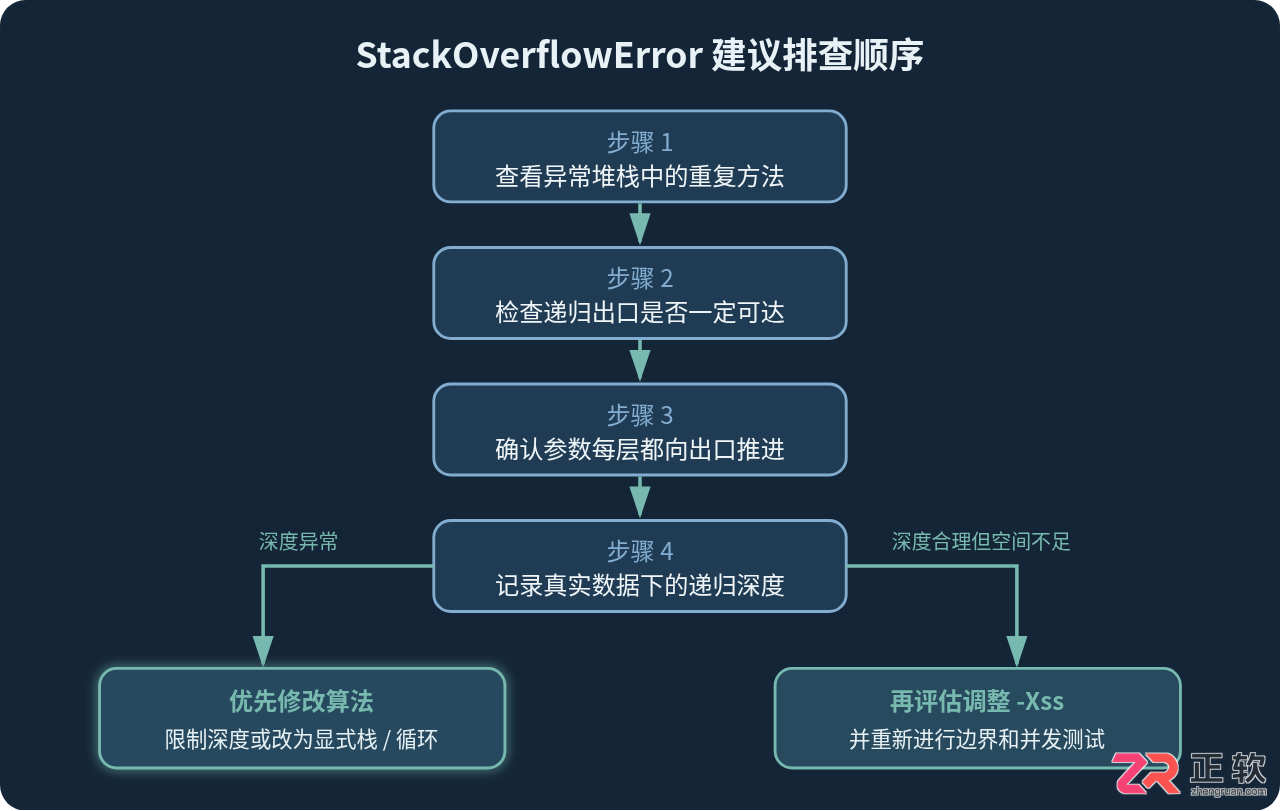
1. 从异常调用栈中寻找重复方法
如果异常中连续几百行都指向同一个方法,通常可以直接锁定递归入口。如果多个方法交替出现,则可能属于间接递归,例如:
static void methodA() {
    methodB();
}

static void methodB() {
    methodA();
}
这类代码虽然没有一个方法直接调用自己,但调用关系形成了环,同样会不断增加调用栈。
2. 给递归增加深度记录
如果不知道真实业务到底进入了多少层,可以临时记录深度。
static void walk(Node node, int depth) {
    System.out.println("depth = " + depth);

    if (node == null) {
        return;
    }

    walk(node.getChild(), depth + 1);
}
实际项目中不建议在极深递归的每一层都长期打印日志,因为大量日志本身会带来明显开销。调试时可以只记录最大值,或者每隔固定层数输出一次。
3. 检查数据结构本身是否存在环
递归遍历树形结构时,一个经常被忽略的问题是输入数据并不一定真的是“树”。例如:
A -> B -> C -> A如果程序按子节点不断递归,就会再次回到A,形成死循环。对于可能出现环的数据结构,除了递归终止条件,还要维护已经访问过的节点。
static void visit(Node node, Set visited) {
    if (node == null || !visited.add(node)) {
        return;
    }

    for (Node child : node.getChildren()) {
        visit(child, visited);
    }
}
visited.add(node) 在节点首次出现时返回 true,重复出现时返回 false,这样就能阻止循环引用继续递归。
四、最有效的优化通常不是扩大栈,而是减少递归
如果输入规模本身可能非常大,单纯依赖更大的线程栈并不能从根本上消除风险。只要递归深度继续增长,新的栈上限最终仍然可能被突破。
对于线性递归,通常可以直接改成循环。
递归写法
static long sum(long n) {
    if (n <= 0) {
        return 0;
    }

    return n + sum(n - 1);
}
循环写法
static long sum(long n) {
    long result = 0;

    for (long i = 1; i <= n; i++) {
        result += i;
    }

    return result;
}
循环不会随着 n 增大而建立同等数量的方法调用栈帧,因此对于可能出现超深递归的线性算法,这是更稳定的处理方式。
五、树和图的深度遍历可以改成显式栈
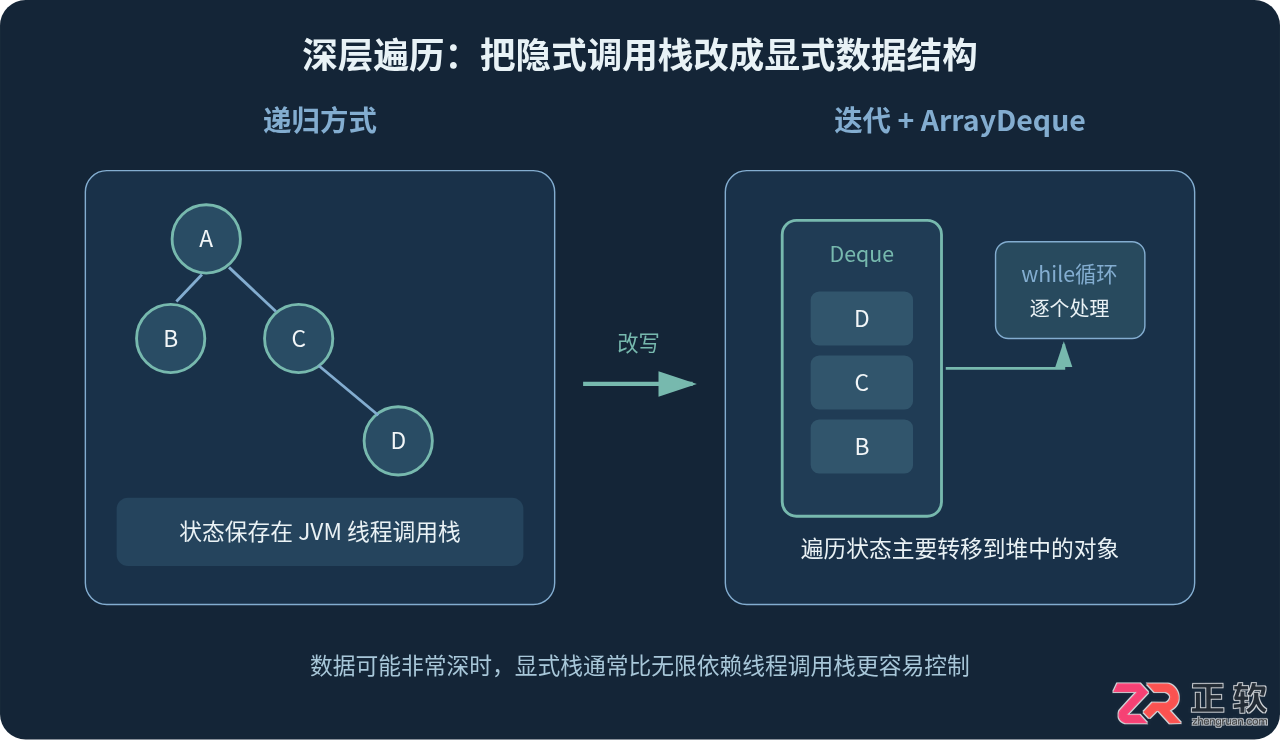
有些算法天然适合递归,例如深度优先遍历。此时如果节点深度无法控制,可以把原本依赖JVM调用栈保存的状态,转移到堆上的数据结构中。
例如下面是一棵树的递归遍历:
static void traverse(Node node) {
    if (node == null) {
        return;
    }

    System.out.println(node.getValue());

    for (Node child : node.getChildren()) {
        traverse(child);
    }
}
可以改成使用 Deque 保存待处理节点:
import java.util.ArrayDeque;
import java.util.Deque;

static void traverse(Node root) {
    if (root == null) {
        return;
    }

    Deque stack = new ArrayDeque<>();
    stack.push(root);

    while (!stack.isEmpty()) {
        Node node = stack.pop();

        System.out.println(node.getValue());

        for (int i = node.getChildren().size() - 1; i >= 0; i--) {
            stack.push(node.getChildren().get(i));
        }
    }
}
这里仍然存在“栈”,但已经不是线程调用栈,而是程序自己维护的 ArrayDeque。它的内存主要来自堆空间,因此不会因为调用层数过深直接触发 StackOverflowError。
六、确实需要递归时,可以通过-Xss调整线程栈
如果已经确认以下几点:
- 递归逻辑正确,不存在无限递归;
- 输入数据的最大深度是可预测、可控制的;
- 递归方式明显比迭代实现更简单或更适合当前算法;
- 当前问题确实是默认线程栈不足;
那么可以考虑调整JVM的线程栈大小。
常用参数是:
-Xss1m例如在命令行运行程序:
java -Xss1m RecursiveDemo也可以设置为其他大小,例如:
java -Xss2m RecursiveDemo-Xss 控制的是单个线程所使用的栈空间,而不是Java堆空间。具体可接受的单位和范围应以当前使用的JDK及JVM实现为准。
如果通过IDE启动Java程序,应把参数放到对应运行配置的VM Options、JVM Options一类配置项中,而不是作为 main() 的普通程序参数传入。
如何确认-Xss是否生效
可以在启动前查询当前JVM支持的命令行参数帮助:
java -X也可以使用实际递归测试程序,在相同JDK、相同机器和相同代码条件下分别使用不同 -Xss 设置进行边界测试。
例如:
public class StackDepthTest {

    private static int depth = 0;

    static void recursive() {
        depth++;
        recursive();
    }

    public static void main(String[] args) {
        try {
            recursive();
        } catch (StackOverflowError e) {
            System.out.println("递归深度约为:" + depth);
        }
    }
}
分别启动:
java -Xss512k StackDepthTest

java -Xss1m StackDepthTest
通常更大的线程栈能够容纳更多方法调用,但具体深度不要写死到业务代码中,也不要把一次测试得到的结果当成所有环境下的固定值。
七、为什么不能一味增大-Xss
增大 -Xss 看起来简单,但它有一个非常重要的代价:每个线程都需要自己的线程栈。
例如,同样一个应用,如果每个线程允许使用的栈空间明显增大,那么在大量线程并存时,整个进程为线程栈预留或消耗的内存也会相应增加。
因此,对于高并发服务,不能只观察“递归不报错了”,还要同时评估线程数量和进程整体内存。
| 处理方式 | 适合情况 | 主要特点 |
|---|---|---|
| 修复终止条件 | 无限递归、参数不收敛 | 必须优先处理,扩大栈无法解决逻辑错误 |
| 限制最大递归深度 | 业务允许设置深度边界 | 可以直接阻止异常数据拖垮线程栈 |
| 改成循环 | 线性递归、状态简单 | 通常最彻底,调用栈不会随输入线性增长 |
| 使用Deque显式栈 | 深度优先遍历、树或图处理 | 把递归状态转移到可控的数据结构 |
| 增大-Xss | 递归合理且最大深度可控 | 修改简单,但会增加每个线程的栈空间成本 |
八、不要把尾递归当成Java的通用解决方案
一些语言能够对尾递归进行优化,让尾递归调用不持续增加调用栈。但在普通Java代码中,不应假设JVM会自动把尾递归转换成固定栈空间的循环。
例如:
static long sum(long n, long result) {
    if (n == 0) {
        return result;
    }

    return sum(n - 1, result + n);
}
虽然递归调用已经位于方法返回位置,但编写Java程序时仍应按照“递归会继续占用调用栈”来设计。对于可能产生极大深度的数据,显式循环通常更可靠。
九、生产环境中更稳妥的优化思路
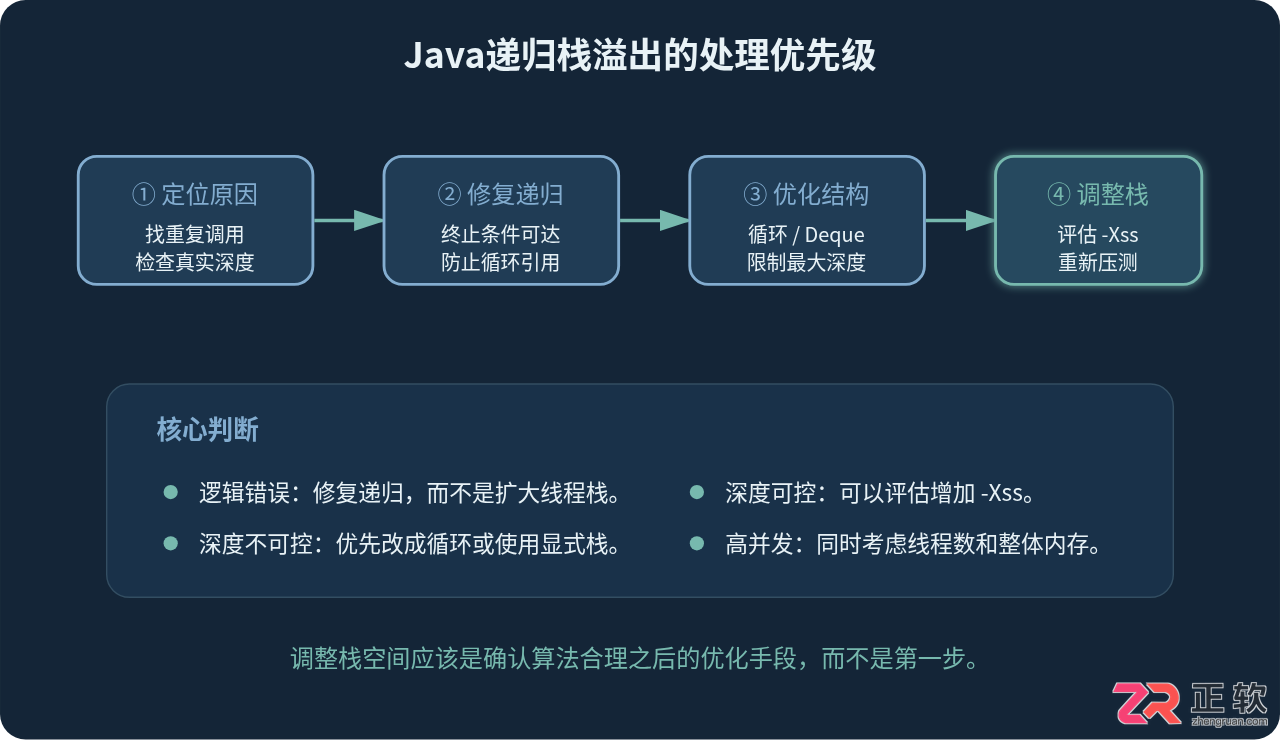
实际项目中可以按照下面的优先级处理。
- 确认递归是否应该结束。检查终止条件、参数变化和循环引用。
- 确认最大深度。不要只使用正常样本,应包含最大层级和异常层级数据。
- 可以使用循环时优先循环。尤其是简单的线性递归。
- 树和图遍历考虑显式栈。使用
Deque管理状态,并根据业务需要增加已访问节点集合。 - 确实有必要时再调整-Xss。修改后同时进行递归边界测试和并发内存测试。
如果业务本身规定了最大嵌套层数,还可以直接在递归方法中建立保护。
private static final int MAX_DEPTH = 1000;

static void process(Node node, int depth) {
    if (node == null) {
        return;
    }

    if (depth > MAX_DEPTH) {
        throw new IllegalStateException(
            "数据嵌套层级超过限制:" + MAX_DEPTH
        );
    }

    for (Node child : node.getChildren()) {
        process(child, depth + 1);
    }
}
与其等到JVM耗尽线程栈后才得到 StackOverflowError,这种方式可以在业务能够理解的位置主动中止异常数据,并给出更明确的错误信息。
十、总结
StackOverflowError 的核心含义,是当前线程继续执行方法调用时已经没有足够的栈空间。递归尤其容易触发这个问题,因为上一层方法尚未返回,下一层方法就已经建立了新的栈帧。
遇到问题时,最先检查的应该是终止条件是否正确、递归参数是否持续接近出口,以及数据结构中是否存在循环引用。递归逻辑正确之后,还要判断实际数据可能达到多深。
如果递归深度会随着输入规模不断增长,优先考虑循环、Deque 显式栈或者最大深度限制。只有在递归算法确实合理、最大深度可控,而且现有线程栈空间不足时,才适合通过 -Xss 增加栈空间。
同时需要记住,-Xss 针对的是每个线程。在服务器程序中把它设置得过大,虽然能够提高单个线程可以承受的调用深度,却可能增加大量线程同时存在时的内存压力。因此,真正可靠的优化方案应同时考虑递归逻辑、最大调用深度、线程数量和整体内存,而不是单独追求更大的栈空间。
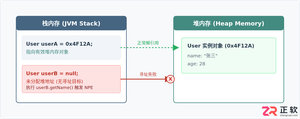
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。
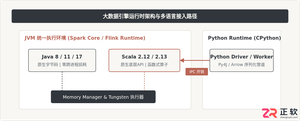
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
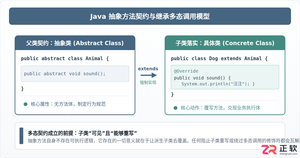
深入剖析Java中抽象方法为何严禁使用private和static修饰符。从面向对象契约规范、方法继承重写、JVM动态绑定(invokevirtual)与静态解析(invokestatic)等底层机制展开详细推导,结合编译报错示例与全景对比,彻底理清修饰符限制背后的设计逻辑。
系统解析Java局部变量、成员变量与静态变量的定义语法、声明与初始化机制、生命周期及JVM内存驻留规则,结合图解与代码示例分析常见编译错误与认知误区。
针对Java开发中常见的“子类未实现抽象方法”编译错误,深入分析报错原因,提供重写实现、声明抽象子类两种标准修复路径,并总结参数签名、访问修饰符等典型避坑要点。
解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
适合初学者的JUnit入门指南,详解如何配置环境、编写首个测试用例、使用断言验证结果,并分析单元测试的适用场景与例外情况。
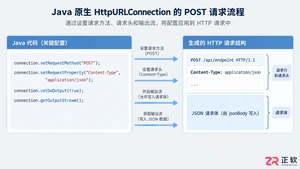
深入解析Java发送JSON格式POST请求的实现机制,对比原生API与第三方库的代码差异,提供可复制的代码示例,并探讨超时设置、编码处理及微服务场景下的例外情况。
百度官方在线入口最新版网页版直达官网是https://www.baidu.com/,界面简洁无干扰、多端同步体验一致、内容聚合维度丰富、语音与图像识别稳定、隐私控制机制可见。




AirBuddy 3 是面向 macOS 的蓝牙外设增强工具,可集中查看 AirPods、Beats 与苹果设备电量,提供快速连接、播放控制、电量提醒、桌面小组件和多台 Mac 外设接力等功能。

AirServer macOS版可把 Mac 转换为无线投屏接收端,通过 AirPlay 或 Google Cast 接收手机、平板和电脑画面,并支持多设备同时连接、高清镜像及会话录制,适合家庭娱乐、课堂教学、会议演示和应用展示。

AnyDesk macOS版是一款适用于远程办公、设备维护和客户支持的远程桌面工具,可连接并操作异地计算机,支持文件传输、无人值守访问、会话权限控制及跨平台协作。


AirServer Windows版可把电脑变成AirPlay、Google Cast和Miracast无线投屏接收端,适合会议演示、课堂教学及家庭大屏分享。发送设备通常无需另装客户端,并可同时接收和智能排列多个镜像会话。

AlwaysUp是一款面向Windows的系统服务注册与程序托管工具,可让普通应用、脚本及批处理在无人登录时随系统启动,并通过状态检测、异常重启、资源监控和邮件通知保障关键任务持续运行。


