

本地部署大模型对比:DeepSeek-R1-0528-Qwen-8B性能评测
图片大家好,我是ai学习的老章今天分享一个我最近频繁使用的大模型并发压力测试工具,并实测一下我在双4090显卡上本地部署的<em>DeepSeek</em>-R1-0528-<em>Qwen</em>-8B模型的实际表现。这是我目前最钟爱的三个DeepSeek蒸馏版本之一DeepSeek-R1-0528基于Qwen3:8B进行知识蒸馏优化,配合双4090实现本地高效推理,性能与效果兼备,深得我心LLM-Benchmark工具介绍项
 图片大家好,我是 ai 学习的老章
今天分享一个我最近频繁使用的大模型并发压力测试工具,并实测一下我在双 4090 显卡上本地部署的 DeepSeek-R1-0528-Qwen-8B 模型的实际表现。
这是我目前最钟爱的三个 DeepSeek 蒸馏版本之一
DeepSeek-R1-0528 基于 Qwen3:8B 进行知识蒸馏优化,配合双 4090 实现本地高效推理,性能与效果兼备,深得我心
LLM-Benchmark 工具介绍
项目地址:https://github.com/lework/llm-benchmark
LLM-Benchmark 是一款专为大语言模型设计的自动化并发性能压测工具,适用于开发者和运维人员对本地或远程 LLM 服务进行系统性性能评估。它支持从低负载到高并发的多阶段测试,帮助定位瓶颈、优化部署策略。
核心功能亮点:
- 多阶段压力测试:支持从 1 到 300 并发逐步加压,观察模型在不同负载下的表现。
- 自动化数据采集:自动记录每轮测试的响应时间、吞吐量、错误率等关键指标。
- 可视化性能报告:生成结构化报告,直观展示 RPS、延迟、TPS 等趋势变化。
- 长短文本双模式测试:覆盖短问答与长上下文生成场景,贴近真实应用。
- 高度可配置:通过命令行灵活设置模型名、URL、并发数、请求数等参数。
- JSON 输出支持:便于后续分析或集成至 CI/CD 流程。
主要文件说明:
run_benchmarks.py:主测试脚本,执行全量多轮测试,自动生成汇总报告。
llm_benchmark.py:核心压测逻辑,处理并发请求、连接池管理及流式响应测试。
assets/:存放测试用资源文件。
README.md:详细使用文档与参数说明。
使用方式
1. 执行完整性能测试(推荐)
运行以下命令进行全量多并发测试,适合全面评估模型服务能力:
python run_benchmarks.py \ --llm_url "http://your-llm-server" \ --api_key "your-api-key" \ --model "your-model-name" \ --use_long_context
参数说明:
- --llm_url:目标 LLM 服务地址(必填)
- --api_key:认证密钥(可选)
- --model:模型名称(默认为 deepseek-r1)
- --use_long_context:启用长文本测试模式(默认关闭)
2. 单次并发测试(按需定制)
若只想测试特定并发级别,可使用单测脚本:
python llm_benchmark.py \ --llm_url "http://your-llm-server" \ --api_key "your-api-key" \ --model "your-model-name" \ --num_requests \ --concurrency
参数说明:
- --num_requests:总请求数(必填)
- --concurrency:并发数量(必填)
还可自定义输出 token 数、超时时间、输出格式等。
实测结果展示
我使用如下命令对本地部署的模型进行全量长上下文测试:
python run_benchmarks.py \ --llm_url "http://localhost:8001/v1" \ --api_key "123" \ --model "R1-0528-Qwen3-8B" \ --use_long_context
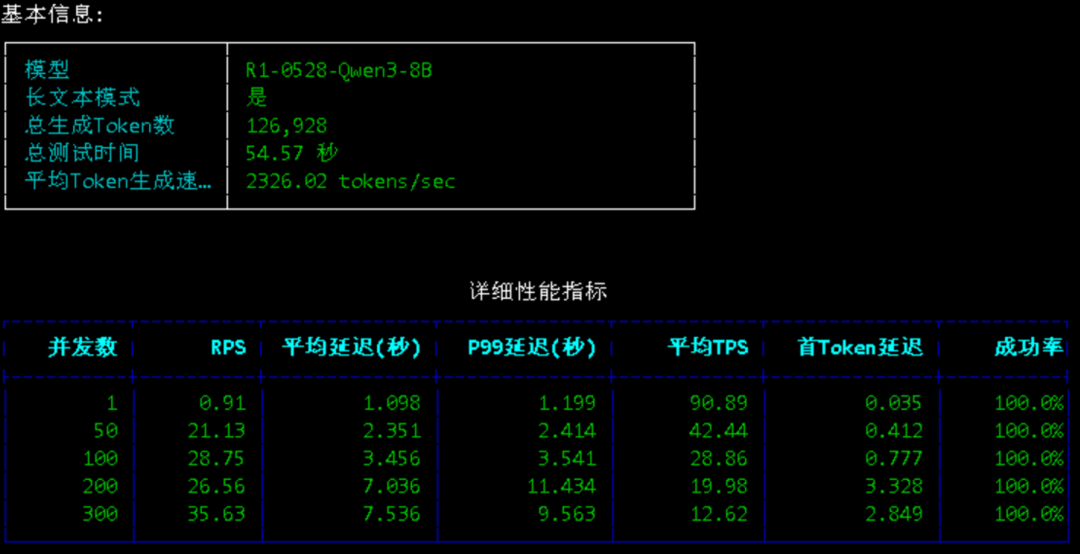
测试结果如下图所示:
 图片
性能指标解读
RPS(每秒请求数)
衡量系统吞吐能力,RPS 越高,并发处理能力越强。测试中从单并发 0.91 提升至 300 并发下的 43.53,表现出色。平均延迟(秒)
用户体验的关键指标。低并发时仅 1.098 秒,300 并发上升至 12.62 秒,符合预期增长趋势。P99 延迟(秒)
反映极端情况下的响应稳定性。随着并发增加略有上升,但整体可控。平均 TPS(每秒生成 token 数)
衡量模型生成效率。峰值达 90.89 tokens/s,在 50 并发下仍保持 42.44,表现优异。首 Token 延迟(秒)
影响交互即时感。低并发下低至 0.035 秒,但在 200/300 并发时升至约 2.85 秒,说明高负载下启动响应略有延迟。成功率
所有测试场景下均为 100%,无请求失败,稳定性极佳。
对比主流平台 DeepSeek API 实际生成速度
| 平台 | 生成速度(tokens/s) | 备注 |
|---|---|---|
| DeepSeek-V3 官方宣称 | 60 | 官方数据 |
| DeepSeek-R1 实测(Content部分) | 37.76 | 118 tokens / 3.12s |
| DeepSeek-R1 总体实测 | 33.01 | 436 tokens / 13.21s |
| 深圳本地测试 DeepSeek 官方服务 | 37.117(生成),25.378(推理) | —— |
| 火山引擎(深圳) | 65.673 | 成都节点高达 72.276 |
| 火山引擎(六平台评测均值) | 32(生成),29(推理) | 稳定性突出 |
| 硅基流动(深圳) | 16.966 | —— |
| 阿里云百炼(深圳) | 11.813 | 存在明显时段波动 |
| 讯飞开放平台 | 1.2(推理均值) | 表现较弱 |
| Meta Llama API(Cerebras) | 高达 2600 | Llama 4 Cerebras |
| Groq(Llama 4 Scout) | 460 | 极速推理硬件支持 |
总结
在本地资源有限的前提下,DeepSeek-R1-0528-Qwen-8B 配合双 4090 显卡部署方案,依然是我心中最均衡、最实用的选择。
无论是吞吐能力、响应速度还是稳定性,实测表现都令人满意,尤其在中等并发下兼顾了效率与体验。相比部分公有云 API 的波动性,本地部署更可控、更安全、成本更低。
如果你也在寻找一款适合本地运行的高性能蒸馏模型,强烈推荐尝试这个组合!
打开文稿点右上角导出,格式选Word,再勾选要导出的原文、译文或纪要;多份文件在列表里多选后走批量导出,批量前先统一改名。
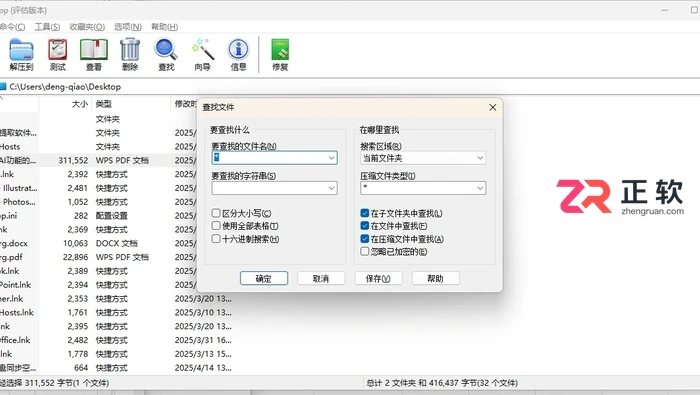
在资源管理器多选文件夹,右键添加到压缩文件并填统一文件名即可打包;已存在的包可打开后点添加追加,追加会重写整包,操作前先备份。
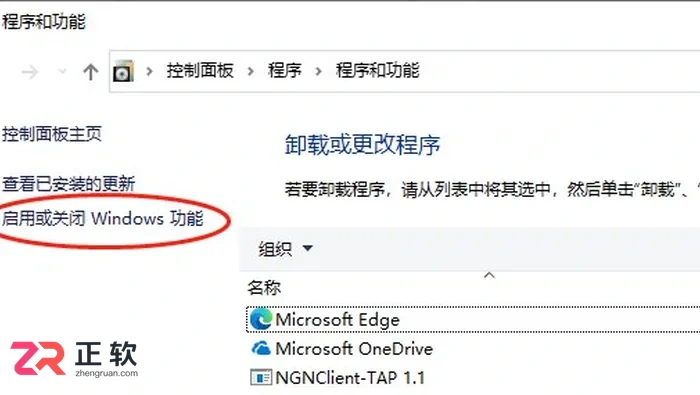
先在程序和功能卸掉所有 Office 条目,再删 Program Files 与 ProgramData 下的 Office 目录和 Office 缓存,最后确认账号状态再重装。
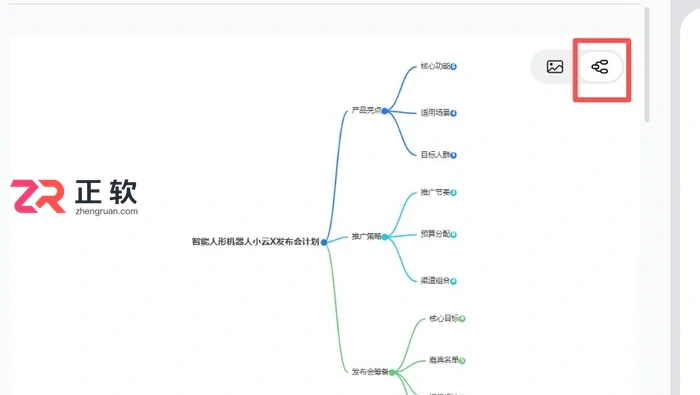
打开转写稿进AI纪要,切到思维导图视图即可自动生成层级节点树,节点可改可拖;它挂在AI纪要下面,不在导出或设置里。
AniShort制作短剧时,人物五官、发型和服装在不同镜头中容易漂移。本文讲建立角色基准、逐镜复用主体和对比关键特征,帮助统一人物外貌并减少返工。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



