

Python字典遍历方法与技巧
遍历Python字典有三种核心方式:仅遍历键(forkeyindict)、仅遍历值(forvalueindict.values())、同时遍历键值对(forkey,valueindict.items()),其中items()在需同时访问键值时效率最高;直接修改遍历中的字典会引发运行时错误,应通过遍历副本或构建新字典解决;高级技巧包括字典推导式、结合sorted()排序遍历及使用ChainMap合并多个字典视图。
遍历Python字典有三种核心方式:仅遍历键(for key in dict)、仅遍历值(for value in dict.values())、同时遍历键值对(for key, value in dict.items()),其中items()在需同时访问键值时效率最高;直接修改遍历中的字典会引发运行时错误,应通过遍历副本或构建新字典解决;高级技巧包括字典推导式、结合sorted()排序遍历及使用ChainMap合并多个字典视图。
在Python中,遍历字典核心上就是围绕着它的键、值,或者同时处理键值对进行的。理解这三者之间的细微差别和各自的适用场景,是高效处理字典数据的关键。这不仅仅是语法上的选择,更是对数据访问模式的一种思考。
解决方案
处理Python字典的遍历,我们通常有三种核心策略,每种都对应着不同的使用场景和效率考量。
1. 遍历键 (Keys)
这是最直接、也是默认的遍历方式。当你直接在一个字典对象上进行 for 循环时,Python会默认迭代它的所有键。
my_dict = {
    'name': 'Alice',
    'age': 30,
    'city': 'New York'
}

print("--- 遍历键 (默认方式) ---")
for key in my_dict: # 也可以显式地写成 for key in my_dict.keys():
    print(f"键: {key}")
    # 如果需要值,可以通过键再次访问
    # print(f"键: {key}, 值: {my_dict[key]}")
这种方式适合你只需要处理字典的键,或者需要根据键来执行一些操作(比如检查键是否存在,或者根据键获取对应的值)。我个人觉得,当你只是想看看字典里都有哪些“标签”时,这种方式最直观。
2. 遍历值 (Values)
如果你只关心字典中存储的数据本身,而不需要知道这些数据对应的键是什么,那么直接遍历值会更简洁。
my_dict = {
    'name': 'Alice',
    'age': 30,
    'city': 'New York'
}

print("\n--- 遍历值 ---")
for value in my_dict.values():
    print(f"值: {value}")
这种方法在处理一些统计或聚合任务时特别方便,比如计算所有数值的总和,或者检查某个值是否存在于字典中。它避免了不必要的键查找,代码也更清晰。
3. 遍历键值对 (Items)
这是我最常用,也最推荐的方式,因为它一次性提供了键和值,避免了在循环内部通过键再次查找值的操作。这在大多数需要同时处理键和值的场景下,效率更高,代码也更优雅。
my_dict = {
    'name': 'Alice',
    'age': 30,
    'city': 'New York'
}

print("\n--- 遍历键值对 ---")
for key, value in my_dict.items():
print(f"键: {key}, 值: {value}")当你需要根据键和值同时进行判断、修改或构建新的数据结构时,items() 方法简直是量身定制。它不仅提高了可读性,也减少了潜在的性能开销,尤其是在字典很大的时候。
Python字典遍历时,哪种方法性能最好?
关于字典遍历的性能,这其实是个很有趣的问题,也常常引人思考。从我的经验来看,大多数情况下,现代Python解释器对这几种遍历方式都做了很好的优化,所以对于一般的字典大小和应用场景,你可能不会感受到明显的性能差异。不过,如果要深究,my_dict.items() 通常被认为是效率最高的选择,尤其是在你需要同时访问键和值时。
为什么呢?当你使用 for key in my_dict: 然后在循环内部用 my_dict[key] 获取值时,实际上你执行了两次操作:一次是迭代键,另一次是每次迭代时进行一次哈希查找来获取值。而 my_dict.items() 会一次性生成键值对的视图,并在每次迭代时直接返回一个元组 (key, value),这避免了重复的哈希查找。
当然,如果你只是需要键,那么 for key in my_dict: 或 for key in my_dict.keys(): 自然是最快的,因为它只处理键。同理,只遍历值时 my_dict.values() 也是最直接高效的。
所以,与其纠结于微小的性能差异,我更倾向于根据“代码意图”来选择最清晰、最符合逻辑的遍历方式。如果需要键值对,就用 items();如果只关心键,就直接迭代字典;如果只关心值,就用 values()。代码的可读性和维护性往往比那一点点微不足道的性能提升更重要。
如何在遍历字典时修改或删除元素?
在Python中,直接在遍历字典的同时修改或删除其元素,是一个常见的“陷阱”。当你尝试这么做时,Python通常会抛出 RuntimeError: dictionary changed size during iteration 错误,因为你在迭代一个正在被改变的集合。这就像你站在一列火车上,同时试图改变这列火车的轨道,结果往往是混乱的。
那么,正确的做法是什么呢?核心思想是:不要在迭代时直接修改原字典。
1. 遍历副本进行修改/删除:
最常见的解决方案是遍历字典的一个副本,然后对原字典进行修改。
my_dict = {'a': 1, 'b': 2, 'c': 3, 'd': 4}
keys_to_delete = []

# 遍历键的副本,收集要删除的键
for key in list(my_dict.keys()): # 或者 my_dict.copy().keys()
    if my_dict[key] % 2 == 0:
        keys_to_delete.append(key)

for key in keys_to_delete:
    del my_dict[key]

print(f"修改后的字典 (删除偶数值): {my_dict}") # 输出: {'a': 1, 'c': 3}
或者,如果你想修改值:
my_dict = {'a': 1, 'b': 2, 'c': 3}
new_values = {} # 或者直接在原字典上操作,但要遍历副本

# 遍历副本,然后修改原字典
for key in list(my_dict.keys()):
    if key == 'b':
        my_dict[key] = 20
    else:
        my_dict[key] *= 10

print(f"修改后的字典 (更新值): {my_dict}") # 输出: {'a': 10, 'b': 20, 'c': 30}
2. 构建一个新字典:
这通常是最安全、最“Pythonic”的方式,尤其当你需要基于旧字典的内容创建一个新字典时。
original_dict = {'a': 1, 'b': 2, 'c': 3, 'd': 4}
filtered_dict = {}

for key, value in original_dict.items():
    if value % 2 != 0: # 只保留奇数值的键值对
        filtered_dict[key] = value

print(f"通过构建新字典过滤: {filtered_dict}") # 输出: {'a': 1, 'c': 3}
这种方法尤其适合进行过滤、转换或映射操作。它避免了所有关于运行时修改的复杂性,代码也通常更简洁。
我个人在遇到需要修改字典的情况时,如果改动不复杂,会倾向于收集键/值,然后一次性操作。但如果涉及复杂的过滤或转换逻辑,直接构建一个新字典会让我感觉更安心,也更符合函数式编程的思路。
Python字典遍历有哪些高级技巧或不常见用法?
除了基础的遍历方式,Python还提供了一些更高级或更简洁的技巧来处理字典遍历,这些方法能让你的代码更富有表现力,也更高效。
1. 字典推导式 (Dictionary Comprehensions)
这是我个人非常喜欢的一个特性,它能以一种非常紧凑的方式创建新的字典。如果你需要基于现有字典的键值对进行过滤、转换或映射来生成另一个字典,字典推导式是首选。
original_dict = {'a': 1, 'b': 2, 'c': 3, 'd': 4}

# 示例1: 过滤,只保留值大于2的键值对
filtered_dict = {k: v for k, v in original_dict.items() if v > 2}
print(f"过滤后的字典: {filtered_dict}") # 输出: {'c': 3, 'd': 4}

# 示例2: 转换,将所有值翻倍
doubled_dict = {k: v * 2 for k, v in original_dict.items()}
print(f"值翻倍的字典: {doubled_dict}") # 输出: {'a': 2, 'b': 4, 'c': 6, 'd': 8}

# 示例3: 键值互换 (假设值唯一且可哈希)
inverted_dict = {v: k for k, v in original_dict.items()}
print(f"键值互换的字典: {inverted_dict}") # 输出: {1: 'a', 2: 'b', 3: 'c', 4: 'd'}
字典推导式不仅代码量少,而且通常比传统的 for 循环加 if 条件创建新字典要快。它是一种非常“Pythonic”的表达方式。
2. 结合 sorted() 进行有序遍历
字典本身是无序的(在Python 3.7+版本中,字典会保留插入顺序,但这不代表它们是“排序”的)。如果你需要按键的字母顺序或数值大小进行遍历,可以先对键进行排序。
my_dict = {'apple': 3, 'orange': 1, 'banana': 2}

print("\n--- 按键排序遍历 ---")
for key in sorted(my_dict.keys()): # 默认升序
    print(f"{key}: {my_dict[key]}")
# 输出:
# apple: 3
# banana: 2
# orange: 1

print("\n--- 按值排序遍历 (不常见但有用) ---")
# 使用 lambda 表达式指定排序的 key
for key in sorted(my_dict, key=my_dict.get, reverse=True): # 按值降序
    print(f"{key}: {my_dict[key]}")
# 输出:
# apple: 3
# banana: 2
# orange: 1
这里 sorted(my_dict, key=my_dict.get) 是一个非常巧妙的用法,它告诉 sorted 函数在排序时,不是直接比较键本身,而是比较每个键对应的值。这在很多数据分析和展示场景中非常实用。
3. 使用 collections.ChainMap 遍历多个字典
如果你有多个字典,想把它们当作一个单一的逻辑字典来遍历,而又不想实际合并它们(因为合并可能涉及键冲突和性能开销),collections.ChainMap 是一个非常优雅的解决方案。
from collections import ChainMap

dict1 = {'a': 1, 'b': 2}
dict2 = {'b': 20, 'c': 3} # 注意 'b' 在两个字典中都存在
dict3 = {'d': 4}

combined_dict = ChainMap(dict1, dict2, dict3)

print("\n--- 使用 ChainMap 遍历多个字典 ---")
for key, value in combined_dict.items():
    print(f"{key}: {value}")
# 输出 (注意 'b' 的值来自第一个字典 dict1):
# b: 2
# c: 3
# a: 1
# d: 4
ChainMap 会从左到右查找键,一旦找到就返回第一个匹配的值。这对于配置管理、多层上下文查找等场景非常有用,它提供了一种“视图”上的合并,而不是物理上的合并。
这些高级技巧和不常见用法,在特定场景下能大大提升代码的简洁性和效率。我发现,一旦你掌握了字典推导式,就很难再回到传统的 for 循环去构建新字典了,因为它实在是太方便了。
遇到 Visual Studio 安装被拦截?本文指导您如何区分 Defender 与第三方杀毒软件的告警,验证文件数字签名,并在必要时联系管理员或提交日志,避免盲目关闭防护导致安全风险。
详解 Visual Studio 2022 安装因网络中断失败后的处理流程,包括安装器重试、实例修复及本地布局创建方法,帮助开发者高效解决安装问题。
详解 Visual Studio 2019 中正则表达式查找替换技巧,包括 Ctrl+H 与 Ctrl+Shift+H 的使用区别、捕获组语法 $1 与 \1 的应用,以及批量替换前的结果审阅策略,帮助开发者安全高效地重构代码。
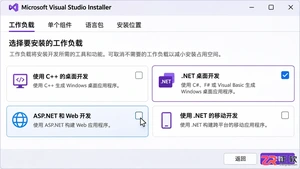
详解 Visual Studio 2026 安装时如何选择必要的工作负载与组件以节省空间,以及如何通过 Installer 修改已安装实例的配置,同时澄清安装目录迁移的限制。

详细指南:通过微软官方引导程序创建 Visual Studio 2019 离线安装包,适用于网络受限或多机部署场景,涵盖布局创建、参数配置及离线安装流程。

在Windows 10上安装Visual Studio 2019前,需确认系统架构、版本支持状态、内存磁盘空间及管理员权限。本文依据微软官方要求,指导用户完成环境自查与准备工作。

详细讲解 Visual Studio 2022 自带的文件比较功能,包括如何选中文件、启动比较、阅读并排差异视图、切换内联模式以及确认改动的最佳实践,帮助开发者高效检查代码变更。
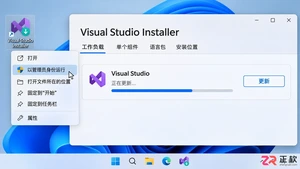
解决 Visual Studio 2022 安装时 UAC 权限不足问题,包括正确使用管理员权限启动安装程序、确认账户类型以及应对组织策略限制的建议。
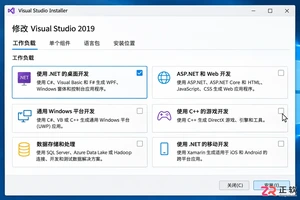
掌握 Visual Studio 2019 安装技巧,通过工作负载和单个组件的合理选择,避免安装冗余工具,提升开发效率。
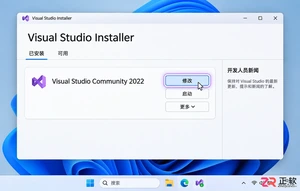
了解 Visual Studio 2022 安装移动开发组件时的空间占用逻辑。掌握如何根据实际需求勾选工作负载,利用安装器估算功能,管理下载缓存以优化磁盘空间使用。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



