

Python抓取技巧:同名类标签精准筛选方法
本文详细介绍了如何利用Python的requests和BeautifulSoup库进行网页数据抓取,特别是当网页中存在多个具有相同HTML类名的元素时,如何精确筛选出所需信息。文章着重演示了如何通过高级CSS选择器,例如:-soup-contains(),来排除不符合条件的数据(如“在线视频咨询”),从而实现高效且准确的数据提取。

网页数据抓取中的常见挑战
在进行网页数据抓取(Web Scraping)时,开发者经常会遇到一个普遍的问题:网页上的不同类型的信息可能被包裹在具有相同HTML类名(class name)的标签中。例如,一个医生可能有多个执业地点,包括实体医院和在线咨询服务,而这些地点信息可能都使用相同的
工具准备
要解决上述问题,我们将使用Python中两个强大的库:
- requests: 用于向目标网站发送HTTP请求,获取网页的HTML内容。
- BeautifulSoup: 一个解析HTML和XML文档的库,能够方便地从复杂结构中提取数据。
在开始之前,请确保已安装这些库:
pip install requests beautifulsoup4
核心问题:同名类标签与数据筛选
假设我们正在抓取医生信息,每个医生可能在多个地点提供服务。这些地点(无论是实体医院还是在线咨询)都可能使用相同的CSS类名(例如listing-locations)。我们的目标是只获取医生提供的实体医院服务地点,并忽略任何“在线视频咨询”的地点。
解决方案详解
解决此问题的关键在于利用BeautifulSoup提供的强大CSS选择器功能,特别是:-soup-contains()伪类选择器,它允许我们根据元素内包含的文本内容进行筛选。
1. 获取网页内容
首先,我们需要使用requests库获取目标网页的HTML内容。
import requests
from bs4 import BeautifulSoup

url = "https://oladoc.com/pakistan/lahore/gynecologist"
# 发送GET请求并获取响应
response = requests.get(url)
# 检查请求是否成功
response.raise_for_status()
# 使用BeautifulSoup解析HTML内容
soup = BeautifulSoup(response.content, "html.parser")
2. 定位医生信息
通常,网页上的每个独立信息块(例如,每个医生的完整信息)都会被一个特定的HTML元素包裹。我们需要找到这些主要的容器。根据示例,每个医生的信息都包含在class="gynecologist"的元素中。
# 遍历所有医生信息块
for g in soup.select(".gynecologist"):
    # 提取医生姓名
    doctor_name = g.h2.get_text(strip=True)
    print("姓名:", doctor_name)

    # ... 接下来是提取地点信息
3. 精确筛选医院位置
这是解决问题的核心步骤。我们需要选择所有具有listing-locations类的元素,但同时排除那些文本内容包含“Online Video Consultation”的元素。BeautifulSoup的select()方法支持复杂的CSS选择器,包括:-soup-contains()。
- listing-locations: 选择所有class为listing-locations的元素。
- :-soup-contains('Online Video Consultation'): 选择包含特定文本“Online Video Consultation”的元素。
- :not(...): 否定选择器,排除括号内匹配的元素。
结合起来,".listing-locations:not(:-soup-contains('Online Video Consultation'))"将选择所有class为listing-locations,但不包含“Online Video Consultation”文本的元素。
    # 筛选医院地点:选择所有class为listing-locations,且不包含“Online Video Consultation”文本的元素
    hospitals = g.select(
        ".listing-locations:not(:-soup-contains('Online Video Consultation'))"
    )

    # 提取每个筛选出的医院名称
    hospital_names = [h.span.text.strip() for h in hospitals]
    print("医院:", hospital_names)
    print("-" * 30) # 分隔线,使输出更清晰
4. 完整代码示例
将以上步骤整合,得到完整的Python抓取脚本:
import requests
from bs4 import BeautifulSoup

# 目标URL
url = "https://oladoc.com/pakistan/lahore/gynecologist"

try:
    # 发送GET请求并获取网页内容
    response = requests.get(url)
    response.raise_for_status()  # 检查请求是否成功,如果状态码不是200,则抛出异常

    # 使用BeautifulSoup解析HTML
    soup = BeautifulSoup(response.content, "html.parser")

    # 遍历页面上所有的医生信息块
    for g in soup.select(".gynecologist"):
        # 提取医生姓名
        doctor_name = g.h2.get_text(strip=True)
        print("姓名:", doctor_name)

        # 筛选医院地点:
        # 选择所有class为"listing-locations"的元素,
        # 但排除那些内部文本包含"Online Video Consultation"的元素。
        hospitals = g.select(
            ".listing-locations:not(:-soup-contains('Online Video Consultation'))"
        )

        # 提取每个筛选出的医院名称,并去除首尾空白
        hospital_names = [h.span.text.strip() for h in hospitals]
        print("医院:", hospital_names)
        print("-" * 40) # 打印分隔线

except requests.exceptions.RequestException as e:
    print(f"请求失败: {e}")
except Exception as e:
    print(f"发生错误: {e}")
输出示例:
姓名: Dr. Ayesha Azam Khan
医院: ['National Hospital & Medical Centre  (DHA)', 'Surgimed Hospital (Gulberg)']
----------------------------------------
姓名: Dr. Maliha Amjad
医院: ['Omar Hospital & Cardiac Centre (Johar Town) (Johar Town)', 'Shalamar Hospital (Mughalpura)']
----------------------------------------
姓名: Dr. Sara Rasul
医院: ['Hameed Latif Hospital (New Garden Town)', 'Hameed Latif Medical Center (DHA)']
----------------------------------------
# ... 更多医生信息
注意事项
- 网页结构变化: 网页的HTML结构可能会随时更新。如果目标网站的HTML类名、标签结构或文本内容发生变化,上述CSS选择器可能需要调整。
- 伦理与法律: 在进行网页抓取时,请务必遵守网站的robots.txt协议和使用条款。避免对网站造成过大负载,可以设置请求间隔(time.sleep())。
- 错误处理: 在实际项目中,应加入更健壮的错误处理机制,例如处理网络连接问题、页面元素不存在的情况等。上述代码已加入基本的try-except块。
- 进一步筛选: 如果您严格要求每个医生只获取一个地点(例如,只取第一个物理地点),可以在hospital_names列表不为空的情况下,进一步选择hospital_names[0]。
- 代理与用户代理: 对于某些网站,可能需要设置请求头(User-Agent)或使用代理IP来避免被反爬机制阻止。
总结
通过本教程,我们学习了如何利用Python的requests和BeautifulSoup库,结合强大的CSS选择器(特别是:-soup-contains()和:not()),有效地处理网页抓取中同名类标签的挑战。这种方法不仅能够精确地筛选出所需数据,还能排除不必要或干扰性的信息,从而提高数据抓取的准确性和效率。掌握这些技巧,将使您在面对复杂网页结构时更加游刃有余。
遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。
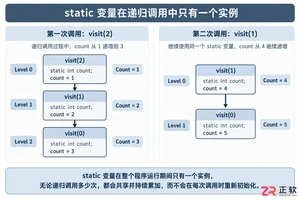
本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。
解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
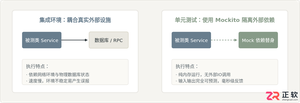
详细讲解在Java单元测试中如何使用Mockito模拟依赖对象,包括引入依赖、创建Mock、打桩返回值、行为验证以及Mock与Spy的核心差异和常见陷阱排查。

详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。

想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。

通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。

本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。

详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。

详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。