

实时获取Python播放MP3的振幅数据
本文详细介绍了如何在Python中实时获取正在播放的MP3文件的振幅值,尤其适用于树莓派等嵌入式设备。文章首先解释了使用PyAudio库处理WAV音频流的基础,包括如何读取和播放音频数据并从中计算振幅。接着,引入pydub库解决MP3文件处理问题,实现MP3到WAV的内存转换。最后,将两者整合,提供了一个完整的解决方案,使您能够在播放MP3的同时监控其振幅,并讨论了相关注意事项。

1. 理解挑战:为什么直接获取MP3振幅困难?
在Python中,使用pygame.mixer等高级库播放MP3文件时,通常只提供了播放控制接口,而没有直接暴露底层音频数据的实时访问权限,这使得在播放过程中获取当前振幅变得困难。特别是在资源有限的树莓派上,我们需要一种既能播放MP3又能实时处理其音频数据的方法。解决方案在于绕过高级播放器,直接通过低级音频I/O库来处理音频流,并结合音频转换工具来应对MP3格式。
2. 核心概念:使用 PyAudio 进行音频流处理
PyAudio是一个Python库,提供了对PortAudio库的绑定,允许您在Python中进行音频输入和输出。它能够直接与声卡交互,读取或写入音频数据流。虽然PyAudio本身不支持MP3格式,但它非常适合处理原始PCM(脉冲编码调制)数据,例如WAV文件中的数据。
2.1 WAV 文件播放与数据读取
WAV文件通常包含未压缩的PCM音频数据,这使得它们可以直接被PyAudio处理。我们可以逐块读取WAV文件的数据,并将其写入PyAudio的输出流进行播放。在读取每个数据块时,我们就可以对其进行分析以获取振幅信息。
以下是一个基本的示例,展示如何使用PyAudio播放WAV文件并计算每个数据块的峰值振幅:
import pyaudio
import wave
import struct
import numpy as np # 用于更复杂的振幅计算,这里仅作示例

def calculate_peak_amplitude(audio_bytes, sample_width):
    """
    从音频字节数据中计算峰值振幅。
    假设为16位有符号整数样本。
    """
    if not audio_bytes:
        return 0

    if sample_width == 2:  # 16-bit samples
        # 'h' 表示有符号短整型 (2字节)
        # len(audio_bytes) // sample_width 得到样本数量
        num_samples = len(audio_bytes) // sample_width
        try:
            samples = struct.unpack(f"{num_samples}h", audio_bytes)
            # 计算绝对峰值振幅
            if samples:
                return max(abs(s) for s in samples)
        except struct.error:
            # 数据可能不完整,或格式不匹配
            return 0
    # 可以根据需要添加其他采样宽度的处理
    return 0

def play_wav_and_get_amplitude(wav_file_path):
    """
    播放WAV文件并实时获取振幅。
    """
    chunk_size = 1024  # 每次读取的音频帧数
    audio = pyaudio.PyAudio()
    maximal_amplitude = 0 # 记录播放过程中的最大振幅

    try:
        wf = wave.open(wav_file_path, 'rb')

        # 打开PyAudio流
        stream = audio.open(format=audio.get_format_from_width(wf.getsampwidth()),
                            channels=wf.getnchannels(),
                            rate=wf.getframerate(),
                            output=True)

        data = wf.readframes(chunk_size)
        print(f"开始播放:{wav_file_path}")
        print("实时振幅 (峰值):")

        while data:
            # 写入流,实际播放声音
            stream.write(data)

            # 计算当前数据块的振幅
            current_amplitude = calculate_peak_amplitude(data, wf.getsampwidth())
            if current_amplitude > maximal_amplitude:
                maximal_amplitude = current_amplitude

            # 简单的振幅显示 (例如,用星号表示)
            # 假设最大振幅范围为32767 (16位有符号整数)
            display_scale = 50
            scaled_amp = int(current_amplitude / 32767 * display_scale)
            scaled_max_amp = int(maximal_amplitude / 32767 * display_scale)
            print(f"[{'#' * scaled_amp}{'-' * (display_scale - scaled_amp)}] 当前: {current_amplitude:<5} 最大: {maximal_amplitude:<5}", end='\r')

            data = wf.readframes(chunk_size)

        print("\n播放结束。")

    except FileNotFoundError:
        print(f"错误:文件未找到 - {wav_file_path}")
    except Exception as e:
        print(f"发生错误:{e}")
    finally:
        if 'stream' in locals() and stream.is_active():
            stream.stop_stream()
            stream.close()
        if 'audio' in locals():
            audio.terminate()
        if 'wf' in locals():
            wf.close()

# 示例用法 (需要一个名为 'example.wav' 的WAV文件)
# play_wav_and_get_amplitude("example.wav")
2.2 振幅计算方法
在calculate_peak_amplitude函数中,我们使用了简单的峰值振幅计算。对于16位有符号整数样本,其值范围通常是-32768到32767。峰值振幅就是数据块中所有样本绝对值的最大值。
除了峰值振幅,还可以计算:
- RMS(均方根)振幅:它更能代表声音的平均能量,通常比峰值振幅更能反映人耳感知的响度。RMS振幅的计算涉及对样本值进行平方、求平均、再开方。这通常需要将字节数据转换为数值数组(例如使用numpy)来高效处理。
- VU表(Volume Unit Meter):更专业的音频电平显示,通常会涉及更复杂的信号处理,如平滑、对数刻度显示等。
3. 处理 MP3 文件:Pydub 的应用
由于PyAudio不直接支持MP3,我们需要将MP3文件转换为WAV格式。为了避免在磁盘上创建临时文件,我们可以使用pydub库将MP3文件转换为WAV格式的字节流,并将其存储在内存中(使用io.BytesIO),然后wave模块可以从这个内存流中读取。
3.1 MP3 到 WAV 的内存转换
pydub是一个非常强大的音频处理库,它依赖于ffmpeg或libav。它可以轻松地在各种音频格式之间进行转换。
首先,确保安装了pydub和ffmpeg(或libav)。
pip install pydub
# 在Debian/Ubuntu上安装ffmpeg:
sudo apt-get update
sudo apt-get install ffmpeg
以下是如何使用pydub将MP3转换为内存中的WAV流:
from pydub import AudioSegment
import io

def convert_mp3_to_wav_in_memory(mp3_file_path):
    """
    将MP3文件转换为WAV格式的字节流(在内存中)。
    返回一个BytesIO对象,其中包含WAV数据。
    """
    try:
        sound = AudioSegment.from_mp3(mp3_file_path)
        wav_buffer = io.BytesIO()
        sound.export(wav_buffer, format="wav")
        wav_buffer.seek(0)  # 将缓冲区指针重置到开头
        return wav_buffer, sound.sample_width, sound.channels, sound.frame_rate
    except FileNotFoundError:
        raise FileNotFoundError(f"MP3文件未找到: {mp3_file_path}")
    except Exception as e:
        raise Exception(f"MP3转换失败: {e}")

# 示例用法
# wav_buffer, sample_width, channels, frame_rate = convert_mp3_to_wav_in_memory("kimi_no_shiranai.mp3")
# 现在 wav_buffer 可以被 wave.open() 使用
4. 整合:实时播放 MP3 并获取振幅
现在,我们将PyAudio的音频流处理能力与pydub的MP3转换能力结合起来,实现一个完整的解决方案。
import pyaudio
import wave
import struct
from pydub import AudioSegment
import io
import time # 用于暂停,模拟其他操作

def calculate_peak_amplitude(audio_bytes, sample_width):
    """
    从音频字节数据中计算峰值振幅。
    假设为16位有符号整数样本。
    """
    if not audio_bytes:
        return 0

    if sample_width == 2:  # 16-bit samples
        num_samples = len(audio_bytes) // sample_width
        try:
            samples = struct.unpack(f"{num_samples}h", audio_bytes)
            if samples:
                return max(abs(s) for s in samples)
        except struct.error:
            return 0
    return 0

def convert_mp3_to_wav_in_memory(mp3_file_path):
    """
    将MP3文件转换为WAV格式的字节流(在内存中)。
    返回一个BytesIO对象,其中包含WAV数据,以及音频参数。
    """
    try:
        sound = AudioSegment.from_mp3(mp3_file_path)
        wav_buffer = io.BytesIO()
        sound.export(wav_buffer, format="wav")
        wav_buffer.seek(0)  # 将缓冲区指针重置到开头
        return wav_buffer, sound.sample_width, sound.channels, sound.frame_rate
    except FileNotFoundError:
        raise FileNotFoundError(f"MP3文件未找到: {mp3_file_path}")
    except Exception as e:
        raise Exception(f"MP3转换失败: {e}")

def play_mp3_and_get_amplitude(mp3_file_path):
    """
    播放MP3文件并实时获取振幅。
    """
    chunk_size = 1024  # 每次读取的音频帧数
    audio = pyaudio.PyAudio()
    maximal_amplitude = 0 # 记录播放过程中的最大振幅

    try:
        # 1. 将MP3转换为内存中的WAV流
        wav_buffer, sample_width, channels, rate = convert_mp3_to_wav_in_memory(mp3_file_path)
        wf = wave.open(wav_buffer, 'rb') # 从内存缓冲区打开WAV文件

        # 2. 打开PyAudio流
        stream = audio.open(format=audio.get_format_from_width(sample_width),
                            channels=channels,
                            rate=rate,
                            output=True)

        data = wf.readframes(chunk_size)
        print(f"开始播放:{mp3_file_path}")
        print("实时振幅 (峰值):")

        while data:
            # 写入流,实际播放声音
            stream.write(data)

            # 计算当前数据块的振幅
            current_amplitude = calculate_peak_amplitude(data, sample_width)
            if current_amplitude > maximal_amplitude:
                maximal_amplitude = current_amplitude

            # 简单的振幅显示 (例如,用星号表示)
            # 假设最大振幅范围为32767 (16位有符号整数)
            display_scale = 50
            scaled_amp = int(current_amplitude / 32767 * display_scale)
            scaled_max_amp = int(maximal_amplitude / 32767 * display_scale)
            print(f"[{'#' * scaled_amp}{'-' * (display_scale - scaled_amp)}] 当前: {current_amplitude:<5} 最大: {maximal_amplitude:<5}", end='\r')

            data = wf.readframes(chunk_size)
            # 可以在这里添加其他需要与播放同步的操作
            # 例如,更新UI,控制LED等

        print("\n播放结束。")

    except FileNotFoundError as e:
        print(f"错误:{e}")
    except Exception as e:
        print(f"发生错误:{e}")
    finally:
        if 'stream' in locals() and stream.is_active():
            stream.stop_stream()
            stream.close()
        if 'audio' in locals():
            audio.terminate()
        if 'wf' in locals():
            wf.close()
        if 'wav_buffer' in locals():
            wav_buffer.close()

# 示例用法 (请替换为您的MP3文件路径)
if __name__ == "__main__":
    # 请确保您有一个名为 'your_sound.mp3' 的MP3文件在同一目录下
    # 或者提供完整路径
    mp3_file = "your_sound.mp3"
    play_mp3_and_get_amplitude(mp3_file)
5. 注意事项与性能优化
- 树莓派上的性能考量:
- CPU使用率:MP3到WAV的实时转换和音频数据处理都会消耗CPU资源。对于较长的MP3文件,pydub的转换可能在开始时有一定延迟。如果CPU负载过高,可能会导致音频卡顿。
- 内存使用:将整个MP3文件转换为WAV并存储在BytesIO中会占用内存。对于非常大的文件,这可能会成为问题。可以考虑分块转换或流式处理,但这会增加代码复杂性。
- 优化:如果性能是关键,可以考虑预先将MP3文件转换为WAV文件存储在磁盘上,然后直接播放WAV文件。或者,使用更底层的音频库(如C语言编写的库)来提高效率。
- 振幅计算方法:
- 本教程使用的是简单的峰值振幅。对于更精确或更具视觉吸引力的振幅显示(如VU表),您可能需要实现RMS振幅计算、对数刻度转换、以及平滑算法。
- 参考vu-meter项目(如原始答案中提到的GitHub链接)可以获得更专业的实现思路。
- 依赖安装:
- 确保已安装pyaudio和pydub。pyaudio在某些系统上安装可能需要portaudio开发库。
- pip install pyaudio pydub
- 对于Debian/Ubuntu系统,可能需要sudo apt-get install portaudio19-dev。
- ffmpeg是pydub的后端,也需要正确安装。
- 确保已安装pyaudio和pydub。pyaudio在某些系统上安装可能需要portaudio开发库。
- 错误处理:
- 代码中包含了基本的文件未找到和通用异常处理。在生产环境中,应增加更健尽的错误处理机制。
- 同步问题:
- PyAudio的stream.write(data)是阻塞的,它会等待数据被声卡处理完毕。这意味着振幅计算和任何其他逻辑将与音频播放同步进行,不会出现不同步的问题。
6. 总结
通过结合pydub进行MP3到WAV的内存转换,以及PyAudio进行低级音频流处理和振幅分析,我们成功地实现了在Python中实时播放MP3并获取其振幅的功能。这种方法绕过了高级播放器对底层数据访问的限制,为开发者提供了更大的灵活性。虽然在树莓派等嵌入式设备上需要注意性能和资源消耗,但通过合理的优化和选择合适的振幅计算方法,可以构建出功能强大且响应迅速的音频可视化或交互系统。
Cursor新增实时语音对话,支持在Agent运行任务时交流并听取进度,覆盖Agents Window、IDE、网页端与iOS,语音通话需登录账号并开启麦克风权限。
VS Code 1.145新增本地Cron调度,扩展远程Agent预览能力;后续1.145.1与1.145.2修正遥测归属和事件路由。文中区分正式、预览及实验性功能。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
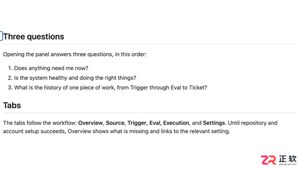
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
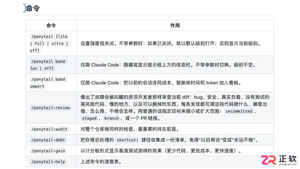
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
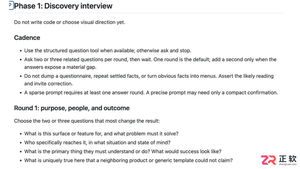
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
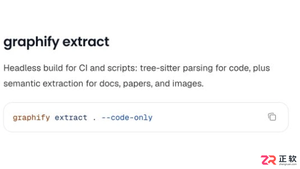
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
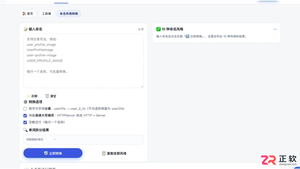
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
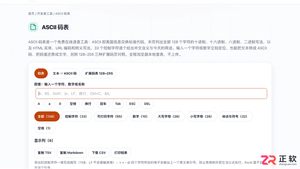
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



