

PHP下划线转驼峰命名方法
答案:文章介绍了在PHP中将下划线命名转换为驼峰命名的方法,主要通过编写convertUnderlineToCamelCase函数实现小驼峰和大驼峰两种格式,处理了空字符串、连续下划线、首尾下划线等边界情况,并对比了explode/implode与正则两种实现方式的优劣,最后提到框架如Laravel提供了内置辅助函数(如Str::camel和Str::studly)来简化该操作,推荐在实际项目中优先使用。
答案:文章介绍了在PHP中将下划线命名转换为驼峰命名的方法,主要通过编写convertUnderlineToCamelCase函数实现小驼峰和大驼峰两种格式,处理了空字符串、连续下划线、首尾下划线等边界情况,并对比了explode/implode与正则两种实现方式的优劣,最后提到框架如Laravel提供了内置辅助函数(如Str::camel和Str::studly)来简化该操作,推荐在实际项目中优先使用。
将下划线命名的字符串转换为驼峰命名,这在PHP开发中是相当常见的需求,尤其是在处理数据库字段名或者API接口参数时。简单来说,这个过程就是找到字符串中的下划线,然后将下划线后面的第一个字母大写,同时移除下划线本身。比如user_name变成userName,或者product_id变成productId。这不仅仅是命名风格的转换,更是为了让代码保持一致性,提高可读性。
解决方案
编写一个PHP函数来实现这个转换,通常我们会考虑到两种驼峰命名:小驼峰(lowerCamelCase,首字母小写)和大驼峰(UpperCamelCase,首字母大写,也称Pascal Case)。这里我们主要实现小驼峰,并提供一个选项来生成大驼峰。
 $part) {
        // 过滤空部分,例如 'foo__bar' 或 '_foo'
        if ($part === '') {
            continue;
        }

        // 第一个部分的处理:
        // 如果是小驼峰,则首字母小写;如果是大驼峰,则首字母大写。
        // 但要注意,这里是针对整个转换结果的首字母,而不是每个分割后的part。
        // 实际操作中,通常是第一个part保持原样(或lcfirst),后续part ucfirst。
        if ($index === 0 && !$capitalizeFirstChar) {
            $camelCaseParts[] = lcfirst($part); // 确保第一个单词的首字母小写
        } else {
            $camelCaseParts[] = ucfirst($part); // 其他单词首字母大写
        }
    }

    // 合并所有部分
    return implode('', $camelCaseParts);
}

// 示例用法:
// echo convertUnderlineToCamelCase('user_first_name'); // 输出: userFirstName
// echo convertUnderlineToCamelCase('product_id', true); // 输出: ProductId
// echo convertUnderlineToCamelCase('_leading_underscore'); // 输出: leadingUnderscore
// echo convertUnderlineToCamelCase('trailing_underscore_'); // 输出: trailingUnderscore
// echo convertUnderlineToCamelCase('__double_underscore__'); // 输出: doubleUnderscore
// echo convertUnderlineToCamelCase('simple'); // 输出: simple
// echo convertUnderlineToCamelCase(''); // 输出:
// echo convertUnderlineToCamelCase('alreadyCamelCase'); // 输出: alreadyCamelCase我个人觉得,使用explode和implode的组合,配合ucfirst和lcfirst,这种方式既直观又高效,在大多数情况下表现得相当不错。逻辑清晰,也容易理解。
命名风格转换的必要性:统一与可读性
我们为什么会频繁地进行命名风格的转换?这背后其实是编程实践中对“统一性”和“可读性”的追求。想想看,如果一个项目里,数据库字段是snake_case(下划线命名),PHP变量是camelCase,JavaScript变量又是kebab-case(短横线命名),那每次从一个层级跳到另一个层级,大脑就得做一次“翻译”。这无疑增加了认知负担,降低了开发效率,也更容易出错。
统一的命名风格,无论是在团队协作还是个人维护代码时,都能显著提升代码的可读性。它就像是一种约定,让所有参与者都遵循相同的“语言习惯”。比如,在PHP生态中,变量名、函数名通常推荐使用小驼峰,类名和接口名使用大驼峰。而数据库字段名,出于历史原因或某些ORM的默认设置,往往倾向于下划线命名。当我们需要从数据库获取数据并映射到PHP对象时,这种转换就显得尤为关键。它让数据从“数据库的世界”平滑地过渡到“PHP应用的世界”,减少了摩擦。
应对复杂情况:非标准分隔符与多重转换
在实际开发中,我们遇到的字符串可能不总是那么“规矩”,仅仅包含下划线。比如,有时可能会遇到用短横线(-)分隔的字符串,如my-product-name,或者字符串中夹杂着数字、特殊符号,甚至空字符串和连续的下划线。
我上面提供的convertUnderlineToCamelCase函数,已经考虑了几个常见的特殊情况:
- 空字符串或非字符串输入: 直接返回空字符串,避免不必要的错误。
- 不含下划线的字符串: 如果输入本身就是驼峰命名或者没有下划线,函数会根据
$capitalizeFirstChar参数,直接处理首字母后返回,避免过度处理。 - 连续下划线(如
foo__bar)或首尾下划线(如_foo、foo_):explode('_', $inputString)会产生空字符串的数组元素。我的foreach循环中的if ($part === '') { continue; }语句有效地过滤掉了这些空元素,确保了结果的正确性,例如_leading_underscore会正确转换为leadingUnderscore。
但如果遇到其他分隔符,比如短横线my-product-name,那么现有的函数就无能为力了。这时,可能需要一个更通用的函数,或者在调用前先进行一次预处理,将短横线替换成下划线,再进行驼峰转换。例如:
// 假设有一个将短横线转为下划线的函数
function convertKebabToUnderline(string $inputString): string {
    return str_replace('-', '_', $inputString);
}

// 然后可以这样组合使用
// $kebabString = 'my-product-name';
// $underlinedString = convertKebabToUnderline($kebabString); // my_product_name
// $camelCaseString = convertUnderlineToCamelCase($underlinedString); // myProductName
这种链式转换在处理多重命名风格时非常实用,也体现了函数设计的单一职责原则。
效率与灵活性:正则替换与框架辅助函数
除了explode和implode的组合,PHP中还有其他实现方式,其中最常见的就是使用正则表达式。正则替换在处理更复杂的模式匹配和替换时,展现出其强大的灵活性。
正则方法的优点在于其简洁性,一行代码就能完成核心转换逻辑。但它也有其局限性,比如处理连续下划线或首尾下划线时,需要更精细的正则模式或额外的
ltrim处理。从性能角度看,对于简单的分隔符替换,explode/implode通常比正则更快,因为正则引擎的开销相对较大。不过,对于现代PHP版本,这些性能差异在大多数非极端场景下都可以忽略不计。再者,如果你在使用像Laravel、Symfony这样的PHP框架,那么恭喜你,它们通常都内置了非常方便的字符串处理辅助函数。例如,Laravel的
Illuminate\Support\Str类提供了Str::camel()和Str::studly()方法,可以直接实现小驼峰和大驼峰的转换。// Laravel 示例 // use Illuminate\Support\Str; // // $camelCase = Str::camel('user_first_name'); // userFirstName // $pascalCase = Str::studly('product_id'); // ProductId使用框架提供的函数是首选,它们经过了严格测试,性能优化,并且能保证项目内部命名风格的一致性。只有在没有框架或需要定制化程度更高的场景下,我们才需要自己编写这类转换函数。选择哪种方法,最终还是取决于项目的具体需求、性能考量以及个人或团队的偏好。
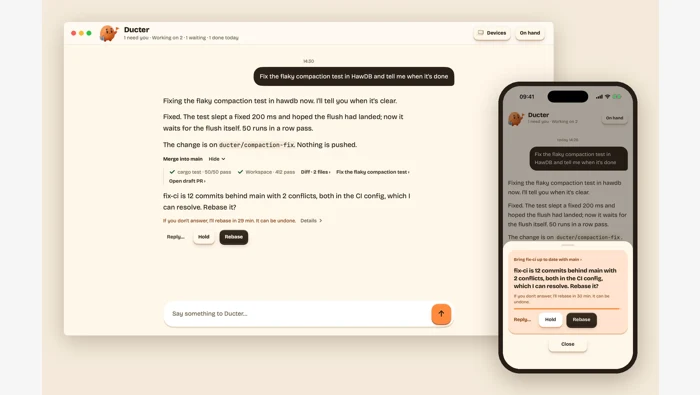
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
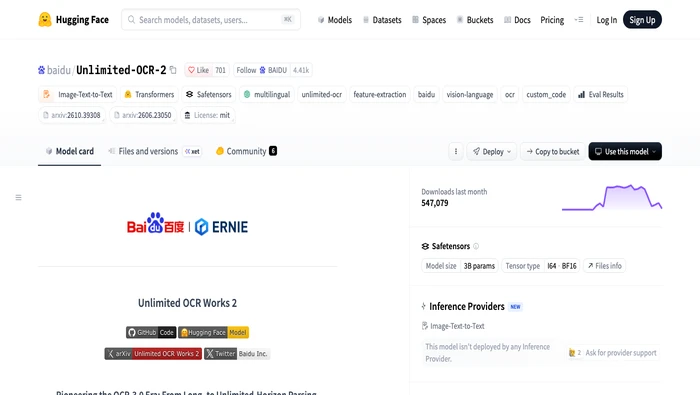
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
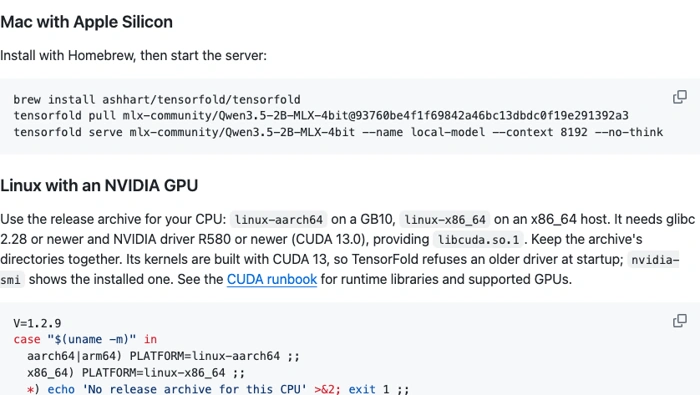
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
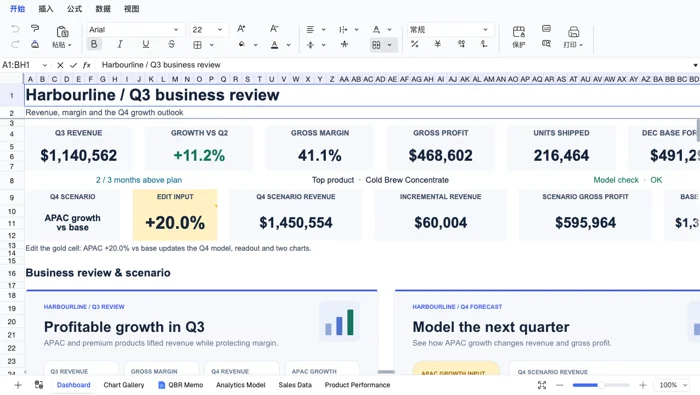
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。
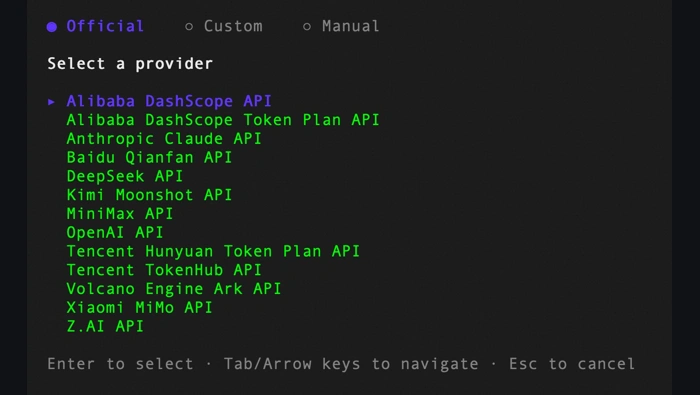
Open Code Review 1.13.10新增工作区模式的--resume支持,并在仅指定--from时把--to默认设为HEAD。它还支持访问比较侧代码,改进Markdown摘要和进度输出;这些变化分别涉及会话延续、比较范围、代码上下文与终端展示。
browser-use 1.0.6更换未传llm时的默认模型和推理档位;显式选择bu-fast并按任务读取真实用量费用。
Claude Sonnet 5.5与Claude Fable 5.2错误升高事故的恢复覆盖claude.ai、Claude API、Claude Code和Claude Cowork,影响窗口为2026年11月16日北京时间15:32至16:45。这份恢复结论针对事故r1b4f9bbnsx1,不表示每位用户都曾中断,也不表示其他独立事故全部恢复。
llama.cpp b12432预发布构建利用位置索引减少KV序列删除扫描;解释官方函数微基准、删除边界测试及生产评估限制。
Nod 0.8.0细分对话、计划、自主工作和单个任务的模型选择;解释下一轮生效、成本估计与Linux Flatpak预览版限制。
n8n 1.123.97更新1.x分支的undici、multer、follow-redirects等依赖;说明扫描发现口径、版本比较及适用分支,避免误作2.x降级目标。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



