

C++如何返回结构体对象及返回优化作用
C++中函数返回结构体最推荐的方式是按值返回,现代编译器通过返回值优化(RVO/NRVO)消除拷贝开销,直接在目标位置构造对象;若优化未生效,C++11的移动语义可避免深拷贝;C++17进一步对prvalue返回值实现强制拷贝省略,确保高效性。
C++中函数返回结构体最推荐的方式是按值返回,现代编译器通过返回值优化(RVO/NRVO)消除拷贝开销,直接在目标位置构造对象;若优化未生效,C++11的移动语义可避免深拷贝;C++17进一步对prvalue返回值实现强制拷贝省略,确保高效性。

在C++中,函数返回一个结构体对象最直接、也是现代C++推荐的方式就是按值返回。这听起来可能有点反直觉,因为我们总担心大对象拷贝的开销。但实际上,得益于编译器的“返回值优化”(Return Value Optimization, RVO)以及C++11引入的移动语义,按值返回结构体对象往往是最高效、最简洁的选择,它能有效避免不必要的拷贝,甚至直接在调用者的内存空间构造返回对象。
解决方案
当我们需要一个C++函数生成并返回一个结构体对象时,最直观且现代C++推荐的做法就是直接按值返回该结构体。编译器,尤其是现代的C++编译器,会非常智能地对这种操作进行优化,我们称之为“返回值优化”(RVO)或“具名返回值优化”(NRVO)。
一个简单的例子可能长这样:
#include#include // 定义一个结构体 struct MyData { int id; std::string name; // 构造函数 MyData(int i, std::string n) : id(i), name(std::move(n)) { std::cout << "MyData 构造函数被调用 (id: " << id << ")" << std::endl; } // 拷贝构造函数 (为了观察是否发生拷贝) MyData(const MyData& other) : id(other.id), name(other.name) { std::cout << "MyData 拷贝构造函数被调用 (id: " << id << ")" << std::endl; } // 移动构造函数 (为了观察是否发生移动) MyData(MyData&& other) noexcept : id(other.id), name(std::move(other.name)) { std::cout << "MyData 移动构造函数被调用 (id: " << id << ")" << std::endl; other.id = 0; // 清空源对象,表示资源已被“偷走” } // 析构函数 ~MyData() { std::cout << "MyData 析构函数被调用 (id: " << id << ")" << std::endl; } }; // 函数按值返回一个MyData结构体 MyData createData(int id, const std::string& name_prefix) { std::string full_name = name_prefix + std::to_string(id); MyData temp_data(id, full_name); // 在函数内部创建一个具名局部对象 std::cout << " createData 函数内部,准备返回 temp_data" << std::endl; return temp_data; // 返回这个具名局部对象 } int main() { std::cout << "--- 调用 createData ---" << std::endl; MyData result = createData(101, "User_"); // 接收返回的结构体 std::cout << "--- createData 调用结束 ---" << std::endl; std::cout << "主函数中收到对象: id=" << result.id << ", name=" << result.name << std::endl; std::cout << "--- 主函数结束 ---" << std::endl; return 0; }
当你运行这段代码,在大多数现代编译器(如GCC、Clang,开启优化选项,甚至默认情况下)下,你会发现MyData的拷贝构造函数或移动构造函数并没有被调用。输出可能类似这样:
--- 调用 createData ---
MyData 构造函数被调用 (id: 101)
  createData 函数内部,准备返回 temp_data
--- createData 调用结束 ---
主函数中收到对象: id=101, name=User_101
--- 主函数结束 ---
MyData 析构函数被调用 (id: 101)
这说明,编译器已经将createData函数内部创建的temp_data对象,直接构造到了main函数中result变量所占用的内存位置上,完全避免了中间的拷贝或移动操作。这就是返回值优化的魅力所在。
C++函数返回结构体时,除了直接返回,还有哪些替代方案及各自的优劣?
在C++中,除了我们刚刚讨论的直接按值返回结构体(并依赖RVO/NRVO),确实还有一些其他方式可以“返回”或提供结构体对象。每种方法都有其适用场景和需要权衡的优劣。
1. 通过输出参数(Out Parameter)返回: 这种方式是让调用者提供一个结构体的引用或指针,函数将结果填充到这个外部提供的对象中。
void fillData(int id, const std::string& name_prefix, MyData& out_data) {
    out_data.id = id;
    out_data.name = name_prefix + std::to_string(id);
    std::cout << "  fillData 函数内部,填充 out_data" << std::endl;
}

// 调用示例
MyData result_out;
fillData(102, "Agent_", result_out);- 优点: 避免了任何形式的拷贝或移动(因为对象是在外部创建的),对于不支持RVO或移动语义的旧C++版本,这曾是最高效的方式。调用者对对象的生命周期有完全控制。
- 缺点: 接口语义不够清晰,一眼看去可能不清楚
out_data是输入还是输出。函数签名变得复杂。如果需要返回多个不同类型的对象,输出参数会变得非常多。在现代C++中,这种方式通常不如按值返回结合RVO/移动语义简洁和安全。
2. 返回指向堆上对象的指针或智能指针: 函数在堆上动态分配一个结构体对象,然后返回指向它的指针(裸指针或智能指针)。
// 返回裸指针(不推荐,除非有特殊资源管理需求)
MyData* createDataOnHeap(int id, const std::string& name_prefix) {
    MyData* data = new MyData(id, name_prefix + std::to_string(id));
    std::cout << "  createDataOnHeap 函数内部,创建堆对象" << std::endl;
    return data;
}

// 返回智能指针(推荐)
std::unique_ptr createUniqueData(int id, const std::string& name_prefix) {
    std::cout << "  createUniqueData 函数内部,创建堆对象" << std::endl;
    return std::make_unique(id, name_prefix + std::to_string(id));
}

// 调用示例
// MyData* raw_ptr = createDataOnHeap(103, "Raw_"); // 需要手动 delete raw_ptr; 容易忘记
std::unique_ptr smart_ptr = createUniqueData(104, "Smart_"); - 优点: 允许返回非常大的对象而无需担心栈空间限制。智能指针(如
std::unique_ptr)可以很好地管理对象的生命周期,避免内存泄漏。 - 缺点: 引入了堆内存分配的开销,通常比栈分配慢。使用裸指针容易导致内存泄漏或悬空指针。智能指针虽然解决了所有权问题,但额外的抽象层可能带来轻微的运行时开销(通常可以忽略)。这改变了对象的存储位置,从栈变成了堆,这并非总是我们想要的。
3. 返回常量引用(const MyData&):
这种方式通常用于返回一个已存在的、函数不拥有其生命周期的对象。例如,一个类成员函数返回其内部某个成员的引用。
class DataHolder {
    MyData internal_data;
public:
    DataHolder(int id, const std::string& name) : internal_data(id, name) {}
    const MyData& getData() const {
        return internal_data; // 返回内部成员的引用
    }
};

// 调用示例
DataHolder holder(105, "Holder_");
const MyData& ref_data = holder.getData();- 优点: 零拷贝开销。
- 缺点: 绝不能用于返回局部变量! 因为局部变量在函数返回后就销毁了,返回其引用将导致悬空引用。只能返回生命周期比函数调用更长的对象(如全局变量、静态变量、传入的参数引用、类成员)。它不是真正意义上的“创建并返回新对象”。
综上,在现代C++中,如果你的函数需要“创建”一个结构体对象并将其传递给调用者,直接按值返回是首选,因为它兼顾了代码的简洁性、安全性和性能(通过RVO/移动语义)。只有当对象非常大,或者其生命周期需要脱离函数调用栈时,才考虑返回智能指针。
编译器是如何实现返回值优化(RVO/NRVO)的?对代码编写有何影响?
返回值优化(RVO)和具名返回值优化(NRVO)是C++编译器为了消除不必要的对象拷贝而进行的一项强大优化。它们的核心思想是:与其在函数内部创建一个临时对象,然后将其拷贝或移动到函数外部的接收位置,不如直接在函数外部的接收位置构造这个对象。
实现机制:
想象一下,当你写下MyData result = createData(101, "User_");这行代码时,如果没有RVO,可能会发生以下步骤:
createData函数内部,调用MyData的构造函数在栈上创建一个局部对象temp_data。temp_data通过拷贝构造函数(或移动构造函数)被拷贝(或移动)到main函数栈帧中的一个临时位置。temp_data的析构函数被调用。- 这个临时位置的对象再通过拷贝构造函数(或移动构造函数)被拷贝(或移动)到
result变量。 - 临时对象的析构函数被调用。
result对象的析构函数在main函数结束时被调用。
这中间涉及了多次构造和析构,开销不小。
而有了RVO/NRVO,编译器会做一件非常巧妙的事情:
- 编译器在编译时就知道了
main函数中result变量的内存地址。 - 当
createData函数被调用时,编译器会偷偷地把result的内存地址传递给createData。 createData函数内部,当它要构造temp_data时,实际上会直接在result的内存地址上调用MyData的构造函数。- 这样,
temp_data和result就成了同一个对象,或者说,temp_data根本就没有单独的内存,它就是result。 - 函数返回时,不需要任何拷贝或移动操作,因为对象已经“在位”了。
这就是为什么你看到的输出中,MyData的拷贝/移动构造函数没有被调用的原因。
- RVO (Return Value Optimization): 主要针对返回匿名临时对象的情况。例如
return MyData(id, full_name);这种直接构造并返回的。 - NRVO (Named Return Value Optimization): 主要针对返回具名局部对象的情况,就像我们例子中的
return temp_data;。NRVO通常比RVO更复杂,因为编译器需要确定返回的具名对象是否总是同一个。如果函数有多个返回路径,并且每个路径返回不同的具名对象,NRVO可能就无法生效。
对代码编写的影响:
- 大胆按值返回: 最重要的影响就是,你可以放心地按值返回结构体或类对象,尤其是那些包含动态分配内存(如
std::string、std::vector)的复杂对象。现代编译器会为你处理好性能问题。 - 代码更简洁、更安全: 避免了手动管理指针、引用或输出参数的复杂性。代码意图更清晰,不易出错。
- 不要过度优化: 有些新手可能会觉得“手动
std::move一下会更快”,比如在createData函数中写成return std::move(temp_data);。然而,这在很多情况下是画蛇添足,甚至可能阻止NRVO!因为std::move将temp_data转换为右值引用,这告诉编译器“我明确要移动它”,反而可能让编译器放弃执行NRVO,转而执行移动构造。正确的做法是:当返回一个具名局部变量时,直接return variable_name;,让编译器自己决定是RVO还是移动。 - 理解并非100%保证: 尽管RVO/NRVO非常普遍,但它仍然是一种优化,不是语言规范强制要求的。在某些复杂的场景(如多个返回点返回不同具名对象,或使用某些特殊的编译选项)下,它可能不会发生。不过,C++17标准对某些RVO情况(特别是prvalue的拷贝省略)做了强制要求,使得这些情况下的拷贝省略是有保证的。
总之,RVO/NRVO是C++编译器的一项伟大成就,它让我们能够编写自然、直观的代码,同时获得出色的性能。作为开发者,我们应该信任编译器,并遵循“按值返回”的现代C++最佳实践。
除了RVO,C++11及更高版本在处理返回值时还有哪些现代机制?
即便RVO/NRVO未能生效,C++11及更高版本也为我们提供了强大的“备用方案”,确保按值返回大型对象依然高效,这就是移动语义(Move Semantics)。移动语义与RVO是相辅相成的,它们共同构成了现代C++高效处理对象返回的基础。
1. 移动语义(Move Semantics):
在C++11中引入的移动语义,通过右值引用(rvalue reference)和移动构造函数(move constructor)/移动赋值运算符(move assignment operator),实现了资源的“窃取”而非深拷贝。当一个对象即将被销毁(例如一个即将返回的局部变量,或一个临时对象)时,如果它拥有动态分配的资源(如std::string的字符缓冲区、std::vector的底层数组),移动构造函数可以仅仅将这些资源的指针或句柄从源对象“转移”到目标对象,而源对象则被置于一个有效但未指定状态(通常是清空其资源指针)。这比拷贝整个资源要快得多。
// 假设MyData有移动构造函数,如我们最初的例子所示
// MyData(MyData&& other) noexcept;

MyData createDataWithMove(int id, const std::string& name_prefix) {
    std::string full_name = name_prefix + std::to_string(id);
    MyData temp_data(id, full_name); // 构造局部对象
    std::cout << "  createDataWithMove 函数内部,准备返回 temp_data" << std::endl;
    // 如果NRVO未能生效,这里会调用MyData的移动构造函数
    // 将temp_data移动到返回值位置
    return temp_data;
}

int main() {
    std::cout << "--- 调用 createDataWithMove ---" << std::endl;
    MyData result = createDataWithMove(201, "Move_");
    std::cout << "--- createDataWithMove 调用结束 ---" << std::endl;
    std::cout << "主函数中收到对象: id=" << result.id << ", name=" << result.name << std::endl;
    std::cout << "--- 主函数结束 ---" << std::endl;
    return 0;
}如果NRVO没有发生,你就会看到MyData 移动构造函数被调用的输出。这仍然比拷贝要高效得多,尤其对于大型复杂对象。
2. C++17的强制拷贝省略(Guaranteed Copy Elision):
C++17标准更进一步,对某些特定的场景,强制要求编译器执行拷贝省略,这意味着在这些情况下,拷贝或移动操作是保证不会发生的。最典型的就是当一个prvalue(纯右值,比如一个临时对象)被用作初始化一个对象或作为函数返回值时。
例如,如果你这样写:
MyData createDirectly(int id, const std::string& name_prefix) {
    // 直接返回一个临时对象(prvalue)
    return MyData(id, name_prefix + std::to_string(id));
}

int main() {
    MyData result = createDirectly(301, "Direct_");
    // 在C++17及更高版本中,这里保证不会发生拷贝或移动
    // MyData(301, "Direct_301") 会直接在result的内存位置构造
    return 0;
}
在C++17之前,这种情况下RVO是允许的优化,但不是强制的。C++17之后,它就是语言保证的行为。这意味着你甚至不需要担心移动构造函数是否被调用,因为它根本就不会被调用。
3. 结合“零法则”(Rule of Zero):
在现代C++中,如果你的结构体或类只包含其他标准库类型(如std::string, std::vector, std::unique_ptr等),并且你没有手动定义任何析构函数、拷贝/移动构造函数或拷贝/移动赋值运算符,那么编译器会自动为你生成这些特殊的成员函数。这些自动生成的函数通常都是“正确的”和高效的(特别是移动操作)。这就是所谓的“零法则”——如果你不需要特别的行为,就不要定义它们。
当按值返回这样的对象时,编译器会优先尝试RVO/NRVO。如果不行,它会使用自动生成的移动构造函数进行高效的资源转移。如果连移动构造函数也无法使用(例如,返回的是一个const对象),它才会退回到拷贝构造函数。
总结:
现代C++在处理函数返回值时,已经形成了一套非常成熟和高效的机制。我们应该:
- 优先按值返回对象,让编译器利用RVO/NRVO进行优化。
- 信任编译器,避免在返回具名局部变量时画蛇添足地使用
std::move。 - 利用移动语义作为RVO的强大后备,确保即使发生“转移”也能保持高效。
- 拥抱C++17的强制拷贝省略,它让某些场景下的性能保证更加明确。
- 遵循“零法则”,除非有特殊资源管理需求,否则不要手动编写拷贝/移动构造函数和赋值运算符。
这些现代机制共同确保了C++在表达简洁和性能效率之间找到了一个极佳的平衡点,让按值返回对象成为一种既自然又高效的编程范式。
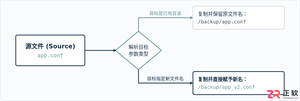
在Linux系统中,复制文件并改名并没有单独的独立命令,而是通过标准复制命令cp在指定目标路径时直接写上新文件名来完成。本文详解cp命令复制并重命名的操作语法、同目录与跨目录示例、常用安全参数及目录复制实践。
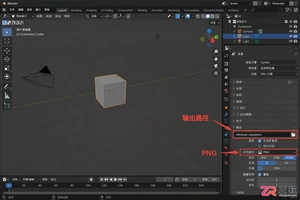
学习如何将Blender中的动态材质导出为图片序列。涵盖输出路径设置、PNG格式选择、帧范围确认及Image Sequence贴图的重新载入方法,适合需要保留透明通道或后期处理的动画贴图工作流。
想在iPhone或iPad上实现锁屏一键直达?本文详解“锁屏启动”的安装前检查清单、系统权限配置步骤及小组件添加方法,解决组件不显示、点击无反应等常见问题,确保快捷指令、网页和App快速启动。
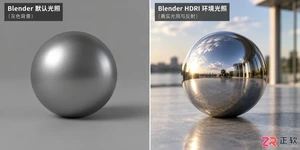
学习如何在Blender中使用HDRI进行渲染。通过World着色器连接Environment Texture节点,调整光照强度与环境方向,解决背景显示与曝光问题,快速提升场景真实感。
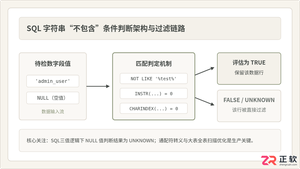
深入详解在SQL中进行条件判断字符串不包含某个子串的方法,涵盖标准NOT LIKE、各主流数据库(MySQL、PostgreSQL、SQL Server、Oracle)专有位置函数、正则表达式判断,剖析NULL值三值逻辑陷阱及全表扫描性能优化策略。
新手必读的IDM安装配置教程。从官方下载开始,逐步讲解如何完成Windows安装、启用Chrome/Edge/Firefox浏览器扩展、设置默认保存目录及调整连接线程,解决IDM不弹窗接管下载的常见问题。
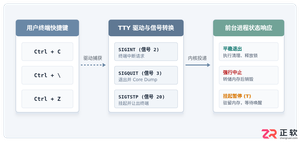
全面解析Linux终端中终止进程的核心快捷键(Ctrl+C、Ctrl+Z、Ctrl+\)的原理、区别与具体使用方法,附后台恢复与强制终止全流程指南。
详解使用微软官方媒体创建工具制作 Windows 10 安装U盘的步骤,包括直接写入和ISO备份两种方式,并提供启动验证与故障排查建议。
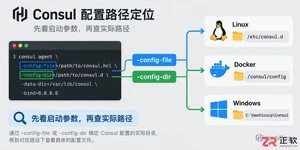
找不到 Consul 配置文件?直接搜索文件往往无效。本文详解如何根据启动参数(-config-file/-config-dir)在 Linux (/etc/consul.d)、Docker (/consul/config) 和 Windows 环境中准确定位 Consul 配置,并提供配置校验步骤。
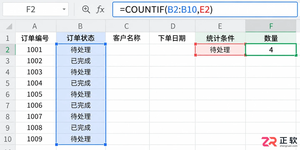
在WPS表格中使用COUNTIF进行单条件计数时,常因区域引用不当或条件格式差异导致结果偏差。本文详解COUNTIF的因果逻辑,提供区域固定、通配符应用及数据类型校验的实操方法,并说明何时应改用COUNTIFS或其他方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。

Android Studio 是 Google 面向 Android 应用开发提供的官方集成开发环境,以 IntelliJ IDEA 为基础,集成智能代码编辑、Gradle 构建、设备模拟、界面预览、调试测试及性能分析工具,