

Django 文件上传路径管理技巧
本教程详细阐述了在Django应用中处理文件上传的最佳实践,特别是如何从HTTP请求中正确获取上传文件、将其安全地保存到存储系统,并获取其存储路径。我们将重点讲解request.FILES的使用、default_storage.save()的返回值,以及如何将正确的文件路径传递给后续的文件处理函数,同时提供健壮的错误处理机制。

Django 文件上传机制概述
在Django中处理文件上传,核心在于理解request.FILES对象。当HTML表单的enctype属性设置为multipart/form-data时,浏览器会将文件内容作为请求体的一部分发送到服务器。Django会自动解析这些数据,并将上传的文件封装成UploadedFile对象,存储在request.FILES字典中。每个UploadedFile对象都包含了文件的元数据(如文件名、大小、内容类型)以及访问文件内容的方法。
常见错误与问题分析
在处理文件上传时,开发者常犯的一个错误是混淆UploadedFile对象与表单验证后的cleaned_data。原始代码中尝试使用excel_file.cleaned_data['file'].read()来获取文件内容,这是不正确的。request.FILES直接提供的是UploadedFile实例,它本身就具备read()和name等属性,无需通过cleaned_data再次访问。cleaned_data通常在Django表单(forms.Form或forms.ModelForm)验证后使用。
另一个关键问题在于default_storage.save()的返回值使用不当。原始代码将default_storage.save()的返回值(即文件在存储系统中的相对路径)赋给了变量file,但在后续调用process_file(file, ...)时,却期望process_file函数能够直接处理这个路径。如果process_file函数需要的是文件路径字符串,那么直接将file(路径字符串)传递给它才是正确的。
以下是原始代码片段及其存在的问题:
# 原始代码片段 (存在问题)
def upload_file(request):
    if request.method == 'POST':
        try:
            excel_file = request.FILES.get('file') # 获取 UploadedFile 对象
            # 错误:UploadedFile 对象没有 cleaned_data 属性
            file_data = excel_file.cleaned_data['file'].read()
            file_name = excel_file.cleaned_data['file'].name

            # default_storage.save 返回的是文件路径字符串
            # 但变量名 'file' 可能导致后续误解
            file = default_storage.save(file_name, ContentFile(file_data))

            # 如果 process_file 期望的是文件路径,这里传递的变量名 'file' 实际上是路径字符串
            # 但如果 process_file 期望的是文件对象,则这里传递的是路径字符串,类型不匹配
            xlxs = process_file(file, process_type='json', db_type='default')
            # ...
正确的文件上传与路径管理实践
为了正确处理文件上传并获取文件存储路径,我们需要遵循以下步骤:
- 获取UploadedFile对象: 从request.FILES字典中直接获取上传的文件对象。
- 读取文件内容与名称: 使用UploadedFile对象的read()方法获取文件二进制内容,使用name属性获取原始文件名。
- 保存文件并获取路径: 使用Django的存储系统(通常是django.core.files.storage.default_storage)将文件内容保存到指定位置,并获取文件在存储系统中的相对路径。default_storage.save()方法会返回这个路径。
- 将路径传递给处理函数: 将获取到的文件路径字符串传递给后续的业务逻辑函数(例如,处理Excel文件的函数)。
以下是经过优化的views.py代码示例:
from django.shortcuts import HttpResponse
from django.core.files.storage import default_storage
from django.core.files.base import ContentFile
# 假设 process_file 是一个外部函数,用于处理文件路径
# 例如:
# def process_file(file_path, process_type, db_type):
#     # 实现文件处理逻辑,例如使用 openpyxl 读取 Excel 文件
#     print(f"Processing file: {file_path} with type {process_type}")
#     # 这里只是一个示例,实际应返回处理结果
#     if file_path.endswith('.xlsx'):
#         return f"Processed {file_path}"
#     return None


def upload_file(request):
    if request.method == 'POST':
        try:
            # 1. 从 request.FILES 中直接获取 UploadedFile 对象
            # 使用 get() 方法更安全,避免 KeyError
            excel_file = request.FILES.get('file')
            if not excel_file:
                return HttpResponse("No file was uploaded.", status=400)

            # 2. 直接从 UploadedFile 对象读取文件内容和名称
            file_data = excel_file.read()
            file_name = excel_file.name

            # 3. 使用 default_storage.save() 保存文件
            # default_storage.save() 返回的是文件在存储系统中的相对路径
            file_path = default_storage.save(file_name, ContentFile(file_data))

            # 4. 将正确的文件路径传递给处理函数
            # 确保 process_file 函数能够接收并处理这个路径字符串
            xlxs = process_file(file_path, process_type='json', db_type='default')

            if xlxs:
                return HttpResponse(f'Success! File path: {xlxs}')
            else:
                return HttpResponse("There was an error during the process.")
        except Exception as e:
            # 打印异常信息便于调试
            print(f"Error in upload_file: {e}")
            return HttpResponse("An unexpected error occurred during the process.", status=500)
    return HttpResponse("Please upload a file using POST method.", status=405)
关键点与注意事项
HTML 表单设置: 确保您的HTML表单使用了正确的enctype属性。
Django 存储配置: 为了使default_storage正常工作,您需要在settings.py中配置MEDIA_ROOT和MEDIA_URL。
- MEDIA_ROOT: 文件将存储在服务器文件系统上的绝对路径。
- MEDIA_URL: 用于访问这些文件的公共URL。
# settings.py
import os
BASE_DIR = os.path.dirname(os.path.dirname(os.path.abspath(file)))
MEDIA_URL = '/media/' MEDIA_ROOT = os.path.join(BASE_DIR, 'media') # 确保 'media' 目录存在或会被创建
同时,您还需要在项目的`urls.py`中为`MEDIA_URL`提供服务(仅在开发环境需要)。
```python
# project_name/urls.py
from django.contrib import admin
from django.urls import path, include
from django.conf import settings
from django.conf.urls.static import static

urlpatterns = [
    path('admin/', admin.site.urls),
    path('upload/', your_app.views.upload_file), # 假设 upload_file 在 your_app.views 中
]

if settings.DEBUG:
    urlpatterns += static(settings.MEDIA_URL, document_root=settings.MEDIA_ROOT)
安全性考虑:
- 文件类型验证: 在保存文件之前,务必验证上传文件的类型,防止恶意文件上传。可以通过检查excel_file.content_type或文件扩展名来完成。
- 文件大小限制: 限制上传文件的大小,以防止拒绝服务攻击。可以在Django的settings.py中设置FILE_UPLOAD_MAX_MEMORY_SIZE和DATA_UPLOAD_MAX_MEMORY_SIZE,或在视图逻辑中手动检查。
- 文件名处理: 对上传的文件名进行清理,避免路径遍历攻击或其他安全问题。default_storage.save()通常会处理文件名冲突,但自定义的文件名处理可能需要额外的清理。
错误处理: 使用try...except块捕获潜在的异常,并向用户返回友好的错误信息,同时在服务器日志中记录详细错误,这对于调试和维护至关重要。
异步处理: 对于大型文件或耗时的文件处理任务(如大型Excel文件的解析),建议将文件处理逻辑放入异步任务队列(如使用Celery),以避免阻塞Django主线程,提高用户体验和服务器响应能力。
总结
在Django中正确处理文件上传涉及对request.FILES、UploadedFile对象以及default_storage的深入理解。通过遵循本教程中介绍的最佳实践,您可以确保文件被正确接收、安全存储,并且其存储路径能够准确地传递给后续的业务处理逻辑。这不仅提高了代码的健壮性和安全性,也为构建高效可靠的文件处理功能奠定了基础。
Ponytail面向已使用AI编程助手并希望优化代码质量的开发者,以及负责维护旧项目或审查AI生成代码的技术人员。它提供了一套可重复加载的开发判断规则,帮助用户减少冗余代码、梳理数据流并评估技术选型。虽然非编程人员也可提出任务,但仍需具备一定技术判断力来核对兼容性、行为逻辑及必要检查项。本文详解其在代码审查、旧项目维护及前端原生能力评估中的具体应用路径。
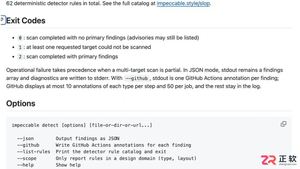
面向在Cursor或Codex中配置Impeccable技能的用户,解决安装后命令无法调用、菜单不显示或钩子无响应的问题。本文梳理从终端环境检查到工具重载的完整路径:确认Node.js与PATH配置,区分npx终端命令与聊天助手指令(如/impeccable audit),通过/impeccable check和update管理版本,利用/impeccable doctor修复配置漂移,并单独核对/hooks状态以排除权限干扰,避免盲目重装导致配置覆盖。
面向希望利用 DeepSeek SuperAgent 辅助开发但缺乏编程背景的用户,本文解析其实际使用门槛。虽然任务派发可通过自然语言完成,适合业务人员整理需求,但独立部署、环境配置及代码审阅仍需技术基础。文章说明安装时的账号权限管理要点,指导如何通过面板监控任务状态,并强调在无人负责技术维护时不宜盲目自动化,需由专业人员验收代码以确保安全。
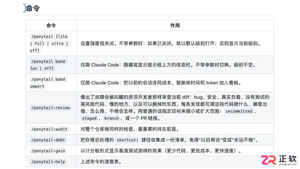
面向使用Claude Code进行开发的程序员,Ponytail插件旨在通过引导AI助手优先复用现有能力来控制新增代码规模。本文介绍其核心用途:在开发任务中减少不必要代码编写,通过“/ponytail-review”命令审查暂存改动的安全性与可维护性,以及利用“/ponytail-debt”整理带有明确限制的开发捷径和技术债务。使用前需根据安装方式确认宿主支持的具体命令和自动加载功能。
Impeccable面向已使用AI编程工具并希望优化界面清晰度的个人开发者、前端工程师及产品维护团队。它不要求用户精通设计术语,但需能明确描述用户目标与限制条件。本文介绍三类典型应用场景:个人开发者利用shape命令梳理需求边界,避免开发蔓延;团队通过document命令提取视觉规则至DESIGN.md以保持风格一致;维护者使用harden命令检查表单等界面的边缘状态。适用前提是手头有真实的界面设计或改进需求。
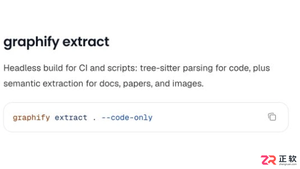
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
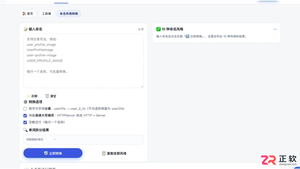
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
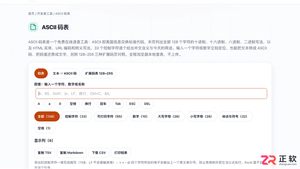
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。
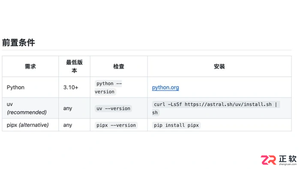
面向需要在本地部署Graphify工具的开发人员,本文详解基于Python 3.10+环境的安装流程。针对用户常遇到的依赖冲突问题,推荐使用uv或pipx创建独立运行环境。内容涵盖graphifyy官方包的安装验证、CLI命令可用性检查,以及针对Claude Code等编码助手的技能注册步骤,帮助读者快速完成从环境准备到功能集成的全过程。
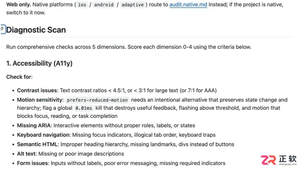
面向需要优化前端界面的开发者,Impeccable借助AI编程助手辅助改进具体页面。它常用于评审页面技术质量、调整移动端与桌面端布局,以及简化复杂界面以降低认知负荷。使用时需针对不同目标选择专用命令,如audit用于检查问题,adapt用于设备适配,distill用于精简内容。本文介绍如何通过明确指令聚焦单一任务,避免一次性重构整个项目,并在修改后通过实际业务流程验证功能完整性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



