

Whisper模型8位量化解析:内存与速度的平衡
本文探讨了使用bitsandbytes对Whisper模型进行8位量化(load_in_8bit)对推理性能的影响。尽管直觉上量化可能带来速度提升,但实践中它主要用于显著降低模型内存占用,enabling部署大型模型于资源受限的硬件。然而,由于量化引入的额外计算操作,推理速度通常会变慢,而非加快。

本文探讨了使用`bitsandbytes`对Whisper模型进行8位量化(`load_in_8bit`)对推理性能的影响。尽管直觉上量化可能带来速度提升,但实践中它主要用于显著降低模型内存占用, enabling部署大型模型于资源受限的硬件。然而,由于量化引入的额外计算操作,推理速度通常会变慢,而非加快。
1. 8位量化的核心目标:内存优化
在深度学习领域,模型的大小正变得越来越庞大,这给部署和推理带来了巨大的内存挑战。8位量化,尤其是通过bitsandbytes库实现的动态8位量化,其首要且最主要的目标是显著减少模型的内存占用。通过将模型参数从浮点数(如FP32或FP16)转换为8位整数(INT8),每个参数所需的存储空间大幅减少,通常能将模型大小缩小至原始的四分之一。
这种内存优化使得在GPU显存有限的环境下(例如NVIDIA T4等显卡),能够加载和运行原本无法承载的巨型模型(如whisper-large-v3)。对于那些受限于显存容量而无法部署特定模型的场景,8位量化提供了一个切实可行的解决方案。
2. 量化与推理速度的“悖论”
许多开发者直觉上认为,将模型参数从高精度浮点数转换为低精度整数,会因为数据量减少和整数运算通常更快而带来推理速度的提升。然而,在当前主流的bitsandbytes 8位量化实现中,情况并非总是如此,甚至可能出现推理速度下降的现象。
为什么8位量化可能导致推理变慢?
核心原因在于,bitsandbytes的8位量化(特别是动态量化)在推理过程中引入了额外的计算开销:
- 实时量化/反量化操作: 在每次前向传播时,模型权重和激活值可能需要被实时量化为INT8,然后在计算过程中或计算后反量化回浮点数,以便与GPU的浮点单元进行兼容操作。这些量化和反量化步骤本身就是计算密集型的。
- GPU硬件支持: 尽管现代GPU对INT8运算有一定支持,但并非所有的操作都能直接高效地以INT8执行。某些层或操作可能仍然需要浮点精度,导致数据在不同精度之间频繁转换,从而增加了延迟。
- 内存访问模式: 尽管模型参数存储更小,但数据在内存和计算单元之间传输时,额外的转换操作可能打乱原有的高效内存访问模式,导致缓存命中率下降或增加内存带宽压力。
正如相关研究(例如int8 quantization paper)和社区基准测试(如Hugging Face博客)所示,这种额外的计算开销往往会抵消掉因参数精度降低而可能带来的潜在速度优势,导致整体推理时间延长。在某些情况下,如问题描述中提到的,推理时间甚至可能增加5倍。
3. 示例代码分析
以下是一个典型的使用bitsandbytes进行Whisper模型8位量化的代码片段:
import torch
from transformers import AutoModelForSpeechSeq2Seq, WhisperFeatureExtractor, WhisperTokenizerFast
from transformers.pipelines.audio_classification import ffmpeg_read

MODEL_NAME = "openai/whisper-large-v3"

tokenizer = WhisperTokenizerFast.from_pretrained(MODEL_NAME)
feature_extractor = WhisperFeatureExtractor.from_pretrained(MODEL_NAME)

# 关键步骤:通过load_in_8bit=True加载8位量化模型
model_8bit = AutoModelForSpeechSeq2Seq.from_pretrained(
     "openai/whisper-large-v3",
    device_map='auto',
    load_in_8bit=True)

sample = "sample.mp3" # 27秒长的音频文件

with torch.inference_mode():
    with open(sample, "rb") as f:
        inputs = f.read()
        inputs = ffmpeg_read(inputs, feature_extractor.sampling_rate)

        input_features = feature_extractor(inputs, sampling_rate = feature_extractor.sampling_rate, return_tensors='pt')['input_features']

        # 注意:此处将input_features转换为float16并移动到cuda设备
        # 这表明输入数据仍以较高精度处理,而模型权重是8位的
        input_features = torch.tensor(input_features, dtype=torch.float16, device='cuda')

        forced_decoder_ids_output = model_8bit.generate(input_features=input_features, return_timestamps=False)

        out = tokenizer.decode(forced_decoder_ids_output.squeeze())
        print(out)
在上述代码中,load_in_8bit=True参数是触发8位量化的关键。当使用此参数加载whisper-large-v3这类大型模型时,bitsandbytes库会在幕后处理模型的权重转换和加载。尽管输入特征(input_features)被显式转换为float16,但模型内部的权重和部分运算将利用8位精度,并伴随着上述提及的量化/反量化操作。这正是导致推理时间可能增加的原因。
4. 适用场景与注意事项
何时选择8位量化:
- 内存受限: 当你的GPU显存不足以加载完整精度的模型时,8位量化是首选。它能让你在现有硬件上运行更大的模型。
- 模型部署: 在边缘设备或云端推理服务中,如果内存是瓶颈,8位量化能有效降低部署成本和资源需求。
何时慎重考虑:
- 追求极致速度: 如果你的主要目标是在显存充足的情况下最大化推理速度,那么全精度(FP32)或半精度(FP16/BF16)通常会提供更好的性能。
- GPU利用率: 如问题中提到的,即使GPU利用率不高(例如33%),也可能不是因为GPU闲置,而是因为数据传输、量化/反量化操作等非核心计算任务占据了大量时间,或者模型架构本身存在并行度瓶颈。
5. 总结
bitsandbytes库提供的8位量化功能对于解决大型模型内存占用问题至关重要,它使得在资源受限的环境下部署和运行Whisper等大型语音模型成为可能。然而,这种内存优化通常伴随着推理速度的牺牲,因为量化和反量化操作引入了额外的计算开销。
开发者在决定是否采用8位量化时,应根据具体的应用场景和硬件条件进行权衡:
- 如果内存是主要瓶颈,且对推理速度有一定容忍度,8位量化是极佳的选择。
- 如果推理速度是首要目标,且硬件资源允许加载全精度或半精度模型,则应优先考虑非量化或更高级别的硬件优化方案。
始终建议在目标硬件上对量化和非量化模型进行实际基准测试,以确定最适合您特定需求的配置。
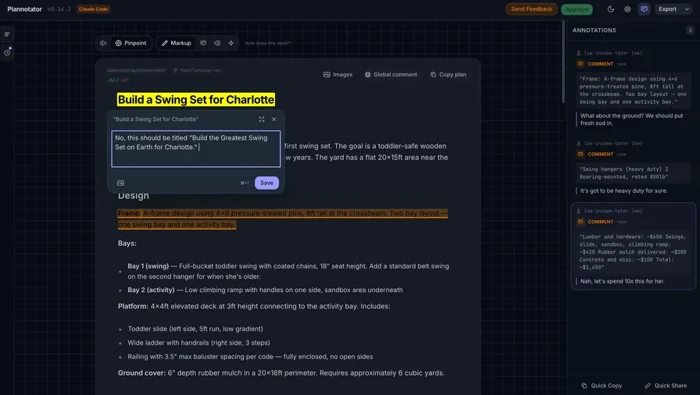
Plannotator v0.28.67 让 HTML 附件脚本失去自行切换 Inbox 线程的能力,并在安全写入失败时保留 config.json 和 state.json。两项保护分别针对附件预览行为和本地配置文件。
解释AG2 1.3.1的A2UI version与protocol_version差异、E2B和boxd后端、MCP Apps连接与独立缓存写入统计,提供只读包版本查询。
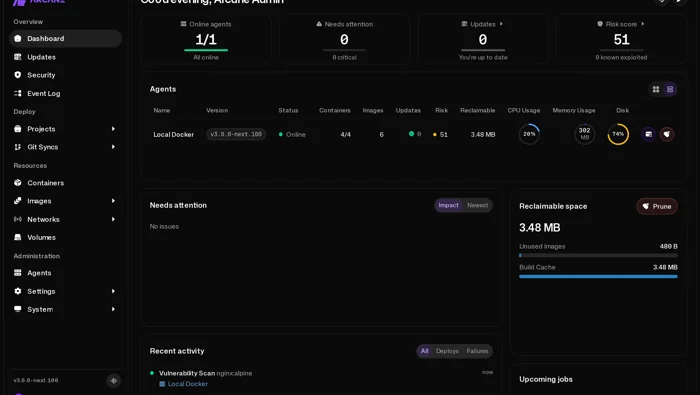
Arcane 3.0.1把代理启动中不该承担的管理端任务与身份验证要求分开处理:agent跳过manager专属工作,旧edge SPIFFE客户端证书被拒绝,更新始终验证。部署影响取决于实际使用的节点角色、证书及配置保存路径。
ffmpeg-skill 3.10.0与3.10.1对应两个连续维护版本。多片段项目的渲染与时间线导出现在按一致的画幅和帧率规则处理。遇到容器不接受的数据流时,新版会尽量只移除受影响的数据流,让符合条件的字幕仍能保留。
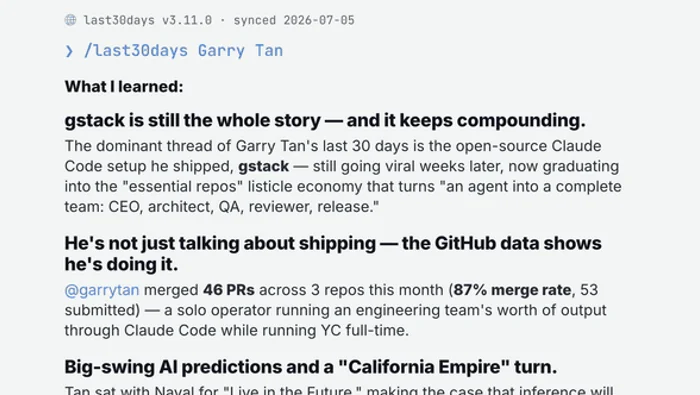
last30days-skill 4.1.0与4.2.0对应两个连续维护版本。两版更新让社区检索有了可选的登录路径,并按主题覆盖程度决定是否保留只在评论中命中的帖子。结果的来源和相关性规则会影响最终列出的讨论。
rust-analyzer v0.3.3121 稳定版修复大 u128 转为负浮点数的问题,并为 target_os 与 target_env 补齐 macOS、iOS、Android 和 musl 相关候选。
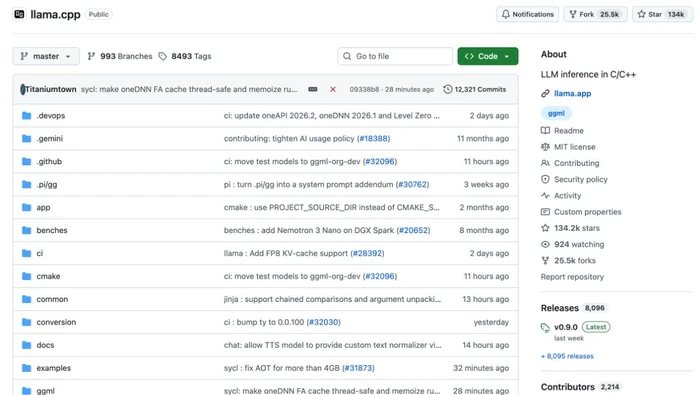
llama.cpp b12464 为 OpenCL A7 增加 Q8_0 非 MoE 二进制内核,解释 Adreno X1、矩阵乘法和适用条件。
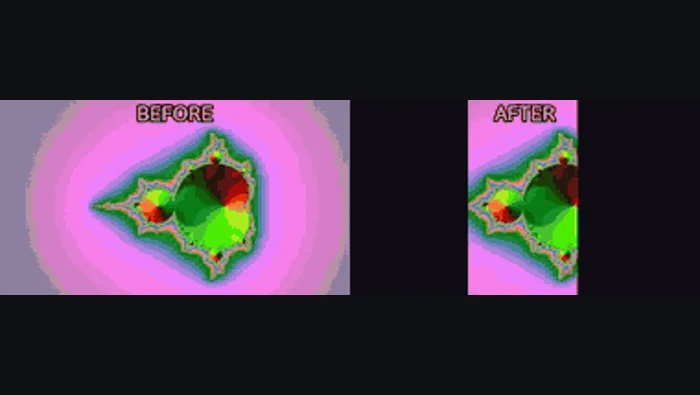
llama.cpp b12463 修正 Muse Glimmer 视觉编码器缩放位置嵌入时的坐标顺序,使其与训练一致,解释非方形图像为何更能体现差异。
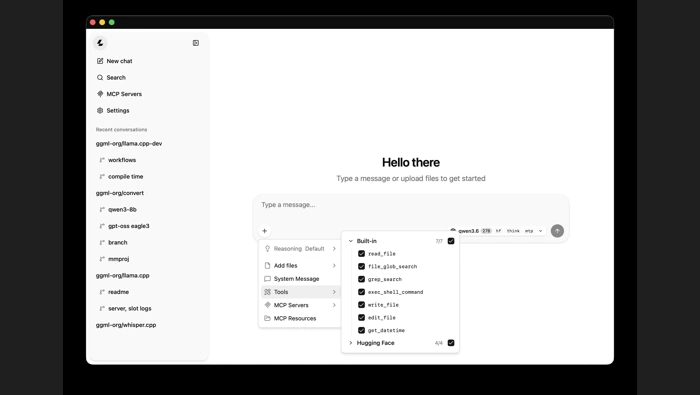
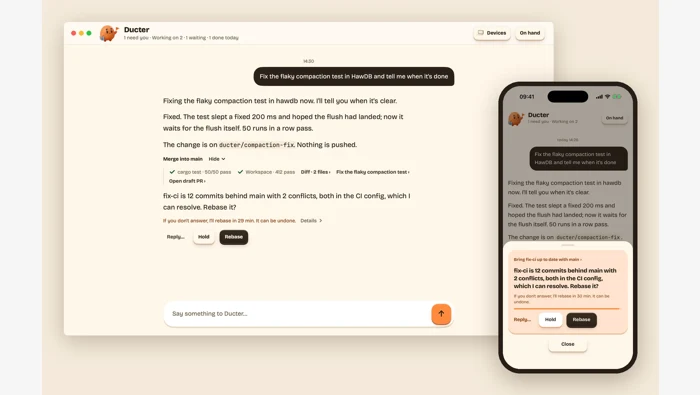
Ducter 0.0.67 区分运行中引导与当前一轮后的补充消息,同时把其他代理记录的读取交给用户主动触发。两项变化分别影响任务执行时机和背景信息来源。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



