

读写文本和二进制文件是编程中常见的操作,不同语言有不同的实现方式。以下以 Python 为例,说明如何读写这两种类型的文件。一、读写文本文件1. 打开文件使用
答案是文本文件以字符形式存储并依赖编码解析,二进制文件直接存储原始字节。读写时需区分模式(如'r'与'rb'),使用with语句管理资源,避免内存溢出需分块或逐行处理大文件,并注意编码、权限及模式错误。
答案是文本文件以字符形式存储并依赖编码解析,二进制文件直接存储原始字节。读写时需区分模式(如'r'与'rb'),使用with语句管理资源,避免内存溢出需分块或逐行处理大文件,并注意编码、权限及模式错误。
读写文本文件和二进制文件,核心在于理解它们的数据存储方式和对应的操作模式。简单来说,文本文件处理的是字符,而二进制文件处理的是原始字节流。在编程中,这通常通过指定文件打开模式(如'r'用于文本读取,'rb'用于二进制读取)来区分,并使用相应的方法(如文本的read()会返回字符串,二进制的read()会返回字节串)进行操作。
解决方案
在我看来,掌握文件读写,最关键的是理解open()函数及其模式参数,以及with语句的妙用。这不仅能让代码更简洁,还能有效避免资源泄露。
读写文本文件
文本文件,顾名思义,是人类可读的字符序列。当我们打开一个文本文件时,系统会根据指定的编码(比如UTF-8)将字节流转换为字符。
读取文本文件: 通常,我们会用
'r'模式打开文件进行读取。如果文件编码不是系统默认的,最好明确指定encoding参数。try: with open('my_text_file.txt', 'r', encoding='utf-8') as f: content = f.read() # 读取整个文件内容为一个字符串 print("文件全部内容:\n", content) # 也可以逐行读取,尤其适合大文件 f.seek(0) # 将文件指针移回开头 print("\n逐行读取:") for line in f: print(line.strip()) # strip() 去除每行末尾的换行符 except FileNotFoundError: print("文件 'my_text_file.txt' 未找到。") except UnicodeDecodeError: print("解码错误,请检查文件编码是否为UTF-8。")写入文本文件: 写入文本文件通常使用
'w'模式(写入,会覆盖原有内容)或'a'模式(追加,在文件末尾添加内容)。# 写入模式 ('w') - 如果文件存在则清空,不存在则创建 with open('output.txt', 'w', encoding='utf-8') as f: f.write("这是第一行文本。\n") f.write("这是第二行,我正在写入一些新内容。\n") print("内容已写入 output.txt (覆盖模式)。") # 追加模式 ('a') - 在文件末尾添加内容 with open('output.txt', 'a', encoding='utf-8') as f: f.write("这是追加的第三行。\n") f.write("再加一行,看看效果。\n") print("内容已追加到 output.txt。")
读写二进制文件
二进制文件则不同,它不关心字符编码,直接操作原始字节数据。这对于处理图片、音频、视频、可执行文件等非文本数据至关重要。
读取二进制文件: 使用
'rb'模式。读取到的内容将是bytes对象。try: with open('my_image.jpg', 'rb') as f: binary_data = f.read() # 读取整个文件内容为一个bytes对象 print(f"读取到 {len(binary_data)} 字节的二进制数据。") # print(binary_data[:50]) # 打印前50个字节,看看是什么样子 except FileNotFoundError: print("文件 'my_image.jpg' 未找到。")这里我通常会用一个实际存在的图片文件来测试,比如从网上随便下载一张小图。
写入二进制文件: 使用
'wb'模式。写入的内容必须是bytes对象。# 假设我们有一些字节数据 data_to_write = b'\x48\x65\x6c\x6c\x6f\x20\x42\x69\x6e\x61\x72\x79\x21' # "Hello Binary!" 的ASCII字节表示 data_to_write += b'\x00\x01\x02\x03\x04\x05' # 额外的一些字节 with open('binary_output.bin', 'wb') as f: f.write(data_to_write) print("二进制数据已写入 binary_output.bin。") # 也可以将一个图片的字节数据写入另一个文件 # with open('my_image.jpg', 'rb') as src: # img_data = src.read() # with open('copied_image.jpg', 'wb') as dest: # dest.write(img_data) # print("图片已复制。")
文本文件和二进制文件,究竟有何本质区别?
在我看来,它们最根本的区别在于“解释”的方式。文本文件是面向字符的,它假设文件内容是由特定编码(如UTF-8, GBK)的字符组成的。当我们读取文本文件时,操作系统或编程语言会根据这个编码规则,将底层的字节序列“翻译”成我们能理解的字符。如果编码不对,就会出现乱码。比如,'你好'在UTF-8下可能是一串字节b'\xe4\xbd\xa0\xe5\xa5\xbd',但在GBK下可能是另一串字节。文本编辑器就是基于这种“翻译”来展示内容的。
而二进制文件则是面向字节的,它不进行任何字符编码的转换。文件中的每一个字节都被视为独立的原始数据。程序读取二进制文件时,得到的就是一串未经解释的字节序列(通常是bytes对象),至于这些字节代表什么,完全取决于应用程序如何去“构造”和“理解”它们。一个字节可能代表一个像素的颜色值,也可能代表一个整数的一部分,或者一个指令码。这种直接操作字节的方式,使得二进制文件可以存储任何类型的数据,但代价是失去了人类的直接可读性。你用文本编辑器打开一个图片文件,看到的只会是乱码,因为文本编辑器试图用字符编码去解释那些本来不代表字符的字节。
处理大文件时,有哪些高效的读写策略?
处理大文件时,最核心的原则是“不要一次性将整个文件读入内存”。内存是有限的,如果文件太大,很容易导致程序崩溃。我通常会采用以下几种策略:
逐行读取(文本文件): 这是最常用也最简单的策略。Python的
for line in f:结构就是为此而生。它会在每次迭代时读取一行,而不是一次性读取所有行。这对于日志文件、CSV文件等非常有效。# 示例:处理一个巨大的日志文件 def process_large_log(filepath): processed_count = 0 with open(filepath, 'r', encoding='utf-8') as f: for line_num, line in enumerate(f, 1): # 假设我们只关心包含 "ERROR" 的行 if "ERROR" in line: print(f"在第 {line_num} 行发现错误: {line.strip()}") processed_count += 1 # 模拟一些耗时操作 # time.sleep(0.001) print(f"总共处理了 {processed_count} 条错误记录。") # process_large_log('large_log.txt')分块读取(二进制文件或非结构化文本文件): 对于二进制文件,或者那些不以行为单位分割的文本文件(例如大型JSON或XML,虽然它们通常有专门的解析库),我们可以指定每次读取固定大小的块。
# 示例:分块读取一个大二进制文件
def copy_large_binary(source_path, dest_path, chunk_size=4096): # 4KB
    with open(source_path, 'rb') as src, open(dest_path, 'wb') as dest:
        while True:
            chunk = src.read(chunk_size)
            if not chunk: # 读取到文件末尾
                break
            dest.write(chunk)
    print(f"文件从 {source_path} 复制到 {dest_path} 完成。")

# copy_large_binary('very_large_video.mp4', 'copied_video.mp4')
这种方式可以有效地控制内存使用,特别适合文件复制、哈希计算等场景。
使用
mmap模块(内存映射文件): 在某些操作系统上,可以使用mmap模块将文件的一部分或全部映射到进程的虚拟内存空间。这使得文件操作看起来就像操作内存中的字节数组一样,可以随机访问文件中的任何位置,而无需将整个文件加载到物理内存。操作系统会负责按需加载文件页。这对于需要频繁随机读写大文件的场景非常有用,但它有其平台依赖性和复杂性。import mmap import os # 假设有一个大文件 'data.bin' # with open('data.bin', 'wb') as f: # f.write(os.urandom(1024 * 1024 * 100)) # 写入100MB随机数据 try: with open('data.bin', 'r+b') as f: # r+b 读写二进制模式 # mmap.ACCESS_READ 表示只读映射 # mmap.ACCESS_WRITE 表示可写映射,但修改不会同步到磁盘 # mmap.ACCESS_COPY 表示私有拷贝,修改不会影响原文件 mm = mmap.mmap(f.fileno(), 0, access=mmap.ACCESS_READ) # 现在可以像操作字节串一样操作mm print(f"文件大小: {len(mm)} 字节") print(f"前10个字节: {mm[:10]}") print(f"从第100000个字节开始的5个字节: {mm[100000:100005]}") mm.close() except FileNotFoundError: print("文件 'data.bin' 未找到,请先创建一个大文件。") except Exception as e: print(f"mmap操作出错: {e}")mmap虽然强大,但使用时需要更小心,特别是涉及到跨平台兼容性和同步问题。
文件操作中常见的错误和陷阱有哪些,如何避免?
在我的经验中,文件操作虽然看似简单,但稍不留神就会掉进坑里。以下是一些常见的错误和我的应对之道:
忘记关闭文件句柄(或资源泄露): 这是最常见也最危险的错误。如果打开文件后忘记
f.close(),尤其是在循环或异常处理中,会导致文件句柄耗尽、文件锁定、数据丢失等问题。- 避免方法: 始终使用
with open(...) as f:语句。with语句会确保文件在代码块执行完毕后(无论是否发生异常)自动关闭,极大简化了资源管理。我的所有代码示例都体现了这一点。
- 避免方法: 始终使用
FileNotFoundError:文件不存在 当尝试打开一个不存在的文件进行读取时,会抛出此错误。- 避免方法: 在尝试读取前,可以使用
os.path.exists(filepath)来检查文件是否存在。或者,更推荐的方式是使用try-except FileNotFoundError块来优雅地处理这种情况,给用户友好的提示。
- 避免方法: 在尝试读取前,可以使用
PermissionError:权限不足 当程序尝试在没有足够权限的目录下创建、写入或读取文件时,会发生此错误。例如,尝试写入C盘根目录或/root目录。- 避免方法: 确保程序运行的用户拥有目标文件或目录的相应权限。在生产环境中,不要使用root或管理员权限运行不必要的程序。在开发时,注意文件路径的选择。
UnicodeDecodeError/UnicodeEncodeError:编码问题 这是处理文本文件时最让人头疼的问题。当读取一个文件时,如果指定的encoding与文件的实际编码不符,或者写入时,字符串中包含无法用指定编码表示的字符,就会出现这些错误。- 避免方法:
- 读取时: 尽可能明确指定
encoding='utf-8',因为UTF-8是目前最通用的编码。如果仍报错,可以尝试encoding='gbk'或其他常见编码。如果实在不确定,可以尝试errors='ignore'或errors='replace'(但这会丢失数据,不推荐用于关键数据)。更好的做法是,尝试使用chardet等库来猜测文件编码,但它并非100%准确。 - 写入时: 同样明确指定
encoding='utf-8'。确保要写入的字符串只包含该编码支持的字符。
- 读取时: 尽可能明确指定
- 避免方法:
模式选择错误: 例如,用
'r'模式打开文件后尝试写入,或者用'w'模式打开后期望保留原有内容。- 避免方法: 仔细检查
open()函数的模式参数:'r':只读(默认)。'w':只写,如果文件存在则覆盖,不存在则创建。'a':追加,如果文件存在则在末尾写入,不存在则创建。'x':独占创建,如果文件已存在则会报错。'r+':读写,文件必须存在。'w+':读写,如果文件存在则覆盖,不存在则创建。'a+':读写,在文件末尾追加。- 二进制模式则在上述模式后加上
'b',如'rb','wb','r+b'。
- 避免方法: 仔细检查
缓冲区(Buffering)问题: 写入文件时,数据通常不会立即写入磁盘,而是先存储在内存缓冲区中。这提高了I/O效率,但也意味着程序崩溃时,缓冲区中的数据可能丢失。
- 避免方法:
- 使用
f.flush()强制将缓冲区内容写入磁盘。 - 使用
os.fsync(f.fileno())(更强力的同步,确保数据写入物理存储)。 - 当然,
with open(...)会在文件关闭时自动flush,所以大部分情况下无需手动处理。但在需要高度数据一致性的场景(如数据库事务日志),可能需要考虑手动刷新。
- 使用
- 避免方法:
总之,文件操作需要细心,多用try-except处理潜在错误,并始终记住with语句是你的好朋友。
C++中通过std::fstream配合std::ios::binary实现二进制文件读写,1.使用std::ifstream读取时需指定std::ios::binary模式以避免数据转换,适用于图像、音频等原始字节处理。
C++中通过fstream类结合ios::binary标志实现二进制文件读写,使用write()和read()函数以字节形式存取数据,支持整数数组、结构体等原始内存布局数据的高效操作。
答案:C++通过fstream类以ios::binary模式读写二进制文件,使用write()和read()方法直接操作内存数据,需注意结构体对齐、类型大小、字节序等跨平台问题,建议采用序列化工具提升兼容性,确保读写数据一致性。

PHP是一种广泛应用于Web开发的语言,它提供了许多用于处理文件的函数及方法。在PHP中,我们可以使用二进制模式来读写文件,这种方式可以提高文件操作的效率,特别是在处理二进制文件时。在本文中,我们将探讨PHP中的二进制文件读写操作,以及该如何使用这种方式来处理二进制文件。什么是二进制文件?二进制文件是指由纯二进制表示的文件,其内容有可能包含不同编码的字符集,

朗读女如何将文字转换成语音文件?朗读女是一款免费的语音朗读软件,用户可以通过这款软件来朗读电脑中的一些文本文件,包括小说、文档、资料等文件,如果用户不想用眼睛看的话就可以通过朗读的方式来了解到一些文字内容了,同时这款软件还可以帮助我们将文字转换成语音文件,这样就更加方便用户处理一些文字内容了,介于有的用户不知道要如何使用这款软件,正软小编就来跟大家分享一下具体要怎么用它来将文字转换成语音文件吧,有需要的朋友不妨一起来看看小编分享的这篇方法教程。
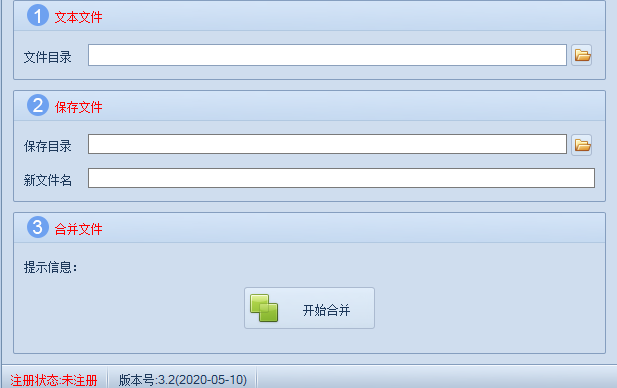
远方txt文本文件快速合并工具如何合并TXT文件?远方txt文本文件快速合并工具是一款专门针对TXT文件进行合并的工具,很多用户在使用电脑的时候都会下载一些小说,如果下载的章节都是零散的话我们可以将它转换成TXT格式,然后通过这款软件将TXT文本全部合并成一个文件,这样用户在看小说的时候就更加方便了,想必有很多用户都会需要用到合并TXT文件的功能,那么正软小编今天就来跟大家分享一下使用远方txt文本文件快速合并工具合并TXT文件的操作方法吧,感兴趣的朋友不妨一起来看看这篇方法教程。
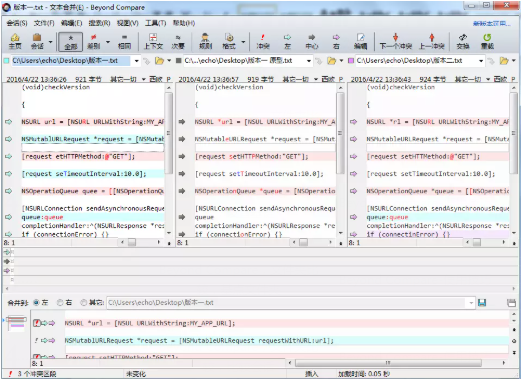
Beyond Compare文本合并有哪些内容?Beyond Compare软件是一款专业的文件夹以及文件比较工具,可以快速对比出文件之间的差异,除了强大的对比功能,也同时支持文件夹以及文本的合并操作。或许您对Beyond Compare文本合并会话还不太了解,接下来正软小编就和大家简单讲解一下,Beyond Compare文本合并的内容。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



