

Pandas lreshape重构Excel宽表数据方法
本文详细介绍了如何使用PythonPandas库中的lreshape函数,高效地将具有重复列模式的宽格式Excel表格数据重构为规范化的长格式数据。通过具体的代码示例,演示了从内存中的DataFrame和直接从Excel文件两种场景下的数据转换过程,并探讨了lreshape在处理此类特定数据结构时的优势,帮助用户将复杂数据转化为更易于分析和处理的结构。

引言:宽格式数据重构的挑战
在数据处理和分析中,我们经常会遇到一种特殊的“宽格式”数据,其特点是包含大量重复的列组。例如,一个 Excel 表格可能包含多组产品ID和对应的价格,如 id_m00 和 mprice、id_m01 和 mprice,甚至重复几十次。这种结构虽然在某些场景下便于人工查看,但对于程序化处理和后续的数据分析(如聚合、可视化)而言,却是一种低效且难以操作的格式。我们通常需要将其转换为“长格式”或“规范化”的数据,即每行代表一个独立的观测值,所有相关信息都集中在少数几个关键列中。
考虑以下示例数据结构:
| Date | id_m00 | mprice | id_m01 | mprice |
|---|---|---|---|---|
| 01.01.2023 | aa-bb-cc | 12,05 | dd-ee-fr | 8,80 |
| 02.01.2023 | aa-dd-ee | 09,55 | ff-gg-gg | 7,50 |
我们的目标是将其重构为以下长格式:
| Date | id | mprice |
|---|---|---|
| 01.01.2023 | aa-bb-cc | 12,05 |
| 02.01.2023 | aa-dd-ee | 09,55 |
| 01.01.2023 | dd-ee-fr | 8,80 |
| 02.01.2023 | ff-gg-gg | 7,50 |
传统的 pandas.melt 函数在处理这种带有重复列名(如多个 mprice 列)且需要将特定列组(如 id_mXX 和对应的 mprice)配对转换时,往往会产生额外的空值列或不符合预期的结果。在这种情况下,pandas.lreshape 提供了一个更精准、更强大的解决方案。
Pandas lreshape:高效重塑工具
pandas.lreshape 函数专为处理这种具有固定模式的宽格式数据而设计。它允许你通过一个字典来指定如何将多个旧列组映射到新的列。这个字典的键是新 DataFrame 中的列名,而值是一个列表,包含旧 DataFrame 中对应新列的多个来源列。
它的核心优势在于能够根据预定义的模式,将多个相关的列(例如,id_m00, id_m01, id_m02 和它们各自对应的 mprice 列)聚合到单个新列下,同时保持它们之间的对应关系。
实践示例一:内存中的DataFrame重塑
假设我们已经将 Excel 数据读取到一个 Pandas DataFrame df 中。为了演示,我们先手动创建一个模拟的 DataFrame:
import pandas as pd
import io

# 模拟原始宽格式数据
data = """Date,id_m00,mprice,id_m01,mprice.1
01.01.2023,aa-bb-cc,12.05,dd-ee-fr,8.80
02.01.2023,aa-dd-ee,09.55,ff-gg-gg,7.50
"""
df = pd.read_csv(io.StringIO(data), sep=',')

# 打印原始DataFrame,注意mprice列在读取时会被自动重命名为mprice.1等
print("原始 DataFrame:")
print(df)
原始 DataFrame 输出:
原始 DataFrame:
         Date    id_m00  mprice    id_m01  mprice.1
0  01.01.2023  aa-bb-cc   12.05  dd-ee-fr      8.80
1  02.01.2023  aa-dd-ee    9.55  ff-gg-gg      7.50
可以看到,由于存在重复的列名 mprice,Pandas 在读取时会自动将其重命名为 mprice.1。这是默认行为,反而简化了后续处理。
现在,我们使用 lreshape 来重塑数据:
# 分离出所有的mprice列,并重新命名它们的列索引,以便lreshape能够正确匹配
# 注意:这里我们使用了原始数据中mprice被Pandas自动重命名后的列名
price_columns = df.filter(like="price").columns
prices = df[price_columns].pipe(lambda x: x.set_axis(range(len(x.columns)), axis=1))

# 从原始df中移除这些price列,以便后续concat
df_ids = df.drop(columns=price_columns)

# 将处理过的id列和price列重新合并,为lreshape做准备
df_combined = pd.concat([df_ids, prices], axis=1)

# 使用lreshape进行重塑
# 'id' 对应原始DataFrame中所有以 'id_m' 开头的列
# 'mprice' 对应我们处理过的所有价格列(其列名已简化为0, 1, 2...)
out = pd.lreshape(
    df_combined,
    {"id": df_combined.filter(like="id_m").columns, "mprice": prices.columns}
)

# 打印重塑后的结果
print("\n重塑后的 DataFrame:")
print(out)
代码解析:
- price_columns = df.filter(like="price").columns: 筛选出所有包含“price”字符串的列名,包括 mprice 和 mprice.1 等。
- prices = df[price_columns].pipe(lambda x: x.set_axis(range(len(x.columns)), axis=1)):
- df[price_columns]:从原始 DataFrame 中选择所有价格相关的列。
- .pipe(lambda x: ...):允许将 DataFrame x 作为参数传递给一个函数,并返回函数的结果。这是一种链式操作的优雅方式。
- x.set_axis(range(len(x.columns)), axis=1):将这些价格列的列名重命名为简单的整数序列(0, 1, 2...)。这样做是为了让 lreshape 能够更容易地将它们与 id_mXX 列进行匹配,因为 lreshape 会按顺序匹配 id 列表和 mprice 列表中的元素。
- df_ids = df.drop(columns=price_columns):创建一个只包含 Date 和 id_mXX 列的新 DataFrame。
- df_combined = pd.concat([df_ids, prices], axis=1):将处理过的 id 列部分和重命名列后的 prices 部分水平拼接起来。
- pd.lreshape(df_combined, {"id": df_combined.filter(like="id_m").columns, "mprice": prices.columns}):
- 第一个参数是待重塑的 DataFrame (df_combined)。
- 第二个参数是一个字典,定义了如何重塑:
- 键 "id":表示新 DataFrame 中将出现的列名。
- 值 df_combined.filter(like="id_m").columns:一个列表,包含了原始 DataFrame 中所有以 "id_m" 开头的列名 (id_m00, id_m01 等),它们将被收集到新的 id 列下。
- 键 "mprice":表示新 DataFrame 中将出现的另一个列名。
- 值 prices.columns:一个列表,包含了我们之前重命名后的价格列名(0, 1 等),它们将被收集到新的 mprice 列下。
- lreshape 会根据这些列表的顺序进行匹配:id_m00 和 mprice (列0) 配对,id_m01 和 mprice.1 (列1) 配对,以此类推。
重塑后的 DataFrame 输出:
重塑后的 DataFrame:
         Date        id  mprice
0  01.01.2023  aa-bb-cc   12.05
1  02.01.2023  aa-dd-ee    9.55
2  01.01.2023  dd-ee-fr    8.80
3  02.01.2023  ff-gg-gg    7.50
实践示例二:直接从Excel文件重塑
如果原始数据直接来源于 Excel 文件,并且 Pandas 在读取时已经自动处理了重复列名(例如,mprice, mprice.1, mprice.2...),那么重塑过程可以进一步简化。
假设你的 Excel 文件名为 file.xlsx,并且其内部结构与前面描述的示例一致。
import pandas as pd

# 假设 file.xlsx 存在且包含上述示例数据
# df = pd.read_excel("file.xlsx") # 实际使用时请取消注释并指定文件路径

# 为了演示,我们继续使用之前创建的df,模拟read_excel后的DataFrame
# 此时,df 已经包含了 mprice 和 mprice.1 等列
print("\n模拟从 Excel 读取的 DataFrame:")
print(df)

# 直接使用lreshape进行重塑
out_simplified = pd.lreshape(
    df,
    {"id": df.filter(like="id_m").columns,
     "mprice": df.filter(like="price").columns}
)

# 打印简化后的结果
print("\n简化重塑后的 DataFrame:")
print(out_simplified)
代码解析:
- df = pd.read_excel("file.xlsx"):直接从 Excel 文件读取数据。Pandas 会自动处理重复的列名,如 mprice 会被重命名为 mprice.1, mprice.2 等。
- pd.lreshape(df, {"id": df.filter(like="id_m").columns, "mprice": df.filter(like="price").columns}):
- 这里不再需要手动分离和重命名 mprice 列。
- df.filter(like="id_m").columns 会获取所有 id_mXX 形式的列名。
- df.filter(like="price").columns 会获取所有 mprice、mprice.1 等价格列名。
- lreshape 会智能地根据列名的字母数字顺序(例如,mprice 在 mprice.1 之前)进行匹配,将第一个 id_mXX 与第一个 mprice 列配对,第二个 id_mXX 与第二个 mprice 列配对,以此类推。这依赖于 Pandas 读取 Excel 时对重复列名的默认排序行为。
这种方法更简洁,因为它利用了 Pandas 自动处理重复列名的特性。
注意事项与最佳实践
- 列名模式的一致性: lreshape 的强大之处在于它依赖于列名中的模式。确保你的宽格式数据中,需要重塑的列组(如 id_mXX 和 mprice)具有清晰且一致的命名模式,这样 filter(like=...) 才能准确地选取它们。
- lreshape 与 melt 的选择:
- melt 更适用于将“度量”列(values)转换为行,通常伴随着一个或多个“标识符”列(id_vars)。当你的数据中没有明确的重复列组,而是需要将多个值列堆叠起来时,melt 是首选。
- lreshape 则专长于处理具有固定模式的重复列组。如果你的数据是 (A1, B1), (A2, B2), ..., (An, Bn) 这样的结构,并且你想把 A 们合并成一个新列,B 们合并成另一个新列,同时保持 Ai 和 Bi 的对应关系,那么 lreshape 是更优的选择。在本例中,它避免了 melt 可能产生的额外空值列。
- 数据类型: 重塑后,新生成的列(如 id 和 mprice)的数据类型将由其原始来源列的数据类型决定。如果原始列包含混合数据类型,重塑后可能会导致数据类型变为 object。必要时,需要进行类型转换,例如 pd.to_numeric(out['mprice'].str.replace(',', '.')) 来处理逗号作为小数分隔符的情况。
- 性能: 对于非常大的数据集,lreshape 的性能通常优于一些手动循环或复杂的多步 merge/concat 操作,因为它在 C 语言层面进行了优化。
总结
pandas.lreshape 是一个在 Python 中处理特定类型宽格式数据重构的强大而高效的工具。它能够精准地将具有重复模式的列组(如 id_mXX 和对应的 mprice)转换为规范化的长格式,极大地简化了数据预处理的流程。通过理解其工作原理和灵活运用 filter(like=...) 等辅助函数,你可以轻松地将复杂的数据结构转化为更利于分析和可视化的形式。
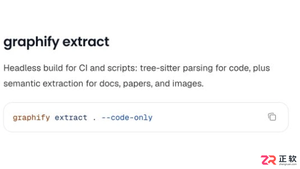
面向需要在无网或受限网络环境下使用Graphify的开发者,明确其离线运行的边界条件。纯代码构图和读取本地图谱可在依赖就绪后完全离线进行;文档语义处理需预先配置本地Ollama模型并指定后端。本文详解如何通过--code-only参数避免联网调用、如何准备本地模型环境,以及区分本地文件读取与远程MCP服务连接的关键步骤,帮助用户实现真正的本地化知识图谱构建。
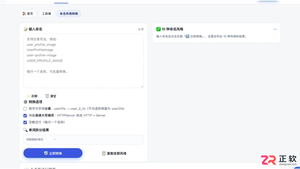
面向需要在camelCase、snake_case、kebab-case等格式间转换变量名和字段名的开发者,本文对比三款中文界面工具。马上默适合批量处理并支持词元拆分检查,能精细控制缩写与数字边界;摩卡工具箱界面简洁,聚焦四种常用风格快速互转;UniKit则一次性提供十种命名风格结果,便于横向比较。针对缩写切分和数字连接等常见差异,文章说明了各工具的适用场景及核对要点,帮助用户根据项目规范选择合适方案。
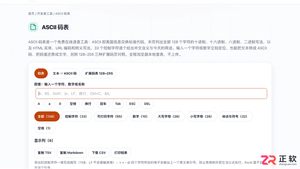
面向需要查询ASCII码值或进行文本编码转换的开发人员,本文对比三款中文在线工具。小鹿tools提供完整的0-127标准码表及控制字符详解,支持多种进制并排查看;Toolbase适合快速筛选特定字符或码值,界面直观;易白工具专注于整段文本与十进制、十六进制等序列的互转,适用于串口数据核对。需注意扩展ASCII并非统一标准,处理中文或Emoji时应使用Unicode工具。
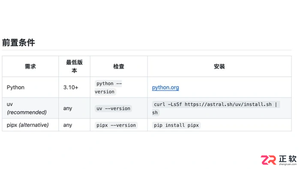
面向需要在本地部署Graphify工具的开发人员,本文详解基于Python 3.10+环境的安装流程。针对用户常遇到的依赖冲突问题,推荐使用uv或pipx创建独立运行环境。内容涵盖graphifyy官方包的安装验证、CLI命令可用性检查,以及针对Claude Code等编码助手的技能注册步骤,帮助读者快速完成从环境准备到功能集成的全过程。
面向需要优化前端界面的开发者,Impeccable借助AI编程助手辅助改进具体页面。它常用于评审页面技术质量、调整移动端与桌面端布局,以及简化复杂界面以降低认知负荷。使用时需针对不同目标选择专用命令,如audit用于检查问题,adapt用于设备适配,distill用于精简内容。本文介绍如何通过明确指令聚焦单一任务,避免一次性重构整个项目,并在修改后通过实际业务流程验证功能完整性。
面向需要使用AI辅助科研工作的用户,Scientific Agent Skills通过封装常用工具的操作规范,帮助AI Agent完成数据整理、统计分析、科学绘图及专业研究工作流。针对科研中工具调用复杂、流程断层的痛点,本文介绍其核心能力:串联Polars等库进行数据检查与清洗;利用statistical-analysis技能指导组间比较、回归分析及结果报告规范;以及执行如scanpy单细胞测序等专业领域分析流程。注意实际效果取决于所选技能、依赖环境及数据条件,关键结论仍需人工核对。
面向需要区分DeepSeek交互模式的用户,本文对比DeepSeek SuperAgent原型与网页聊天的核心差异。网页聊天提供即时问答入口,适合临时咨询;SuperAgent围绕代码仓库接收事件、判断授权并管理工单,需部署Harness及运行主机。文章从工作流程、权限机制及协作方式解析两者定位,帮助用户根据是否需持续跟进Issue或交付PR选择合适工具,避免混淆模型等级与功能边界。
面向使用AI编程助手进行前端开发的用户,介绍Impeccable工具在维护产品一致性与视觉规范中的工作流。针对开发中容易忽视的设计细节与上下文缺失问题,本文详解如何通过/impeccable init建立产品上下文,利用/impeccable document记录DESIGN.md视觉规则,并通过critique和polish命令评审与优化特定页面。同时涵盖终端命令行检测npx impeccable detect的使用场景,帮助开发者在限定范围内高效完成代码修改与流程验证。
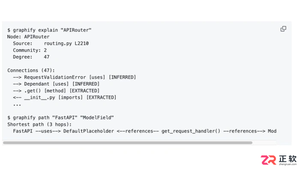
面向需要快速上手陌生项目的开发者,Graphify通过构建代码与文档的知识图谱,帮助理清函数调用关系及模块依赖。它能将代码结构与设计文档、PDF等多模态资料整合,为AI编码助手提供精准的项目上下文。本文介绍如何使用explain和path命令追踪调用路径,处理不同格式的输入文件,以及根据任务需求选择查询、更新或导出HTML、JSON等格式,从而高效定位线索并核查影响范围。
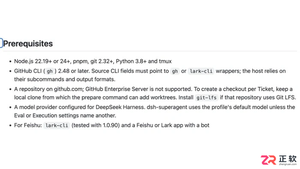
面向需要部署 DeepSeek SuperAgent 的开发人员,说明其非双击即用特性及前置依赖。本文梳理命令行工具(Node.js、pnpm、Git等)的版本检查要点,强调模型服务连通性验证方法。重点解析智能体专用 GitHub 账号的隔离配置、权限授予及 gh 包装命令登录流程,并指导规划独立工作目录与状态存储,确保工单派发前的环境安全与数据备份,避免权限混淆与数据丢失风险。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



