

Python处理JSON嵌套结构技巧
json_normalize是pandas用于处理嵌套JSON数据的工具。1.理解嵌套JSON结构,如包含字典和列表的多层结构;2.使用json_normalize可将嵌套数据拍平成表格形式,地址字段通过点号路径展开;3.利用explode展开列表字段,每个元素单独一行,或合并为字符串显示;4.处理复杂嵌套时可通过record_path指定路径提取深层字段,结合max_level控制展开层级。
json_normalize 是 pandas 用于处理嵌套 JSON 数据的工具。1. 理解嵌套 JSON 结构,如包含字典和列表的多层结构;2. 使用 json_normalize 可将嵌套数据拍平成表格形式,地址字段通过点号路径展开;3. 利用 explode 展开列表字段,每个元素单独一行,或合并为字符串显示;4. 处理复杂嵌套时可通过 record_path 指定路径提取深层字段,结合 max_level 控制展开层级。
处理JSON嵌套结构在Python中是一个常见的任务,尤其是在从API获取数据时。json_normalize 是 pandas 提供的一个非常实用的工具,能将嵌套的 JSON 数据“拍平”成表格形式,方便后续分析。
1. 理解什么是嵌套JSON
在实际工作中,我们经常遇到类似如下的结构:
data = [
    {
        "id": 1,
        "name": "Alice",
        "address": {
            "city": "Beijing",
            "zip": "100000"
        },
        "hobbies": ["reading", "cycling"]
    },
    {
        "id": 2,
        "name": "Bob",
        "address": {
            "city": "Shanghai",
            "zip": "200000"
        },
        "hobbies": ["gaming"]
    }
]
这个结构中包含了字典嵌套和列表,直接用 pd.DataFrame(data) 处理的话,有些字段还是嵌套的,不方便查看和分析。
2. 使用 json_normalize 基础用法
pandas.json_normalize() 的基本作用就是把嵌套结构展开成列。你可以这样使用它:
import pandas as pd

df = pd.json_normalize(data)
print(df)
输出结果会是这样的 DataFrame:
| id | name | address.city | address.zip | hobbies |
|---|---|---|---|---|
| 1 | Alice | Beijing | 100000 | [reading, cycling] |
| 2 | Bob | Shanghai | 200000 | [gaming] |
这样地址信息就被“平铺”出来了。
提示:
- 如果你只想要某些字段,可以加
record_path参数指定路径。 - 想要展开列表类型字段(比如 hobbies),可以结合
max_level=1或者使用explode。
3. 展开列表字段的技巧
上面的例子中,hobbies 字段是列表,如果我们想把每个爱好单独一行,可以用 explode:
df = df.explode("hobbies")这样原来的一行可能会变成多行,例如 Alice 就会有两行记录,分别对应 reading 和 cycling。
如果你希望保留原始结构但又不想丢掉列表中的多个值,也可以考虑把这些值合并成字符串:
df["hobbies"] = df["hobbies"].apply(lambda x: ", ".join(x))
这样显示更直观,适合展示类用途。
4. 更复杂的嵌套怎么处理?
当结构更深的时候,比如:
{
    "user": {
        "profile": {
            "name": "Charlie",
            "contact": {
                "email": "charlie@example.com",
                "phone": "123456789"
            }
        }
    }
}
你可以通过点号表示法访问深层字段:
pd.json_normalize(data, max_level=10)
或者指定字段路径:
df = pd.json_normalize(
    data,
    record_path=["user", "profile"],
    meta=[["user", "profile", "contact", "email"]]
)
不过一般建议先用 max_level 试试看效果,再根据需要提取特定字段。
总的来说,json_normalize 虽然功能强大,但也不是万能的,有时候需要配合 apply、explode、rename 等操作一起使用。关键是理解原始结构,并有意识地控制输出格式。
基本上就这些,不复杂但容易忽略细节的地方在于字段路径和层级结构的匹配,稍不小心就会出错。
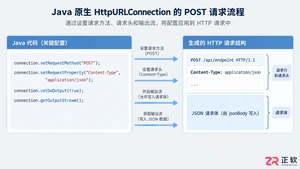
深入解析Java发送JSON格式POST请求的实现机制,对比原生API与第三方库的代码差异,提供可复制的代码示例,并探讨超时设置、编码处理及微服务场景下的例外情况。
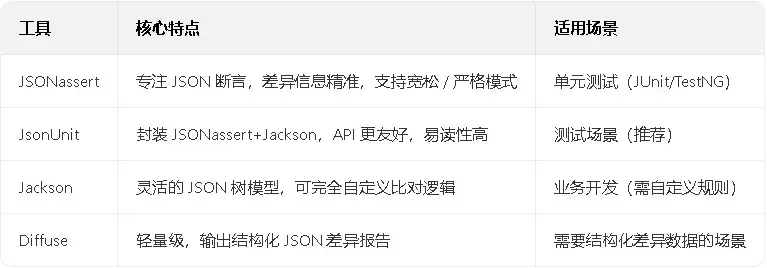
断言工具专为测试场景设计,支持宽松模式并精准定位差异;单元工具基于断言工具和杰克逊库封装,提供更友好的断言接口;杰克逊库作为主流处理库,可通过节点树模型自定义比对逻辑,适用于业务开发中精细控制差异的场景。
通过AJAX异步请求服务器获取JSON格式的表格数据,解析JSON对象后遍历数据条目,动态拼接成包含表格标签的HTML字符串,最后调用编辑器实例的setContent()方法将HTML写入编辑器,完成表格在编辑器内的初次渲染。
使用nlohmann/json库解析GeoJSONFeatureCollection,需逐层防御性访问features、geometry和properties,坐标数组维度不确定,需判断。坐标系和精度问题在解析层无法解决,应暴露原始坐标数组供上层处理。性能敏感时避免重复解析和深拷贝,可缓存并视口裁剪。
pandas.json_normalize 这个函数,说起来挺有意思的——很多人以为它能一键把嵌套 JSON 拍扁成表格,结果往往发现列名变成了一串带点的“火车”(比如 profile.address.city),真正棘手的问题却一个都没解决。字段缺失怎么办?列表嵌套怎么炸开?多层结构怎么拆?答案其





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



