

CoBEVFlow:解决车路协同感知的时序异步问题
本文经自动驾驶之心公众号授权转载,转载请联系出处。写在前面&个人理解协同感知技术能够有效解决单体感知中存在的障碍物遮挡、视角受限、以及远距离感知能力弱等问题。然而实际场景中存在着网络用塞、延迟等问题,协同感知受此影响,性能会严重下降,甚至低于单体感知效果。NeurIPS2023的最新研究文章《Asynchrony-RobustCollaborativePerceptionviaBird’sEyeViewFlow》将协同信息时间戳不对齐的协同感知任务定义为时序异步的协同感知(AsynchronyCollab
本文经自动驾驶之心公众号授权转载,转载请联系出处。
写在前面&个人理解
协同感知技术能够有效解决单体感知中存在的障碍物遮挡、视角受限、以及远距离感知能力弱等问题。然而实际场景中存在着网络用塞、延迟等问题,协同感知受此影响,性能会严重下降,甚至低于单体感知效果。NeurIPS 2023的最新研究文章 《Asynchrony-Robust Collaborative Perception via Bird’s Eye View Flow》将协同信息时间戳不对齐的协同感知任务定义为时序异步的协同感知(Asynchrony Collaborative Perception),来自上海交通大学、南加州大学、和上海人工智能实验室的研究者们在本文中提出了CoBEVFlow:基于鸟瞰图流(BEV Flow)的时序异步鲁棒的协同感知系统。实验效果表明,CoBEVFlow能有效缓解时序异步带来的影响。
- 论文链接:https://arxiv.org/abs/2309.16940
- 代码链接:https://github.com/MediaBrain-SJTU/CoBEVFlow
- 项目主页:https://sizhewei.github.io/projects/cobevflow/
CoBEVFlow的出发点
近年来,自动驾驶领域在学术界和工业界备受瞩目。但实际道路情况十分复杂,存在着行人、非机动车、不遵守交通规则的道路参与者甚至动物等各种特殊情况,这些情况都对自动驾驶技术的应用提出了极大挑战。针对单车部署传感器(如相机、激光雷达、毫米波雷达等),基于单车传感器的目标检测方法被称为单体感知。尽管在大多数情况下单体感知表现良好,但这种感知方法存在固有的局限性。单体感知依赖于自身的传感器,其感知能力受限于传感器的视角、有效距离和精度。例如,当传感器被遮挡、视角受限时,感知能力就会大幅下降,为智能体的后续认知和决策带来安全隐患。此外,对于远距离物体,激光雷达产生的点云过于稀疏,无法提供有效的位置信息,导致感知系统很难感知远距离的环境。下图展示了一个真实场景中的“鬼探头”问题,即在人类驾驶员面临视线遮挡时也会十分头痛
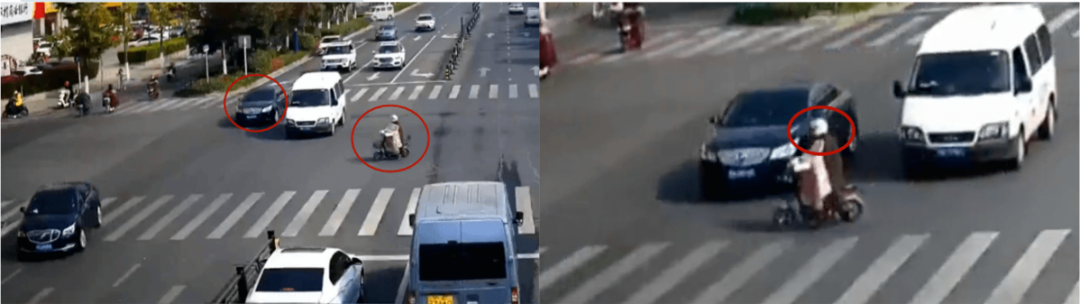 图 1. 视线遮挡造成的“鬼探头”问题令人类驾驶员也非常头痛!
多智能体之间的协同感知为单体感知存在的这些问题提供了解决方案。随着通信技术的发展,多个智能体之间可以利用通信共享彼此的信息,每个智能体可以结合自身传感器信息与其他智能体的信息,对周围环境进行感知。通过智能体之间的协作,每个智能体可以获取自身视野盲区与可视距离以外的信息,有助于提升每个智能体的感知以及决策能力。此外,协同感知也能减少智能体对于高精度长距离传感器的依赖,通过多个使用低精度、低成本传感器的智能体相互协作,达到甚至超过单个装配高精度传感器的感知能力。在现实世界中,由于通信延迟、拥塞、中断、时钟错位、以及采样频率不一致等等问题,智能体接收到的协作信息所带有的时间戳不一致是不可避免的。如图所示,蓝色车辆代表元智能体(ego agent),而另外两辆车在连续时间轴上的不同时刻传递协作信息。在这种情况下,元智能体收集到的信息发生在不对齐的时间戳上
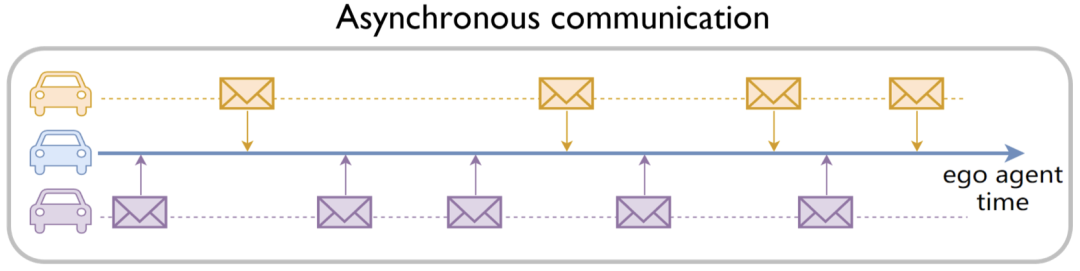 图 2. 异步通信示意图。来自不同智能体的协作信息带有的时间戳是连续时间轴上的任意值。
这个问题会导致多智能体融合过程中信息不匹配——来自不同智能体的协作信息中对同一个移动目标的位置信息是不同的,从而导致协同感知得到的感知结果甚至比单个智能体感知结果更差。如果忽视这个问题,仍然使用传统的协作感知方法,得到的协作感知结果如图所示。
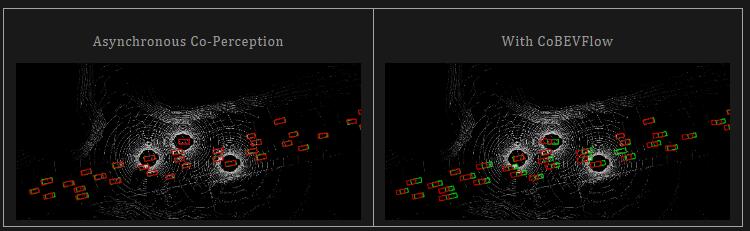
图 3. 协作信息时间戳不一致对协作感知造成的影响。红色表示感知结果,绿色表示真实值。左图为协作不一致的情况下,不使用CoBEVFlow的结果,右图为经过CoBEVFlow处理过的结果。
红色框表示检测结果,绿色框表示真实值,“错误的”协作信息会干扰元智能体的单体感知信息,导致结果甚至比单体感知结果。这也就意味着时间戳不对齐问题导致协作失去了意义。
为此,研究者们定义了异步协作感知(Asynchrony Co-Perception)任务。其中异步表示来自参与协作的智能体所传递的协作信息带有的时间戳不一致,而且来自同一个智能体的连续两帧信息之间的时间间隔是不固定的。基于这个问题,该文提出了基于鸟瞰流图(BEV Flow)的时序异步鲁棒的协同感知系统:CoBEVFlow。
CoBEVFlow的问题定义
研究人员首先对异步协同感知任务进行了数学定义:
每个智能体可以向其他智能体发送/接收协作信息,并存储来自任何智能体的最多 个历史帧的消息。每个智能体都有一个原始观察和感知真实值(ground truth),分别在当前时间 的,其中时间戳 是智能体的第 个时间戳, 是智能体在时间 发送给智能体 的协作消息。异步协作的关键是每个协作消息的时间戳 是一个连续值,来自其他智能体的这些消息不对齐,即 ,并且两个连续时间戳 之间的时间间隔是不固定的。因此,每个智能体会在任意时间接收到其他智能体发送的协作消息。因此,异步协作感知的任务可以表示为:
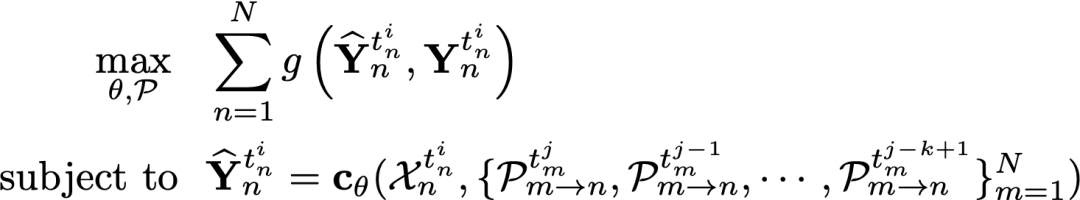
需要进行改写的内容为:其中一部分是感知评估指标,另一部分是智能体根据时间感知到的结果,还有一部分是具有可训练参数的协作感知网络,此外 $t_m^{j-k+1} 也需要考虑在内
CoBEVFlow的方法介绍
异步协作感知的本质问题是,来自多个智能体的协作信息可能给同一个移动目标记录不同时刻的位置信息。因此研究者们提出的CoBEVFlow用两个核心思路来解决这个问题:
- 生成一个感兴趣区域(ROI)集,后续只针对这些集合中的特征进行操作;
- 捕捉历史帧中这些感兴趣区域的运动趋势,根据运动趋势将对应位置的特征重新对齐到当前时刻的位置。
通过这两个思想,避免了直接修改特征,并保持了背景特征,因此CoBEVFlow不会引入不必要的噪声
CoBEVFlow的总体框架
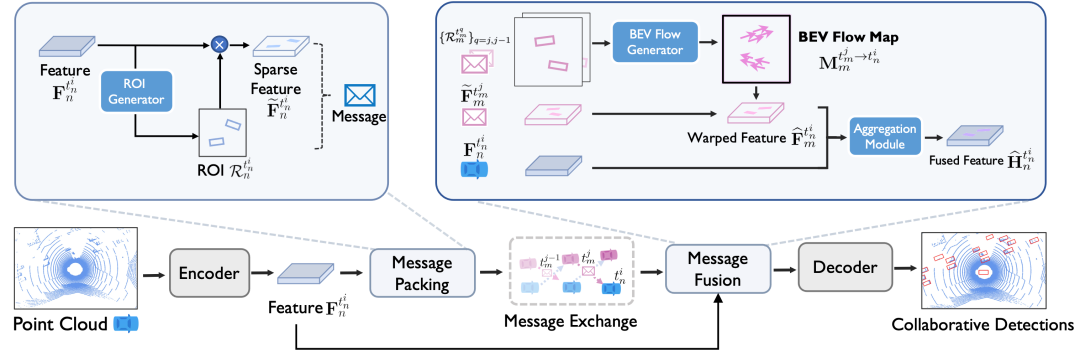 图 4. CoBEVFlow框架图。
如CoBEVFlow框架图所示,原始感知信息 通过编码器得到特征 。在Message Packing 模块中,特征通过 ROI 生成器得到 ROI集 ,同时作为掩码得到稀疏特征 ,每个智能体将ROI集和稀疏特征作为协作信息打包发送。智能体收到来自其他的智能体发送的协作信息之后,在Message Fusion模块中处理协作信息。基于来自同一智能体的过去 帧信息,通过Flow生成器生成鸟瞰流图(BEV Flow Map) ,并利用该流图,将稀疏特征图上的特征挪动到当前时刻的位置上,也即得到挪动后特征 。将处理好的特征与自身的特征进行融合得到融合后特征 ,随机进入解码器得到最后的感知结果 。
信息打包模块(Message Packing)
生成BEV特征图上的ROI集合,然后发送这些集合以及对应的稀疏特征。其中ROI生成器采用的网络架构和解码器一致,但是网络参数并不需要保持一致。这样做的目的是,让ROI生成器学习到更多关于单体感知的特征分布。
信息融合模块(Message Fusion)
捕捉这些ROI的运动趋势,叫做BEV Flow Map,利用BEV Flow来将异步的信息对齐到当前时刻,再进行融合。BEVFlow的生成包括两个关键步骤:
- 相邻时间戳的ROI匹配;
- BEVFlow估计。
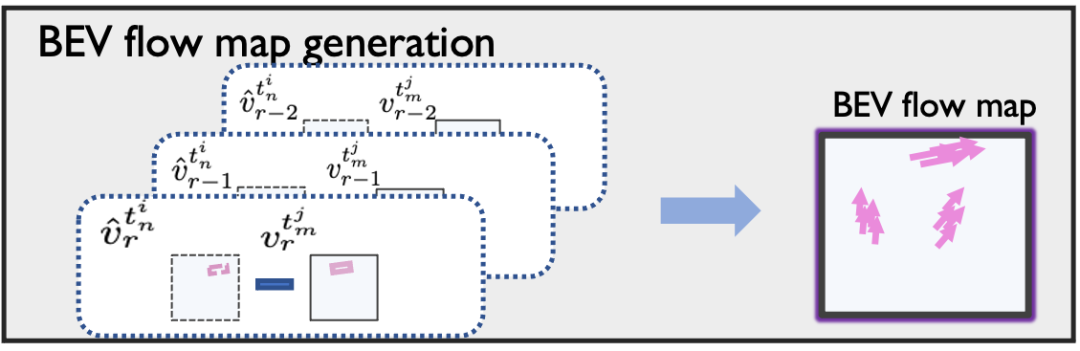 图 5. BEV Flow Map生成包括:ROI匹配和Flow生成过程。
相邻帧的ROI匹配:目的是匹配同一智能体在连续两个时间戳上发送的信息中的感兴趣区域(ROI)。匹配上的ROI本质上就是在不同时间戳下的同一个目标。匹配包含三个过程:成本矩阵构建、贪婪匹配和后处理。首先构建成本矩阵,其中每个值表示两个时间戳下两个ROI之间的匹配成本,矩阵中的每个值是基于角度和距离计算的。接着使用贪婪匹配策略来搜索配对的ROI。最后,后处理中通过删除匹配对中过大的值所代表的配对来避免无效匹配。
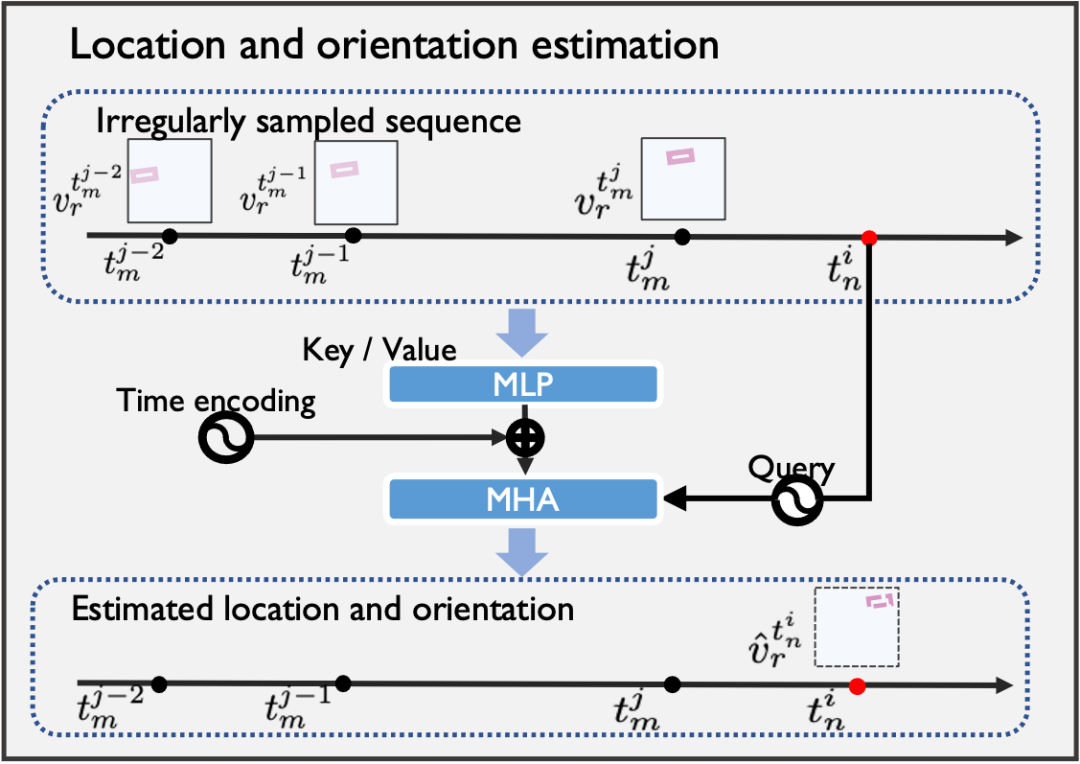 图 6. BEV Flow 估计示意图。
BEV Flow估计:检索每个ROI在一系列不规则时间戳下的历史位置。这个模块是一个基于注意力机制的模块,使用这些不规则的轨迹段来预测元智能体的当前时间戳下这些ROI的位置和方向,并生成相应的BEV Flow。与使用循环神经网络处理常规通信延迟的方法SyncNet(ECCV'22) 相比,生成的BEV Flow具有两个优点:i)它通过基于注意力机制的估计和适当的时间编码来处理不规则的异步情况;ii)它基于运动趋势的来移动特征,避免了重新生成整个特征图。
实验效果
为了验证CoBEVFlow的效果,研究者们在两个数据集上进行了实验。这两个数据集分别是IRV2V和DAIR-V2X。其中,IRV2V是本文提出的首个异步协作感知数据集,其中包含不同程度的时间异步性。而DAIR-V2X则是一个真实的数据集。实验的任务是基于点云的目标检测。评估检测性能时,使用了交并比(Intersection-over-Union,IoU)阈值为0.50和0.70,并采用平均精度(Average Precision,AP)作为评价指标
CoBEVFlow (红实线) 在异步情况下显著鲁棒
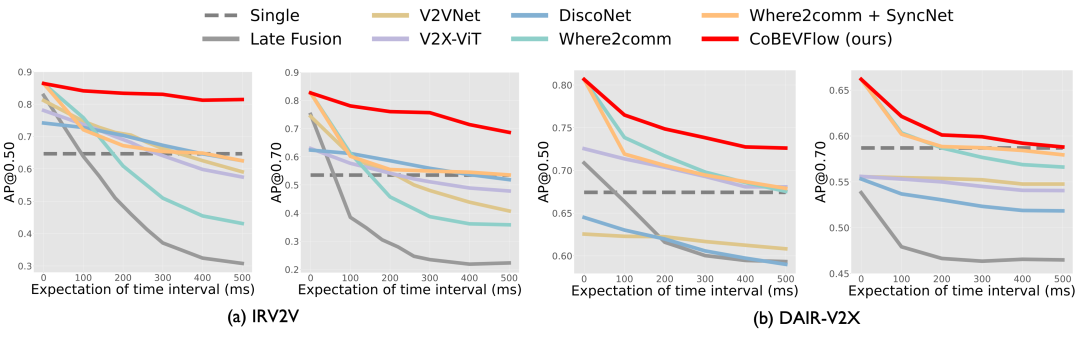 图 7. 在时间间隔期望值从 0 到 500 毫秒的情况下,CoBEVFlow 与其他基准方法的性能进行了比较。CoBEVFlow 在两个数据集上表现优于所有基准方法,并展现了在任何异步水平下的出色鲁棒性。
研究者们对比了现有的协同感知SOTA方法与CoBEVFlow在不同的异步程度下的感知结果。如图,红色虚线表示没有协作的单体检测,红色实线表示CoBEVFlow。所有方法均使用基于 PointPillars 的特征编码器。为了模拟时间异步性,研究者们使用二项分布对接收到的消息的帧间隔进行采样,以获取随机的不规则时间间隔。图中展示了在 IRV2V 和 DAIR-V2X 上,所提出的 CoBEVFlow 和SOTA方法在不同程度时间异步性下的检测性能(AP@IoU=0.50/0.70)比较,其中 x 轴是最新接收信息的延迟时间间隔和相邻帧之间的间隔的期望值,y 轴是检测结果。需要注意的是,当 x 轴为 0 时,表示为标准的协作感知没有任何异步性。可以看出:i)在所有异步程度下, CoBEVFlow 在模拟数据集(IRV2V)和真实世界数据集(DAIR-V2X)中均实现了最佳性能。在 IRV2V 数据集上,在 300ms期望间隔下,CoBEVFlow 在 AP@0.50 和 AP@0.70 方面分别比最好的SOTA方法提高了 23.3% 和 35.3%。类似地,在 500ms 间隔期望下,分别实现了 30.3% 和 28.2% 的提升。在 DAIR-V2X 数据集上,CoBEVFlow 依旧效果领先。ii)CoBEVFlow 表现出了显著的异步鲁棒性。如图中的红线所示,在不同的异步情况下,CoBEVFlow 在 IRV2V 数据集上仅出现 4.94% 和 14.0% 的 AP@0.50 和 AP@0.70 下降。这些结果远超过了单一目标检测的性能,甚至在极端的异步情况下也是如此。
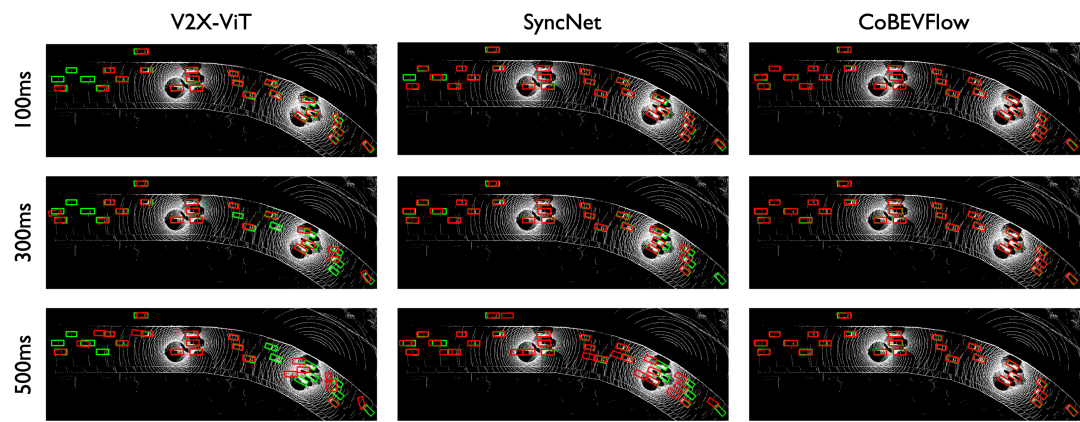
图 8. CoBEVFlow与SOTA方法在IRV2V数据集上的可视化对比,红色是预测结果,绿色是真实值。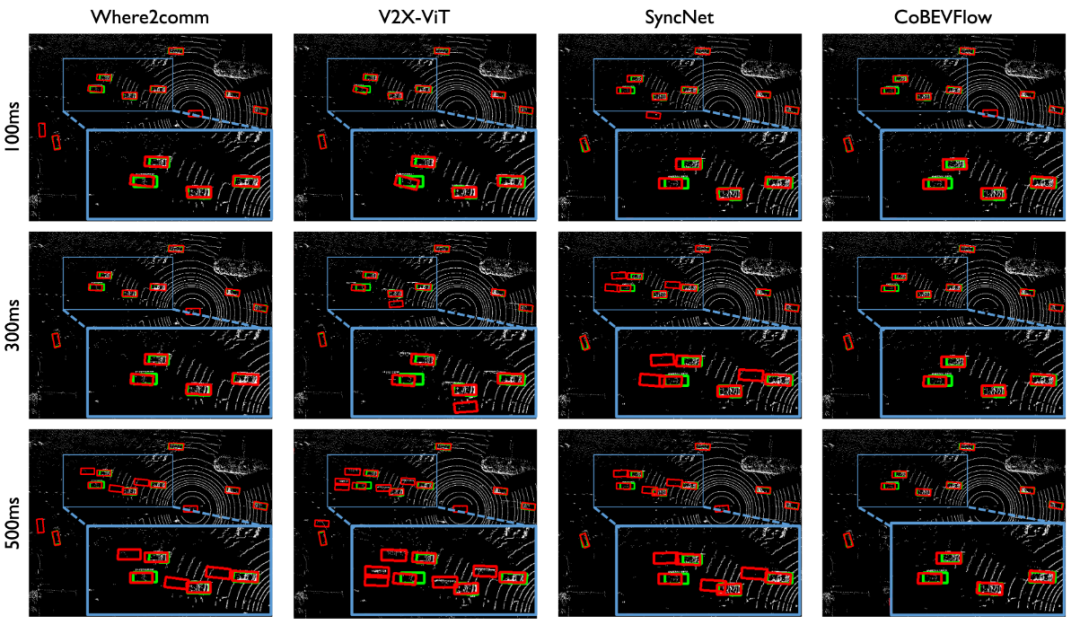 图 9. CoBEVFlow与SOTA方法在DAIR-V2X 数据集上的可视化对比。红色是预测结果,绿色是真实值。
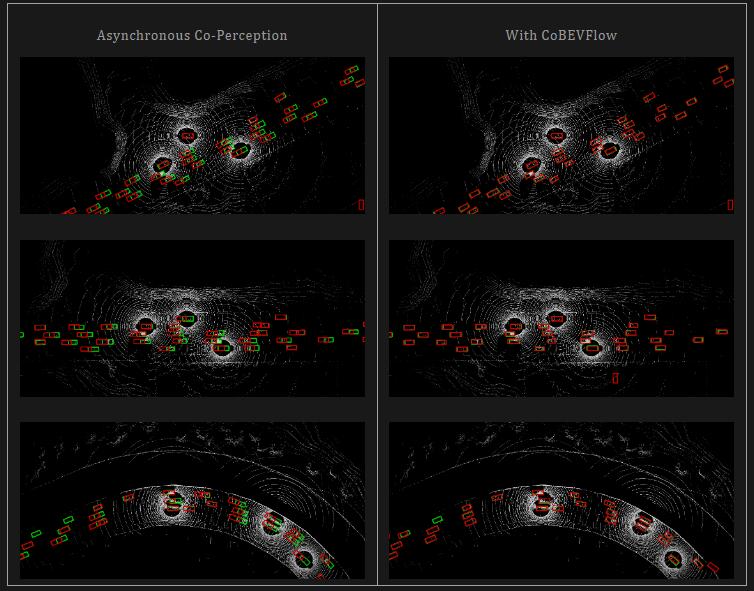
图 10. 时序异步情况下采用where2comm(左)直接进行协同感知的结果,与利用CoBEVFlow(右)进行协同感知的结果对比。红色为预测结果,绿色为真实值。
CoBEVFlow (红实线) 显著节省通信带宽
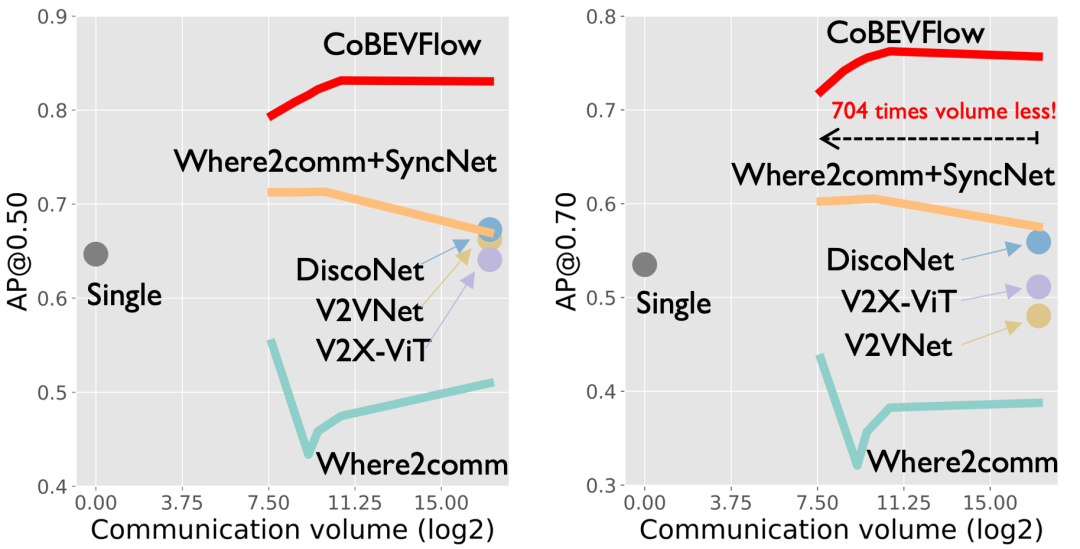 图 11. 感知性能与通信带宽之间的关系(时序异步期望为300ms)。
研究者们对比了不同方法的性能与通信带宽之间的关系。如图,红色实线表示CoBEVFlow。在时间异步的期望值为300毫秒的情况下,随着通信量的增加,CoBEVFlow的性能持续稳定提高,而where2comm和SyncNet的性能由于异步信息而导致性能波动。CoBEVFlow能够显著节省通信带宽的原因是,其协作信息只包含ROI区域中的稀疏特征以及ROI集,而不用整个特征图进行协作。
CoBEVFlow能够避免引入额外噪声
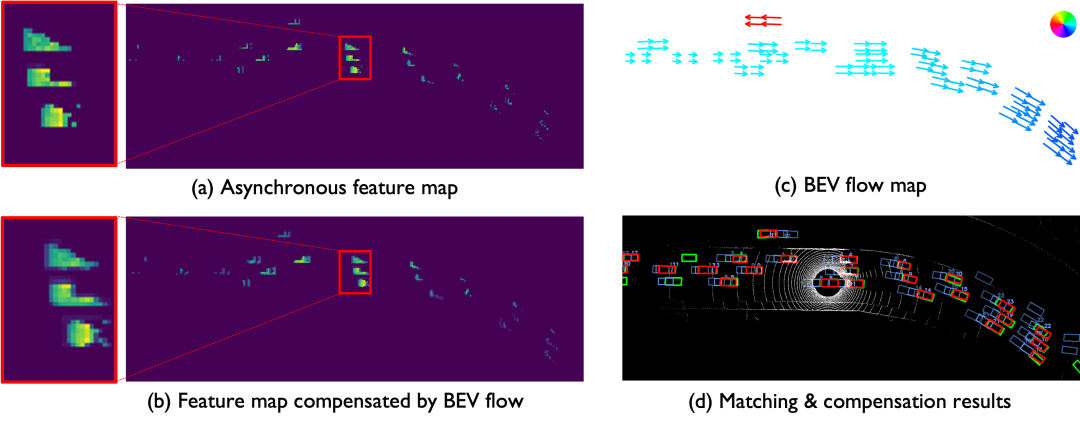 图 12. BEV Flow Map的效果可视化。(a)(b)分别是经过矫正前后的中间特征可视化,(c) 为BEV flow map的可视化,(d) 为匹配结果的可视化。
CoBEVFlow利用历史协作信息生成鸟瞰流图——BEV Flow Map,并根据流图,将BEV特征图上的“网格”特征找到新的对应的索引。这个过程的思想是“挪动”异步的特征到当前时刻对应的位置上,不涉及对于特征的数值变换,避免了引入额外的噪声(事实上,在挪动特征的过程中,用到了PyTorch内置的函数进行warp操作,存在着微小的差值误差)。研究人员们将原始的特征和挪动后的特征分别进行可视化,如图中的子图(a)、(b)。同时,将生成额BEV Flow Map以及ROI区域的配对结果进行了可视化,如图中的子图(c)、(d)。能从图中看出,该文提出的鸟瞰流图生成器对于不同帧中的ROI区域能够有效配对,也因此可以捕捉到ROI区域的运动趋势,并生成流图,用来矫正特征图。
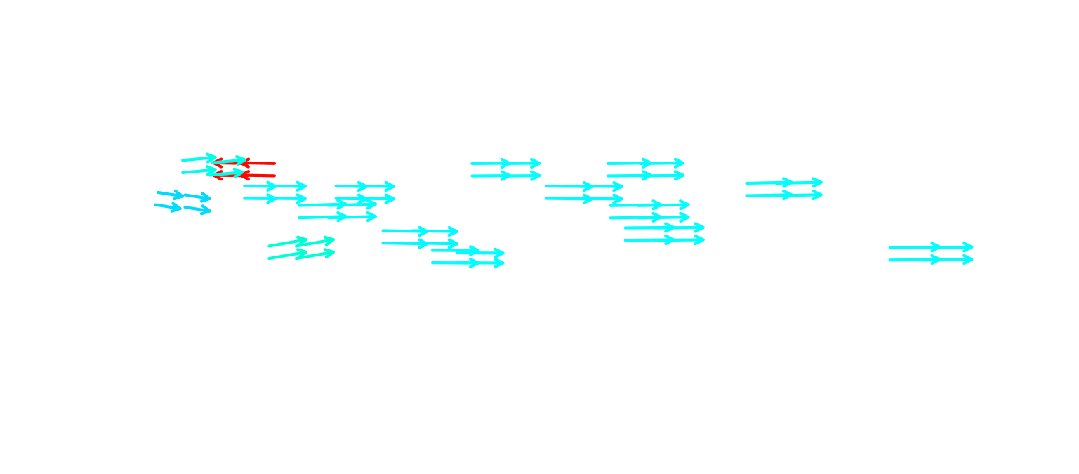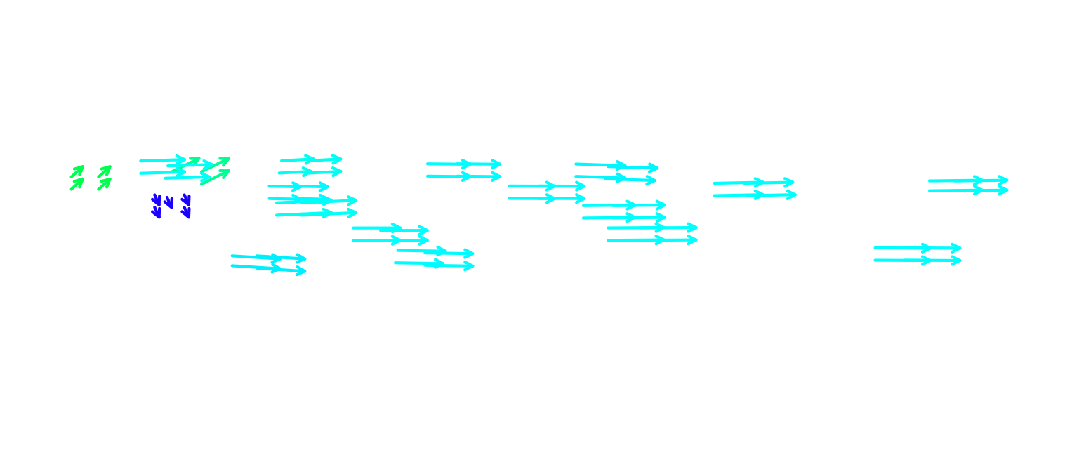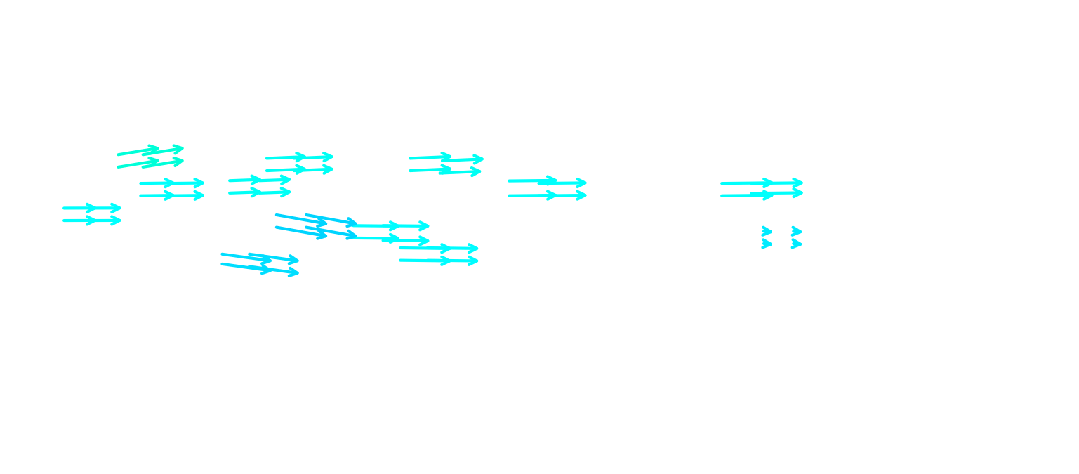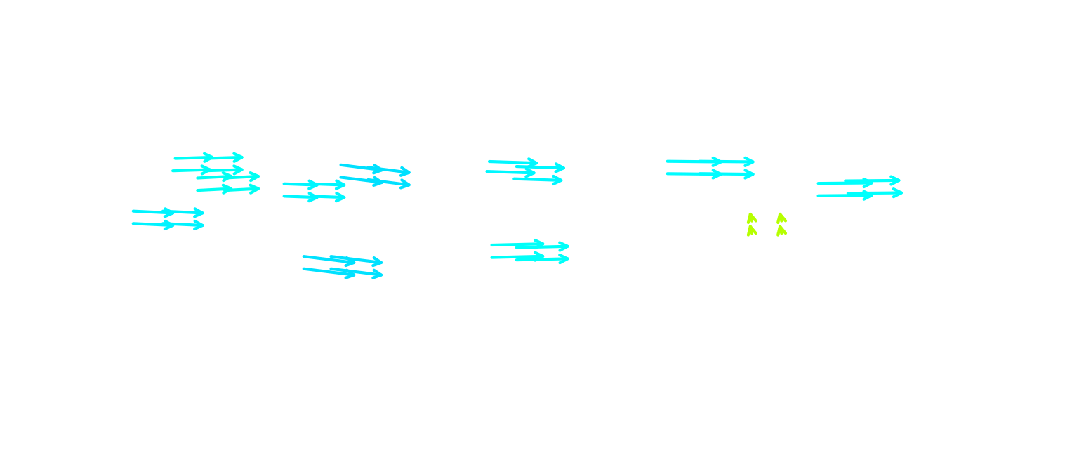 图 13. 鸟瞰流图的连续多帧可视化结果。
BEV Flow Map 作用在中融合优于后融合
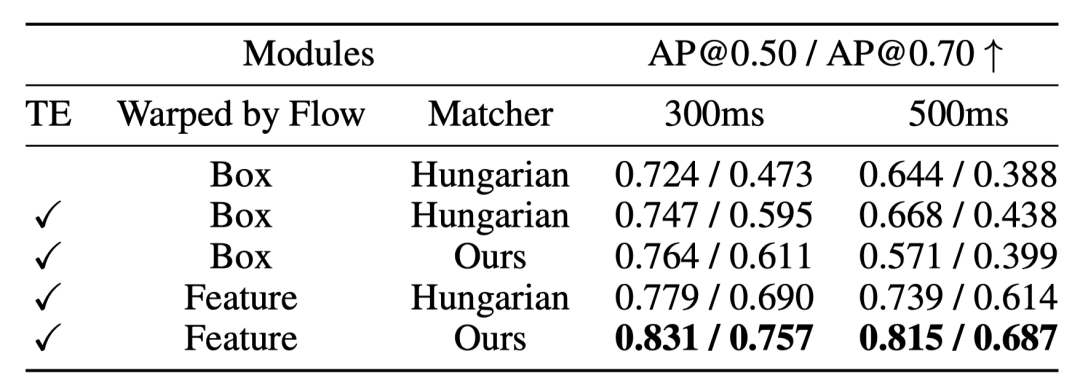 表 1 IRV2V数据集上的消融实验结果。
既然生成的BEV Flow Map能够准确捕捉ROI的运动趋势,那为什么不直接对检测框的位置进行矫正?研究人员们针对这个问题也在消融实验的部分进行了实验验证。如表格中的第3行和第5行的对比,能够看出,对于特征的矫正比对于检测框位置的矫正效果要好。研究人员猜测,可能是感兴趣区域对于单车检测未必是一个完整的物体,但是经过多车融合后的特征图,包含了来自多个协作者的信息,因此对于一些在单车视角下“不确定”的目标,中融合对于中间特征进行操作将更有优势。此外,消融实验中也进行了关于时间编码和不同的匹配算法的效果验证。
总结
CoBEVFlow关注解决协同感知中存在的时序异步问题。其提出的核心思路有两个:一是每个智能体发送的协作信息中应包含感兴趣区域与其对应的稀疏特征图。二是在协作感知时,基于收集到的历史信息生成BEV Flow,并用其“矫正”时序异步的特征。通过这两两个关键思路,CoBEVFlow能够有效处理包含延迟、中断、采样频率不一致等原因导致的时序异步问题,同时不会对特征图引入额外的噪声。
需要重新写的内容是:原文链接:https://mp.weixin.qq.com/s/BNFPPrQB4dVhm66p_ikqjA
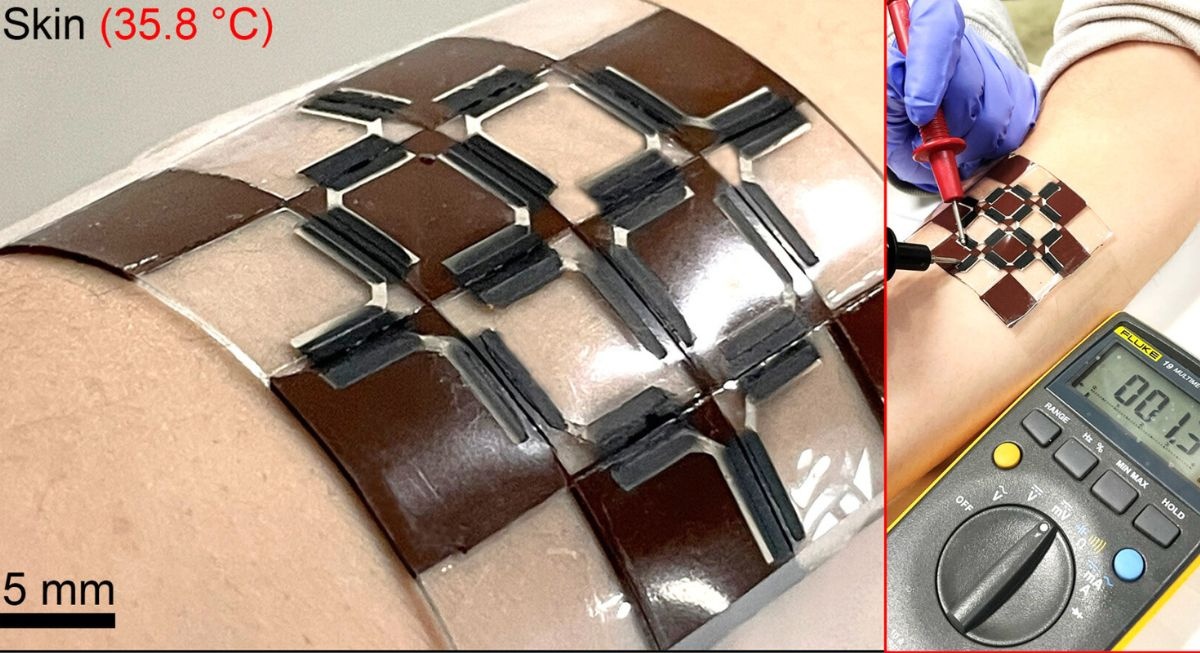
首尔大学突破性研究:完全平坦的可穿戴发电机,体温驱动未来 最近科技圈有个消息挺有意思。3月20日,知名科技媒体Notebook Check报道了首尔大学研究团队的一项新成果——一款完全平坦的可穿戴发电机。这项研究已经正式发表在权威期刊《科学进展》上,可以说是为“无电池”可穿戴设备撕开了一道新口子。
涂鸦智能成为联合国气候解决方案平台首批战略合作伙伴 11月14日传来一个值得关注的消息。在《联合国气候变化框架公约》第三十次缔约方大会期间,中国AI云平台服务商涂鸦智能,正式成为了联合国气候解决方案平台的全球首批战略合作伙伴之一。这意味着,未来各方都能通过这个平台,共享、验证并推广那些经过实践检验的
“我们的代码,终将写入繁星”:追觅科技成立天文BU,构建从地面到太空的生态闭环 “我们的代码,终将写入繁星。”这句来自追觅科技的宣言,不只是一句诗意的口号,更是一份清晰的战略升级路线图。就在9月10日,这家中国科技企业正式宣告成立天文业务单元(BU),由此完成了一次至关重要的战略跃迁。这标志着其“全
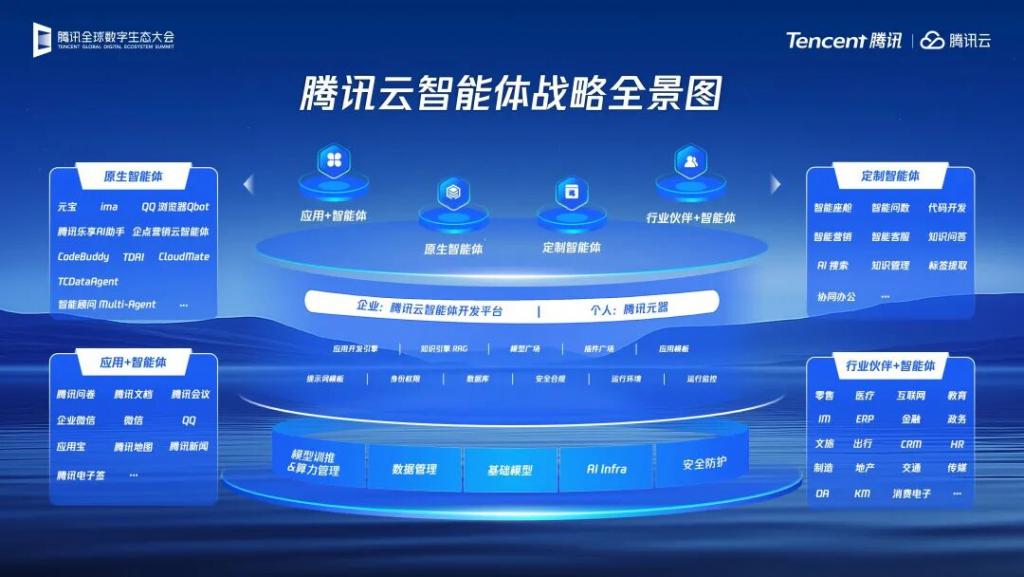
不谈智能体,客户都不见你。腾讯云副总裁、腾讯云智能负责人、腾讯优图实验室负责人吴运声在采访中坦言。这意味着,如今提供云服务,若没有智能体相关的硬核能力,已难以打动客户。在2025腾讯全球数字生态大会上,腾讯云给出了自己的回应:正式发布智能体开发平台3.0(ADP3.0),并宣布腾讯优图实验室的关键智能体技术将逐步开源。据悉,该版本历经近三个月集中迭代,累计上线近600项功能,在RAG能力、Workflow流程、多智能体协作、应用评测及插件生态等方面实现全面升级。更值得关注的是,腾讯云透露未来数月将持续开源
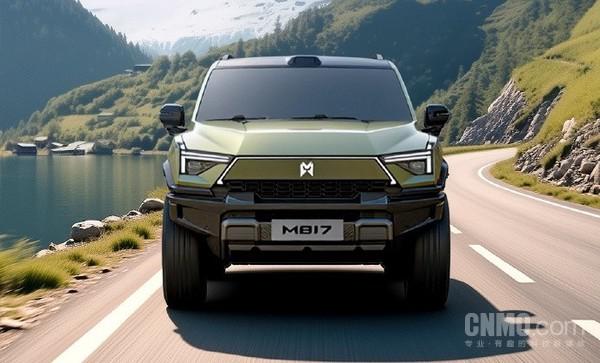
7月16日,CNMO得知,豪华智能越野SUV——猛士M817将于7月17日举办技术发布及新车预售活动。据了解,猛士M817全车搭载华为全栈智能解决方案,并将率先配备乾崑智驾ADS4。猛士M817作为东风猛士科技与华为合作的首个项目,猛士M817在华为全栈智能解决方案的支持下,实现了智能化、越野性能和高端定位的三重提升,使车辆具备类似人类的感知能力、思考能力和进化能力,为用户带来更加豪华、强悍、智能的出行体验。乾崑智驾ADS4让猛士M817实现了从车位到车位的
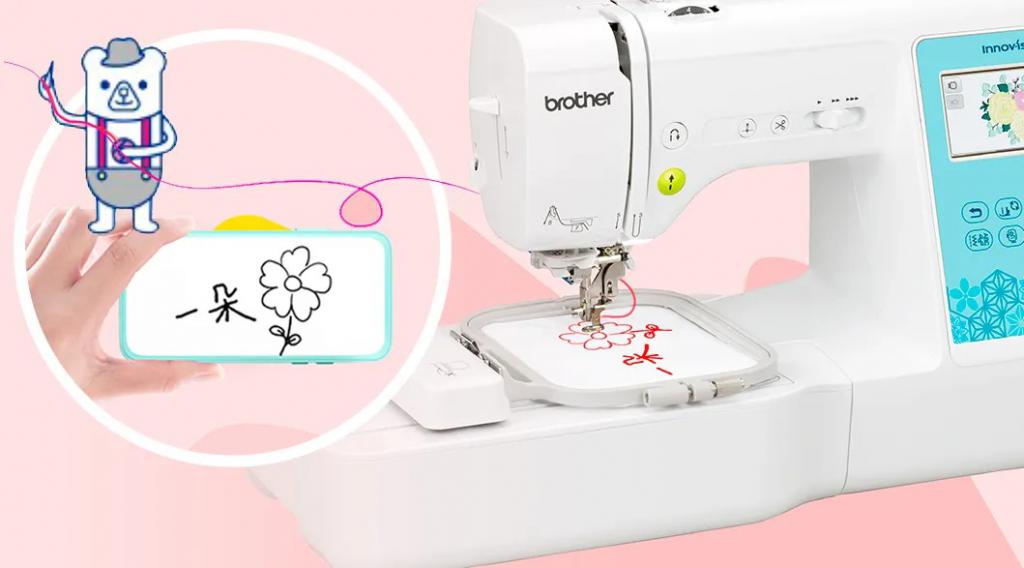
近日,兄弟(中国)商业有限公司宣布其智能刺绣设计应用“畅享绣”已完成iOS系统适配及操作体验优化,现已正式上线AppStore。苹果用户可通过iPhone或iPad设备,便捷地将手绘图案转化为刺绣作品,以科技力量赋能传统工艺,开启全民创意刺绣新纪元。此次iOS版本的发布,意味着“畅享绣”已全面覆盖安卓与苹果两大移动平台,使更多用户能够随时随地享受刺绣的乐趣。该应用程序致力于降低专业门槛,让每一位用户都能成为生活中的艺术创作者。以往,个性化刺绣需要依赖专业软件,操作繁琐。而“畅享绣”只需
只需动动嘴,就能操控GUI代理?由美团与浙江大学联合推出的GUIRoboTron-Speech——让你彻底解放双手,直接对设备“发号施令”。这是首个可以直接通过语音指令和屏幕截图进行端到端(End-to-End)决策的自主GUI智能体,致力于为用户提供更自然、高效且无障碍的人机交互方式。从文本到语音,智能代理的新一轮进化目前,基于大语言模型(LLMs)的自主GUI智能体已经能够通过文本指令自动完成跨应用、多步骤的复杂操作,显著提升用户效率。然而,这种依赖文本输入的方式在某些场景中存在明显局限
2025年CVPR会议:首届具身智能通用机器人操作研讨会及挑战赛(GRAIL)全球顶级计算机视觉与人工智能会议CVPR将于2025年6月11日至15日在美国田纳西州举行。届时,INRIA、华盛顿大学、MBZUAI等顶尖机构将联合举办首届具身智能通用机器人操作研讨会和挑战赛(GRAIL)。该研讨会旨在攻克机器人操作的通用性难题,推动通用机器人技术发展。研讨会亮点:聚焦挑战:真实世界机器人操作面临诸多挑战,例如处理多样化物体、适应不同场景变化以及执行未知任务。GRAIL研讨会将汇聚计算机视觉、

随着城市化进程的加速,车辆数量急剧增加,人们的停车难题愈发突出。实时智能停车系统的出现给了人们极大的方便,也提高了城市停车的管理效率。本文将从技术层面综述PHP实现实时智能停车系统的关键技术点。一、系统架构实时智能停车系统的架构一般分为前端和后端两个部分。前端主要提供地图显示、车位情况、缴费等功能,采用Html5、Css3和JavaScript等技术实现。后
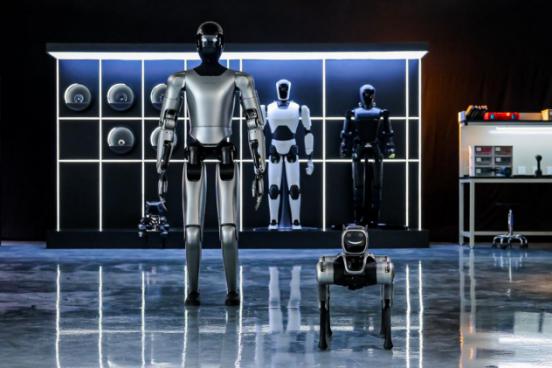
魔法原子发布会:人形机器人、四足机器人及“原子万象”大模型惊艳亮相3月26日,魔法原子举办“原子双生”2025场景战略发布会,重磅推出其人形机器人“小麦”和四足机器人,并首次发布端到端“原子万象大模型”。同时,公司启动“千景共创计划”,目标是与1000家合作伙伴合作,打造1000个基于人形机器人的应用场景。人形机器人“小麦”:加速工业和商业应用发布会上,“小麦”回顾了其过去一年的发展历程,从最初的经典控制路线,到如今的强化学习和模仿学习技术路线,其运动能力得到了显著提升,跑步速度已达2m/s,





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



