

Pandas多列重塑技巧:宽转长格式方法
本文探讨了在PandasDataFrame中将多列宽格式数据重塑为长格式的多种方法。通过示例,详细介绍了使用Pandas原生函数如melt与pivot、基于MultiIndex的高级重塑技巧,以及利用pyjanitor库中pivot_longer函数的便捷操作。旨在帮助用户高效地规整数据,使其更适合分析和可视化。

本文探讨了在Pandas DataFrame中将多列宽格式数据重塑为长格式的多种方法。通过示例,详细介绍了使用Pandas原生函数如`melt`与`pivot`、基于MultiIndex的高级重塑技巧,以及利用`pyjanitor`库中`pivot_longer`函数的便捷操作。旨在帮助用户高效地规整数据,使其更适合分析和可视化。
在数据分析和处理中,我们经常会遇到需要将DataFrame中的“宽格式”数据转换为“长格式”数据的情况。宽格式数据通常表现为,多个相关联的指标被分散在不同的列中,且列名中包含了这些指标的分类信息。例如,原始数据中可能包含 right_count, right_sum, left_count, left_sum 等列,我们希望将其重塑为 side, count, sum 三列,其中 side 列表示“right”或“left”,count 和 sum 列分别包含对应的值。这种转换对于后续的数据聚合、可视化和建模至关重要。
以下是一个典型的宽格式DataFrame示例:
import pandas as pd

df = pd.DataFrame({
    'date': ['2023-12-01', '2023-12-05', '2023-12-07'],
    'other_col': ['a', 'b', 'c'],
    'right_count': [4, 7, 9],
    'right_sum': [2, 3, 5],
    'left_count': [1, 8, 5],
    'left_sum': [0, 8, 4]
})

print("原始DataFrame:")
print(df)
期望的输出格式如下:
         date other_col   side  count  sum
0  2023-12-01         a  right      4    2
1  2023-12-05         b  right      7    3
2  2023-12-07         c  right      9    5
3  2023-12-01         a   left      1    0
4  2023-12-05         b   left      8    8
5  2023-12-07         c   left      5    4
接下来,我们将介绍几种实现这种数据重塑的有效方法。
方法一:使用 melt 和 pivot 进行数据重塑
pandas.melt 函数用于将DataFrame从宽格式转换为长格式,它会将指定的列“融化”成两列:一列包含原列名(通常命名为variable),另一列包含对应的值(通常命名为value)。之后,我们可以利用 str.split 分割 variable 列,并结合 pivot 函数将数据重新排列成我们需要的长格式。
# 步骤1: 使用 melt 函数将 'right_count', 'right_sum', 'left_count', 'left_sum' 列融化
# id_vars 指定不变的标识列
tmp = df.melt(id_vars=['date', 'other_col'], var_name='original_col_name')

# 步骤2: 从新的 'original_col_name' 列中分割出 'side' 和 'metric_type'
# n=1 表示只分割一次,expand=True 将结果扩展为新的DataFrame列
tmp[['side', 'metric_type']] = tmp['original_col_name'].str.split('_', n=1, expand=True)

# 步骤3: 使用 pivot 函数将 'metric_type' 重新作为列,'value' 作为值
# index 指定新的行索引,columns 指定新的列名,values 指定新的值
out_melt_pivot = (tmp.pivot(index=['date', 'other_col', 'side'],
                            columns='metric_type',
                            values='value')
                     .reset_index() # 将索引重置为列
                     .rename_axis(columns=None) # 移除列索引的名称
                 )

print("\n方法一 (melt + pivot) 结果:")
print(out_melt_pivot)
优点:
- 这是Pandas中处理宽到长格式转换的常用且直观的方法。
- 分步操作清晰,易于理解每一步的作用。
缺点:
- 需要多个步骤,代码可能稍显冗长。
方法二:基于 MultiIndex 的高级重塑
这种方法利用Pandas的MultiIndex功能在列级别创建分层索引,然后通过 stack 操作将部分索引级别转换为行数据。这是一种更为紧凑和强大的Pandas原生解决方案。
# 步骤1: 设置 'date' 和 'other_col' 为行索引
# 步骤2: 使用 pipe 函数链式操作,通过 str.split 创建列的MultiIndex
#         x.columns.str.split('_', expand=True) 会将 'right_count' 分割为 ('right', 'count')
# 步骤3: 重命名列索引的级别,使其更具可读性
# 步骤4: 对 'side' 级别进行 stack 操作,将其从列转换为行
# 步骤5: 重置索引,将所有索引级别转换为常规列
out_multiindex = (df
   .set_index(['date', 'other_col'])
   .pipe(lambda x: x.set_axis(x.columns.str.split('_', expand=True), axis=1))
   .rename_axis(columns=['side', None]) # 'None' 表示第二个级别没有名称
   .stack('side') # 对 'side' 级别进行堆叠
   .reset_index()
)

print("\n方法二 (MultiIndex) 结果:")
print(out_multiindex)
优点:
- 纯Pandas操作,无需引入外部库。
- 对于复杂的重塑任务,MultiIndex提供了强大的灵活性。
缺点:
- 概念相对复杂,对于初学者可能不易理解。
- 代码的可读性不如 melt + pivot 或 pyjanitor 直观。
方法三:借助 pyjanitor 库简化操作
pyjanitor 是一个为Pandas提供额外数据清理和转换功能的库,其中的 pivot_longer 函数专门用于简化从宽格式到长格式的转换,其灵感来源于R语言的 tidyr::pivot_longer。
首先,如果尚未安装 pyjanitor,请通过pip安装:
pip install pyjanitor
然后,可以使用以下代码进行重塑:
import janitor # 导入 janitor 库

# 使用 pivot_longer 函数
# index: 指定不变的标识列
# names_to: 指定新的列名元组,其中 '.value' 是一个特殊占位符,表示将原始列名的剩余部分作为新列名
# names_pattern: 使用正则表达式来匹配原始列名并捕获要提取的部分
out_janitor = df.pivot_longer(
    index=['date', 'other_col'],
    names_to=('side', '.value'), # 'side' 是第一个捕获组,'.value' 是第二个捕获组
    names_pattern=r'([^_]+)_([^_]+)' # 匹配 'xxx_yyy' 模式,捕获 'xxx' 和 'yyy'
)

print("\n方法三 (pyjanitor.pivot_longer) 结果:")
print(out_janitor)
优点:
- 代码极其简洁和直观,尤其是在列名有规律时。
- names_to 和 names_pattern 参数提供了强大的模式匹配能力。
- 易于理解和维护。
缺点:
- 需要安装额外的第三方库 pyjanitor。
注意事项与总结
- 选择方法:
- 对于简单的宽到长格式转换,melt 和 pivot 组合是一个稳健的选择,因为它纯粹基于Pandas且易于理解。
- 如果数据重塑逻辑复杂,或者希望追求更紧凑的Pandas原生代码,可以尝试MultiIndex方法,但需要对Pandas的索引操作有较深入的理解。
- 对于追求代码简洁性和高可读性,并且不介意引入第三方库的用户,pyjanitor.pivot_longer 是一个极佳的选择,尤其适用于列名具有明确模式的情况。
- 正则表达式: 在使用 str.split 或 names_pattern 时,理解和正确使用正则表达式至关重要,它决定了如何从原始列名中提取新的分类信息。
- 数据类型: 重塑操作后,新生成的列(如 count 和 sum)的数据类型可能会变为 object。在进行数值计算前,请确保将其转换为适当的数值类型(例如 int 或 float)。
- 长格式数据的好处: 将数据转换为长格式通常更适合数据分析、统计建模和使用seaborn、matplotlib等库进行可视化,因为它遵循“整洁数据”(Tidy Data)原则,即每列是一个变量,每行是一个观察值。
掌握这些数据重塑技巧,将使您在处理Pandas DataFrame时更加高效和灵活,从而更好地准备数据以进行深入分析。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。
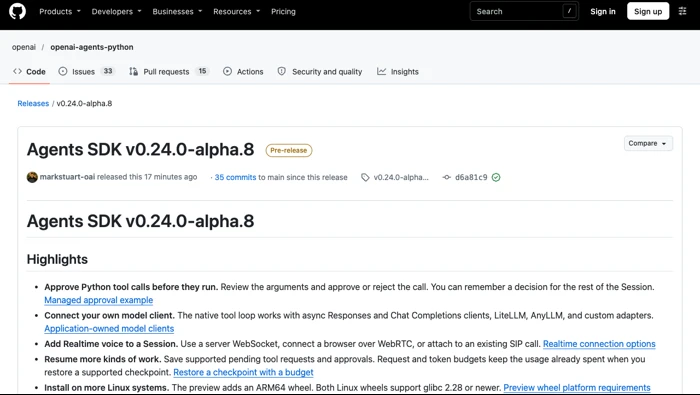
OpenAI Agents SDK v0.24.0-alpha.8预览版新增执行前审批、自有模型客户端、Realtime与预算检查点恢复,说明alpha.7回退、Linux运行及工具认证边界。
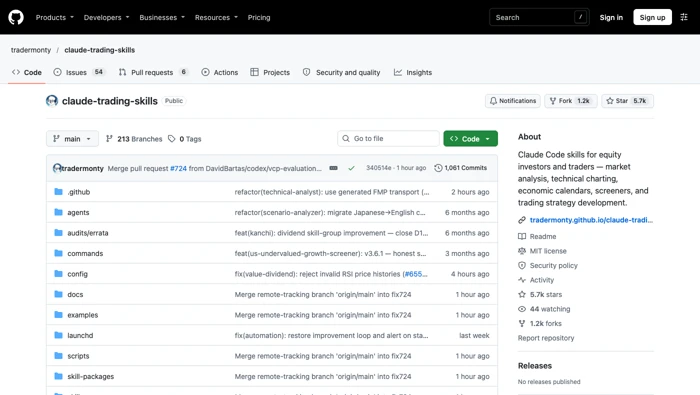
Claude Trading Skills六项技能已修复API密钥异常日志泄漏路径;not_verified保留完整安全审核缺口,离线回归通过不等于实盘验收或全面认证。
解释Microsoft C++ Language Server预览版的MSBuild编译数据库自动提取,区分CMake、自定义构建、有效Copilot订阅和CLI能力,避免把测试预发布版本当最低稳定版。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



