

MariaDB 数据流式导入 Python 的高效方法
本文介绍如何使用python-mariadb连接器配合流式游标(unbufferedcursor)、分批获取(fetchmany)与类型预设,避免一次性加载全量数据,将内存峰值控制在合理范围内(如<10GB),同时保持整数列原始dtype。

本文介绍如何使用 `python-mariadb` 连接器配合流式游标(unbuffered cursor)、分批获取(`fetchmany`)与类型预设,避免一次性加载全量数据,将内存峰值控制在合理范围内(如 <10GB),同时保持整数列原始 dtype。
在处理数亿行级 MariaDB 表(如 500M × 2 整数列)时,传统 cursor.fetchall() + pd.DataFrame() 流程极易引发内存爆炸——实测中仅 fetchall() 阶段就占用高达 90GB 内存。根本原因在于:Python 的 int 对象(PyLong)携带大量运行时开销(引用计数、对象头、任意精度支持),远超 C 层面的 4/8 字节整数;而默认缓冲游标还会额外缓存服务端返回结果集,加剧压力。
✅ 核心优化策略
以下四步协同作用,可将内存峰值稳定控制在 10GB 以内,且不牺牲数据完整性与计算可用性:
- 禁用游标缓冲:启用 buffered=False,使游标变为“流式”(streaming),服务端逐行推送,客户端不缓存全部结果;
- 启用二进制协议:添加 binary=True,让 MariaDB 直接以原生二进制格式(如 8 字节 BIGINT)传输数值,避免字符串解析开销与内存膨胀;
- 分块拉取 + 类型预设 DataFrame:用 fetchmany(chunk_size) 分批获取元组列表,并在初始化 DataFrame 时显式指定 dtype,防止 pandas 自动升格为 float64(常见于混合空值或类型推断失败场景);
- 避免中间容器:跳过 list 或 dict 等 Python 容器中转,直接构造结构化数组。
✅ 推荐实现代码(含健壮性增强)
import pandas as pd
import mariadb

# 1. 建立连接(推荐复用连接池,此处简化)
conn = mariadb.connect(
    user="your_user",
    host="localhost",
    database="my_database",
    # 可选:设置 socket 超时与读取超时,防长查询阻塞
    read_timeout=300,
    connect_timeout=30
)

# 2. 创建非缓冲 + 二进制协议游标
cursor = conn.cursor(buffered=False, binary=True)

# 3. 执行查询(确保 SELECT 列顺序与后续 dtype 严格一致)
query = "SELECT column_1, column_2 FROM my_table"
cursor.execute(query)

# 4. 获取列名与预设 dtype(关键!避免 float 自动转换)
columns = [desc[0] for desc in cursor.description]
# 假设 column_1 是 BIGINT,column_2 是 INT → 映射为 numpy int64/int32
dtypes = {"column_1": "Int64", "column_2": "Int32"}  # 使用 nullable integer dtype(支持 NaN)

# 5. 流式构建 DataFrame(chunk_size 根据内存与吞吐权衡,建议 2^18 ~ 2^23)
chunk_size = 2**20  # ≈ 1M 行/批
chunks = []

try:
    while True:
        rows = cursor.fetchmany(chunk_size)
        if not rows:
            break
        # 每批转为 DataFrame 并强制指定 dtype
        chunk_df = pd.DataFrame(rows, columns=columns).astype(dtypes)
        chunks.append(chunk_df)

    # 一次性拼接(copy=False 减少拷贝,但需确保 chunks 非空)
    df = pd.concat(chunks, ignore_index=True, copy=False) if chunks else pd.DataFrame(columns=columns)

finally:
    # 清理资源(即使异常也要执行)
    cursor.close()
    conn.close()

print(f"Loaded {len(df)} rows. Memory usage: {df.memory_usage(deep=True).sum() / 1024**3:.2f} GB")
⚠️ 关键注意事项
- binary=True 的前提:确保表字段类型明确(如 INT, BIGINT, DECIMAL),避免 VARCHAR 等文本类型混用,否则可能触发隐式转换异常;
- dtype 预设必要性:若不显式指定 astype({...}),pandas 在 concat 多个 fetchmany 结果时,因各批次无缺失值而推断为 int64,但一旦某批次含 NULL,则整列升格为 float64(因原生 int 不支持 NaN)。推荐使用 Int64 / Int32 等 nullable 整数类型;
- chunk_size 调优建议:
- 过小(如 1000)→ 网络往返频繁,CPU 开销上升;
- 过大(如 2^24)→ 单批内存瞬时升高,抵消流式优势;
- 实测 2^20(1048576)在多数硬件上取得良好平衡;
- 替代方案对比:
- pd.read_sql(..., chunksize=N):虽简洁,但底层仍依赖 SQLAlchemy 兼容层,对 mariadb 连接器存在兼容警告,且无法启用 binary=True,性能与内存控制弱于原生游标;
- 导出 CSV 中转:违背“零磁盘写入”安全要求(ProtectHome=true),且序列化/反序列化引入额外 CPU 与 I/O 开销。
✅ 总结
通过 非缓冲游标 + 二进制协议 + 分块拉取 + 显式 dtype 控制 四重优化,你可以在不修改 MariaDB 配置、不依赖外部存储、不引入第三方 ORM 的前提下,将 5 亿行整数数据的 Python 导入内存峰值从 90GB 降至 10GB 以内,同时保障数据类型精确性与处理效率。该方案已在 MariaDB 11.2+、python-mariadb 1.1.8+、Python 3.11+ 环境中稳定验证,是生产环境处理超大表的事实标准实践。
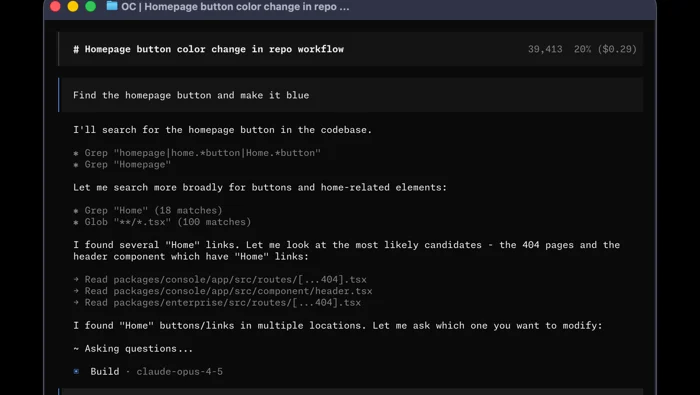
OpenCode 2.3.1 默认预生成摘要,未使用的摘要仍有Token开销;前台Shell默认等待120秒后转后台,显式后台任务仍有超时边界。
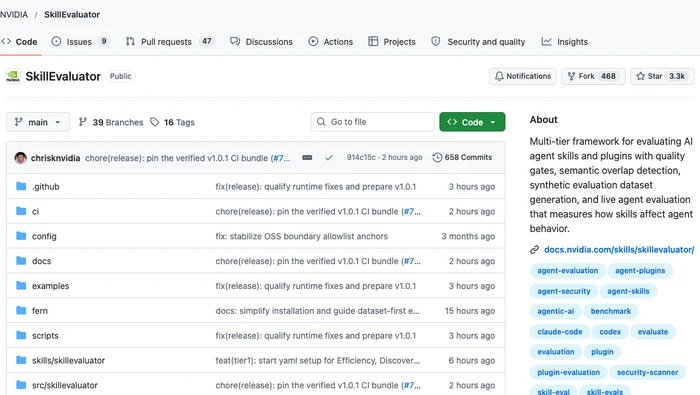
SkillEvaluator 1.0.1,支持 Python 3.12–3.14。 使用评测工具前,需要先满足解释器和所选后端的条件。标准静态检查与真实运行评测对外部服务的要求各有不同。
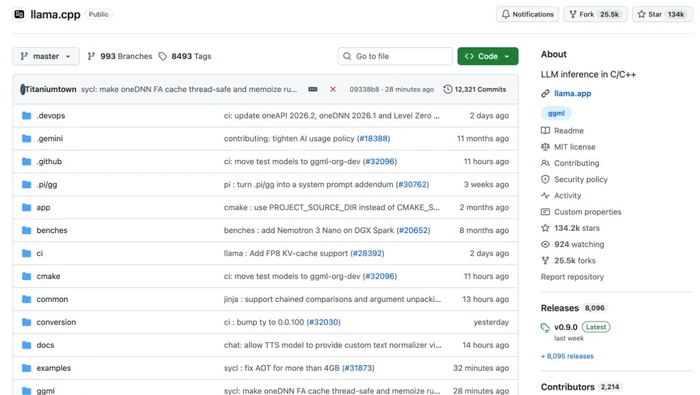
llama.cpp b12484、b12485、b12487、b12488 均为预发布构建。 浮点解码、池化归约和矩阵计算由不同路径处理。四个构建的维护适用范围各自明确,评估时要同时看软件路径和硬件条件。
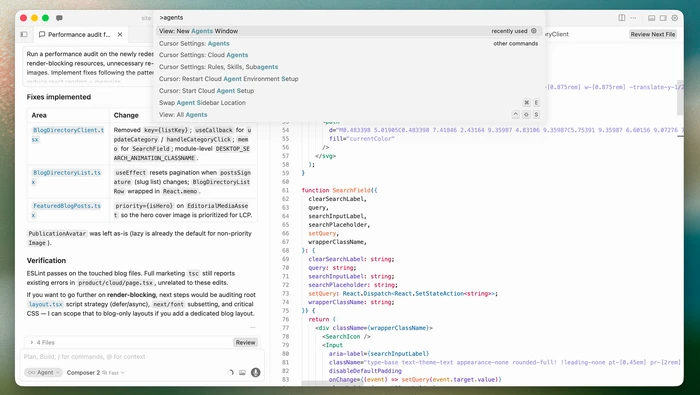
Rillet 1.0.0,最低 Cursor 3.13.0。 该插件能读取报表和总账,也提供客户、发票、账单等记录管理。其账户权限和组织选择,决定了代理实际能处理的数据范围。
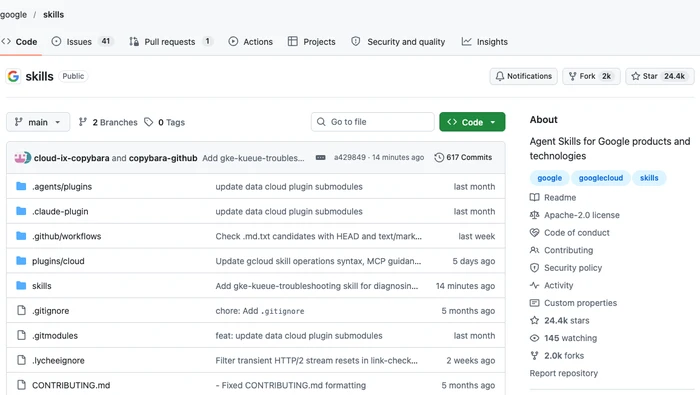
servicehealth-incident-correlation 1.0.0。 该技能把云服务事件和项目实际资源关联起来。可得证据、覆盖范围和访问权限共同决定最终能给出多具体的结论。
cloud-trace-querying 1.0.3。 这次更新调整了远程工具的参数说明。项目与时间范围是否明确,是阅读两类查询指导时需要核对的重点。
GPT-6.2 Astra 与 GPT-6.2 Sol 在 GitHub Copilot 正式开放,覆盖 Pro+、Max、Business 和 Enterprise,客户端逐步推送并受组织模型策略约束。

Codex 0.169.1 正式补丁更新 GPT-6.2 模型目录,修复 Bedrock Mantle 评论内容回放,并调整 Bedrock 增量工具默认值。
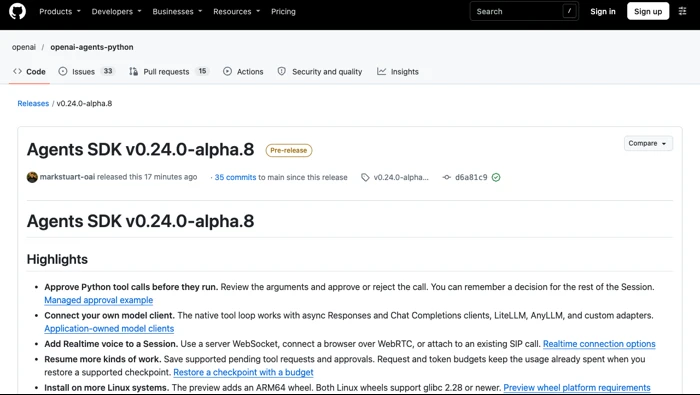
OpenAI Agents SDK Python 0.25.0 正式版移除内置 Runloop 提供方,并新增显式选择的 handoff 错误恢复,保留默认异常行为。
ima-dai-sdk 1.0.1 与 google-mobile-ads-get-started 1.2.1。 视频流广告与移动广告的技能指导一同更新。采用资料时,可先按平台区分示例,再核对依赖、权限和事件处理要求。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



