

Nitrado服务器日志下载404解决方法
本文旨在解决使用Python和NitradoAPI自动下载服务器日志时遇到的404错误。核心问题在于API端点使用不当和认证方式的潜在误区。我们将详细介绍Nitrado文件服务器API的正确用法,包括如何列出和下载日志文件,并提供一个基于API令牌认证的优化Python脚本,确保日志下载功能稳定可靠。
 服务器日志自动下载404错误:API端点与认证指南
" />
本文旨在解决使用Python和Nitrado API自动下载服务器日志时遇到的404错误。核心问题在于API端点使用不当和认证方式的潜在误区。我们将详细介绍Nitrado文件服务器API的正确用法,包括如何列出和下载日志文件,并提供一个基于API令牌认证的优化Python脚本,确保日志下载功能稳定可靠。
理解Nitrado API与404错误根源
在使用API进行数据交互时,404错误(Not Found)通常意味着请求的资源在服务器上不存在,或者请求的URL路径不正确。对于Nitrado服务器日志的自动下载场景,原始代码中出现的404错误,其主要原因在于对Nitrado文件服务器API端点的误用。
Nitrado API设计了专门的端点来处理文件列表和下载操作,而不是简单地通过拼接路径来访问文件。具体来说,它提供了:
- GET /services/:id/gameservers/file_server/list: 用于列出指定路径下的文件和文件夹。
- GET /services/:id/gameservers/file_server/download: 用于下载指定路径的文件。
原始代码尝试通过 f"{base_url}/games/dayz/log" 直接获取日志列表,并随后通过拼接路径下载文件,这与Nitrado API的预期行为不符,从而导致了404错误。
此外,Nitrado API通常推荐使用API令牌(API Token)进行认证,而非传统的用户名和密码。使用API令牌作为Bearer Token在HTTP请求头中发送,是更安全和标准的认证方式。
正确实现Nitrado服务器日志下载
为了正确实现Nitrado服务器日志的自动下载功能,我们需要遵循以下步骤:
- 获取API令牌: 访问您的Nitrado账户设置,生成并获取一个API令牌。
- 构建请求头: 使用API令牌构建HTTP请求的Authorization头。
- 列出日志文件: 调用 /list 端点,并传入 path 参数指定日志文件所在的目录。
- 解析文件列表: 从 /list 端点的响应中提取出每个日志文件的完整路径。
- 下载日志文件: 遍历文件列表,对每个文件调用 /download 端点,并传入 path 参数指定要下载的文件路径。
示例代码:优化后的Python日志下载器
以下是一个经过优化和修正的Python脚本,它演示了如何正确使用Nitrado API来下载服务器日志:
import requests
import os

def download_nitrado_logs(server_id: str, api_token: str, log_directory: str = "/games/dayz/log", local_save_dir: str = "nitrado_logs"):
    """
    自动下载Nitrado游戏服务器的日志文件。

    Args:
        server_id (str): 您的Nitrado服务器ID。
        api_token (str): 您的Nitrado API令牌。
        log_directory (str): 服务器上日志文件所在的路径,例如 "/games/dayz/log"。
        local_save_dir (str): 本地保存下载日志的目录。
    """
    base_url = f"https://api.nitrado.net/services/{server_id}/gameservers/file_server"
    headers = {
        "Authorization": f"Bearer {api_token}",
        "Accept": "application/json" # 明确请求JSON响应
    }

    # 确保本地保存目录存在
    os.makedirs(local_save_dir, exist_ok=True)
    print(f"日志将保存到本地目录: {os.path.abspath(local_save_dir)}")

    # 1. 获取日志文件列表
    print(f"正在尝试从 '{log_directory}' 获取日志文件列表...")
    list_logs_url = f"{base_url}/list?path={log_directory}"

    try:
        response = requests.get(list_logs_url, headers=headers)
        response.raise_for_status() # 对非200状态码抛出HTTPError

        data = response.json()
        log_files_info = data.get('files', [])

        if not log_files_info:
            print(f"在路径 '{log_directory}' 中未找到任何日志文件或目录。")
            return

        # 过滤出文件,并提取完整路径和本地文件名
        files_to_download = []
        for f_info in log_files_info:
            if f_info.get('type') == 'file':
                full_server_path = f_info['path']
                local_filename = os.path.basename(full_server_path)
                files_to_download.append((full_server_path, local_filename))

        if not files_to_download:
            print(f"在路径 '{log_directory}' 中未找到任何可下载的日志文件。")
            return

        print(f"找到 {len(files_to_download)} 个日志文件。")
        print("可用日志文件:", ", ".join([name for _, name in files_to_download]))

        # 2. 下载每个日志文件
        for full_server_path, local_filename in files_to_download:
            download_log_url = f"{base_url}/download?path={full_server_path}"
            local_filepath = os.path.join(local_save_dir, local_filename)

            print(f"正在下载: {local_filename}...")
            download_response = requests.get(download_log_url, headers=headers, stream=True) # 使用stream模式处理大文件
            download_response.raise_for_status() # 对非200状态码抛出HTTPError

            with open(local_filepath, 'wb') as f:
                for chunk in download_response.iter_content(chunk_size=8192):
                    f.write(chunk)
            print(f"已成功下载并保存: {local_filepath}")

    except requests.exceptions.HTTPError as http_err:
        print(f"HTTP错误发生: {http_err} - 响应内容: {http_err.response.text}")
    except requests.exceptions.ConnectionError as conn_err:
        print(f"连接错误发生: {conn_err}")
    except requests.exceptions.Timeout as timeout_err:
        print(f"请求超时: {timeout_err}")
    except requests.exceptions.RequestException as req_err:
        print(f"请求发生未知错误: {req_err}")
    except ValueError as json_err: # requests.json()在非JSON响应时会抛出
        print(f"JSON解析错误: {json_err} - 原始响应: {response.text}")
    except Exception as e:
        print(f"发生意外错误: {e}")

# --- 配置您的Nitrado服务器信息 ---
YOUR_SERVER_ID = "请在此处填写您的Nitrado服务器ID" # 例如: "1234567"
YOUR_NITRADO_API_TOKEN = "请在此处填写您的Nitrado API令牌" # 例如: "YOUR_LONG_API_TOKEN_STRING"

# 调用函数下载日志
if __name__ == "__main__":
    if YOUR_SERVER_ID == "请在此处填写您的Nitrado服务器ID" or \
       YOUR_NITRADO_API_TOKEN == "请在此处填写您的Nitrado API令牌":
        print("错误: 请先配置您的Nitrado服务器ID和API令牌。")
    else:
        # 可以根据您的游戏和服务器配置调整日志目录
        download_nitrado_logs(YOUR_SERVER_ID, YOUR_NITRADO_API_TOKEN, log_directory="/games/dayz/log")
        # 如果是其他游戏,例如Minecraft,日志路径可能不同
        # download_nitrado_logs(YOUR_SERVER_ID, YOUR_NITRADO_API_TOKEN, log_directory="/games/minecraft/logs")
代码解析
- 导入必要的库: requests 用于HTTP请求,os 用于处理文件路径和创建目录。
- download_nitrado_logs 函数: 封装了日志下载的全部逻辑。
- server_id 和 api_token: 作为函数参数传入,提高灵活性和安全性。
- log_directory: 默认设置为 /games/dayz/log,这是DayZ服务器的常见日志路径,您可以根据实际游戏和服务器配置进行修改。
- local_save_dir: 指定日志文件在本地保存的目录。
- base_url: 构建Nitrado API的基础URL。
- headers: 关键部分!在这里,我们将API令牌作为 Bearer 令牌添加到 Authorization 请求头中。同时,添加 Accept: application/json 明确请求JSON响应。
- 创建本地保存目录: 使用 os.makedirs(local_save_dir, exist_ok=True) 确保目标目录存在。
- 列出日志文件:
- 构建 list_logs_url,其中包含 path 查询参数,指向服务器上的日志目录。
- 发送GET请求,并使用 response.raise_for_status() 检查HTTP状态码。
- 解析JSON响应,从中提取 files 列表。每个文件对象包含 path 和 type 等信息。
- 通过 f_info.get('type') == 'file' 过滤出真正的文件,并提取其完整路径和本地文件名。
- 下载日志文件:
- 遍历 files_to_download 列表。
- 构建 download_log_url,同样包含 path 查询参数,指向要下载的具体文件。
- 发送GET请求,并使用 stream=True 参数。这对于下载大文件非常重要,因为它允许逐步读取响应内容,而不是一次性加载到内存中。
- 使用 download_response.iter_content(chunk_size=8192) 迭代下载内容块,并将其写入本地文件。
- 错误处理: 脚本包含了对各种 requests 异常的捕获,如 HTTPError (针对非200状态码)、ConnectionError、Timeout 等,以提高程序的健壮性。
注意事项与最佳实践
- API令牌安全: 您的API令牌是访问Nitrado账户的关键凭证。请务必妥善保管,不要将其硬编码到公开的代码库中。建议使用环境变量、配置文件或秘密管理工具来存储和加载API令牌。
- 日志目录路径: 不同的游戏或服务器配置,其日志文件的存放路径可能不同。请务必查阅您的Nitrado服务器面板或相关游戏文档,确认正确的日志目录路径。
- 错误处理与日志记录: 教程中的错误处理是基础性的。在生产环境中,您可能需要更详细的错误日志记录机制(例如使用Python的 logging 模块),以便在无人值守的情况下追踪问题。
- API速率限制: 大多数API都有请求速率限制。频繁或大量请求可能会导致API暂时拒绝服务。在设计自动下载脚本时,考虑添加适当的延迟(例如 time.sleep())或重试机制。
- 文件覆盖: 当前脚本会直接将下载的文件保存到 local_save_dir。如果同名文件已存在,它将被覆盖。如果需要保留历史版本,您可能需要修改文件名(例如添加时间戳)。
- API文档查阅: Nitrado API可能会更新。建议定期查阅官方API文档 (https://doc.nitrado.net/),以获取最新的端点、参数和认证信息。特别是 GameserverFilesBookmarks 部分,它详细描述了文件服务器API的使用。
总结
通过理解Nitrado API的正确端点结构和认证机制,我们可以有效解决自动下载日志时遇到的404错误。本教程提供的优化Python脚本,不仅修正了URL路径和认证方式,还包含了健壮的错误处理和文件下载逻辑,为您构建可靠的Nitrado服务器日志自动下载工具提供了坚实的基础。遵循最佳实践,确保API令牌安全,并根据实际需求调整日志路径,将使您的自动化任务更加顺畅高效。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。
区分Windows Terminal 1.25.3131.0 GA与1.26.3133.0 Preview,解释enableTabDragDrop和showResizeOverlay配置、清屏及键盘修复,并保留鼠标报告点击URL问题未确认修复的更正。
给出LiteLLM1.109.0五项迁移配置,说明fallback列表、local缓存、router_settings硬限流、Gemini参数和Lens独立部署,并区分LTS/旧补丁/RC。
agent-desktop 1.3.1让已经启动的沙箱在启动器退出后继续运行,并更新rustix至1.1.6。对通过JSON快照操作桌面的用户而言,沙箱存活、平台权限与ref有效性需要分别判断,不能用其中一项正常代替整项任务的验收。
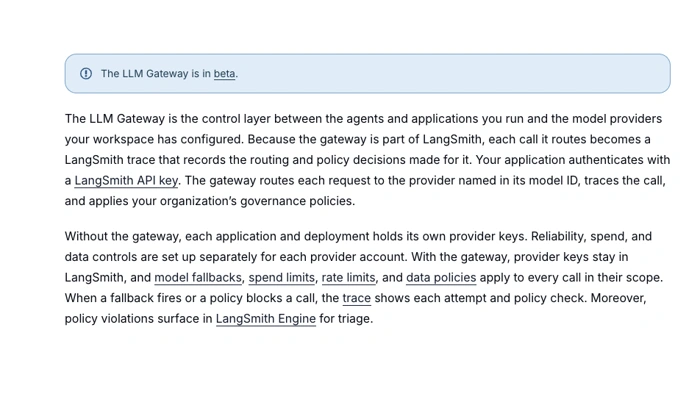
langchain-core 1.8.1新增的langsmith_gateway用于上下文级LangSmith Gateway覆盖。它并非一次模型调用的临时请求参数:路由在模型构造时解析,因而生效位置、集成支持和配置优先级都需要一起理解。
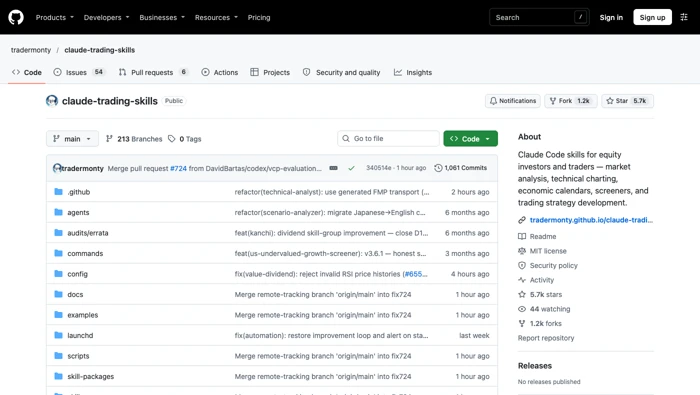
Claude Trading Skills分别记录覆盖完整性、数据来源和规则确认;维护者自动扫描标记的not_verified不能等同完整安全验证或已发生密钥泄露,相关Skill代码未在该审查提交中修改。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



