

args和**kwargs在Python中是什么意思?
args将任意数量的位置参数收集为元组,*kwargs将任意数量的关键字参数收集为字典,二者结合可提升函数灵活性和扩展性。
args将任意数量的位置参数收集为元组,*kwargs将任意数量的关键字参数收集为字典,二者结合可提升函数灵活性和扩展性。
在Python里,*args和**kwargs这两个语法糖,说白了,就是让你能写出更灵活的函数,让它们可以接收任意数量的位置参数和关键字参数。它们不是什么魔法,只是Python提供的一种约定,方便我们处理那些参数数量不确定的场景。简单来说,*args会把所有额外的、没有被明确定义的位置参数收集到一个元组(tuple)里;而**kwargs则会把所有额外的、没有被明确定义的关键字参数收集到一个字典(dictionary)里。这俩玩意儿,在我看来,简直是Python函数设计中的“瑞士军刀”,让代码的扩展性和鲁棒性一下子就上去了。
解决方案
当我们在Python中定义一个函数时,如果事先不确定调用者会传入多少个参数,或者传入哪些关键字参数,*args和**kwargs就派上大用场了。它们允许函数签名变得非常通用。
具体来说,*args(你可以叫它“星号参数”)允许函数接收任意数量的位置参数。这些参数在函数内部会被打包成一个元组。比如,你可能想写一个函数来计算任意多个数字的和,或者拼接任意多段字符串。如果没有*args,你可能需要定义多个重载函数,或者传入一个列表,但那样就少了点Pythonic的优雅。
def my_sum(*numbers):
    # numbers 在这里是一个元组
    total = 0
    for num in numbers:
        total += num
    return total

print(my_sum(1, 2, 3))         # 输出 6
print(my_sum(10, 20, 30, 40))  # 输出 100
print(my_sum()) # 输出 0而**kwargs(你可以叫它“双星号关键字参数”)则更进一步,它允许函数接收任意数量的关键字参数。这些关键字参数在函数内部会被打包成一个字典,其中键是参数名,值是参数值。这在需要配置大量可选参数,或者构建类似HTML属性、HTTP请求头这种键值对结构的场景下,简直是神来之笔。
def print_config(**options):
    # options 在这里是一个字典
    print("配置详情:")
    for key, value in options.items():
        print(f"  {key}: {value}")

print_config(host="localhost", port=8080, debug=True)
# 输出:
# 配置详情:
#   host: localhost
#   port: 8080
#   debug: True

print_config(user="admin")
# 输出:
# 配置详情:
#   user: admin
这两者结合使用,就能创建一个极其通用的函数签名,能够处理几乎所有可能的参数组合。通常,我们会把它们放在函数参数列表的末尾,遵循的顺序是:普通位置参数 -> *args -> 普通关键字参数 -> **kwargs。
def comprehensive_function(a, b, *args, default_val=100, **kwargs):
    print(f"a: {a}")
    print(f"b: {b}")
    print(f"额外的位置参数 (args): {args}")
    print(f"默认值 (default_val): {default_val}")
    print(f"额外的关键字参数 (kwargs): {kwargs}")

comprehensive_function(1, 2, 3, 4, name="Alice", age=30, default_val=200)
# 输出:
# a: 1
# b: 2
# 额外的位置参数 (args): (3, 4)
# 默认值 (default_val): 200
# 额外的关键字参数 (kwargs): {'name': 'Alice', 'age': 30}
看到没,这种灵活性是无与伦比的。它让我的代码在面对需求变化时,能有更大的余地去适应,而不是动不动就改函数签名。
在Python函数定义中,*args是如何处理可变位置参数的?
*args在Python函数定义中扮演的角色,就是个“收集者”。它专门负责收集那些在函数签名中没有明确指定名称,但又作为位置参数传入函数的所有值。一旦收集完毕,这些值就会被整齐地打包成一个元组(tuple)。这个元组在函数体内部可以像任何其他元组一样被访问和操作。
想象一下,你有一个函数,它的核心任务是处理一系列同类型的数据,但你不知道这次会有多少个数据。比如,计算平均值,或者把多个文件路径合并。如果没有*args,你可能得让用户把所有数据先放到一个列表里再传进来,或者写一堆重载函数,这无疑增加了使用者的负担和代码的复杂性。有了*args,函数签名变得简洁明了,用户直接把数据一个个传进来就行。
举个例子,我经常需要写一些日志记录的辅助函数,可能会有不同的消息段:
import datetime

def log_message(level, *parts):
    """记录一条带有不同部分的日志消息"""
    timestamp = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")
    # parts 是一个元组,包含了 'Hello', 'World', '!'
    full_message = " ".join(str(p) for p in parts)
    print(f"[{timestamp}] [{level.upper()}]: {full_message}")

log_message("INFO", "应用程序启动", "版本", 1.0)
# 输出: [2023-10-27 10:30:00] [INFO]: 应用程序启动 版本 1.0

log_message("WARNING", "配置项缺失")
# 输出: [2023-10-27 10:30:00] [WARNING]: 配置项缺失这里*parts就非常巧妙地收集了“应用程序启动”、“版本”、1.0这些不同的消息片段,然后我可以在函数内部将它们拼接起来。
需要注意的是,*args在参数列表中的位置是有讲究的。它必须出现在所有普通的位置参数之后,但在任何关键字参数(包括带有默认值的参数和**kwargs)之前。这是Python解析参数的固定顺序,不然Python就不知道哪些参数是给谁的了。
def mixed_params(fixed_arg, *dynamic_args, key_arg="default"):
    print(f"Fixed: {fixed_arg}")
    print(f"Dynamic: {dynamic_args}")
    print(f"Key: {key_arg}")

mixed_params(1, 2, 3, 4, key_arg="custom")
# Fixed: 1
# Dynamic: (2, 3, 4)
# Key: custom如果我尝试把*dynamic_args放在fixed_arg前面,或者放在key_arg后面,Python就会报错。这种明确的顺序避免了歧义,虽然有时候初学者会觉得有点绕,但理解了背后的解析机制,就觉得挺合理的。
一个常见的误区是,当你想把*args收集到的元组再次作为独立的参数传递给另一个函数时,你需要用*进行解包。比如,another_function(*args)而不是another_function(args)。后者会把整个元组当作一个参数传过去,这通常不是我们想要的。这种解包的机制,其实也是Python灵活性的一种体现,让数据在不同函数间传递时能保持其原始的“独立”形态。
**kwargs在Python中如何实现灵活的关键字参数传递?
**kwargs在Python中,是处理那些“不确定”的命名参数的利器。它会把所有在函数调用时作为关键字参数传入,但又没有在函数定义中被明确命名的参数,全部收集到一个字典(dictionary)里。这个字典的键就是参数名(字符串),值就是对应的参数值。这种机制为函数提供了极大的配置灵活性,尤其是在处理配置、属性或选项时。
我个人在开发Web应用或API客户端时,就特别依赖**kwargs。比如,一个HTTP请求函数可能需要支持各种各样的HTTP头、查询参数或请求体字段,这些东西往往是动态变化的。如果我为每个可能的参数都定义一个形参,那函数签名会变得非常臃肿,而且难以维护。**kwargs完美解决了这个问题。
import requests

def make_api_call(url, method="GET", **request_options):
    """
    模拟一个灵活的API调用函数
    request_options 可以包含 headers, params, json, timeout 等
    """
    print(f"正在向 {url} 发送 {method} 请求...")
    print(f"请求选项: {request_options}")

    # 实际项目中,这里会调用 requests.request(method, url, **request_options)
    # 模拟返回一个响应对象
    class MockResponse:
        def __init__(self, status_code, text):
            self.status_code = status_code
            self.text = text
        def json(self):
            import json
            return json.loads(self.text)

    if url.endswith("/success"):
        return MockResponse(200, '{"status": "success", "data": {"id": 123}}')
    else:
        return MockResponse(404, '{"error": "Not Found"}')


# 调用示例
response = make_api_call("https://api.example.com/data/success",
                         method="POST",
                         headers={"Authorization": "Bearer token123"},
                         json={"query": "test"},
                         timeout=5)
print(f"响应状态码: {response.status_code}")
print(f"响应内容: {response.json()}")

# 另一个调用
response = make_api_call("https://api.example.com/users", params={"page": 1, "limit": 10})
print(f"响应状态码: {response.status_code}")在这个make_api_call函数中,request_options就收集了headers, json, timeout这些关键字参数。函数内部可以直接把这个字典解包(**request_options)传递给requests.request,省去了手动处理每个参数的麻烦。
和*args类似,**kwargs在参数列表中的位置也有规定,它必须是最后一个参数。这是因为Python需要先解析所有明确定义的位置参数、*args收集的参数,以及所有明确定义的关键字参数,最后剩下的那些关键字参数才会被**kwargs收入囊中。
一个很重要的点是,如果传入的关键字参数名与函数中已有的命名参数(无论是普通参数还是带有默认值的参数)冲突,那么该参数值会被对应的命名参数接收,而不会进入**kwargs。
def process_data(name, age=30, **extra_info):
    print(f"Name: {name}")
    print(f"Age: {age}")
    print(f"Extra Info: {extra_info}")

process_data("Bob", age=25, city="New York", occupation="Engineer")
# Name: Bob
# Age: 25 (这里的 age=25 覆盖了默认值 30)
# Extra Info: {'city': 'New York', 'occupation': 'Engineer'}

process_data("Charlie", city="London")
# Name: Charlie
# Age: 30 (使用了默认值)
# Extra Info: {'city': 'London'}可以看到,age=25被age参数本身接收了,并没有跑到extra_info字典里。这种行为是符合预期的,它确保了函数签名中的明确参数总是优先被处理。理解这一点,对于避免一些参数传递上的小坑非常关键。
*args和**kwargs在实际项目中有哪些高级应用场景?
*args和**kwargs绝不仅仅是用来写几个简单函数那么简单,它们在Python的生态系统和高级编程模式中扮演着核心角色。我发现,它们是实现代码复用、增强灵活性、甚至构建框架级功能不可或缺的工具。
1. 函数装饰器 (Decorators):
这是它们最经典、也是最有力的应用之一。装饰器本质上是一个函数,它接收另一个函数作为参数,并返回一个新的函数。为了让装饰器能够作用于任何签名的函数(无论它接受多少位置参数或关键字参数),*args和**kwargs是必不可少的。
import time

def timer(func):
    """一个简单的计时装饰器"""
    def wrapper(*args, **kwargs):
        start_time = time.time()
        result = func(*args, **kwargs) # 使用 *args 和 **kwargs 转发所有参数
        end_time = time.time()
        print(f"函数 {func.__name__} 执行耗时: {end_time - start_time:.4f} 秒")
        return result
    return wrapper

@timer
def long_running_task(iterations, message):
    for _ in range(iterations):
        _ = 1 + 1 # 模拟计算
    print(f"任务完成: {message}")
    return "Done"

@timer
def short_task():
    print("短任务完成")
    return "Short Done"

long_running_task(1_000_000, "大量计算")
short_task()在这个timer装饰器里,wrapper函数通过*args和**kwargs接收被装饰函数的所有参数,然后原封不动地传递给func。这样,timer就可以装饰任何参数签名的函数,而不需要关心具体有多少参数或参数名是什么。这简直是魔法,让代码的横向扩展能力大大增强。
2. 函数转发/代理 (Function Forwarding/Proxying):
当一个函数的主要职责是调用另一个函数,并把自己的参数全部传递过去时,*args和**kwargs就能实现优雅的转发。这在构建API客户端、日志包装器或任何需要透明地传递参数的场景中非常有用。
class APIClient:
    def __init__(self, base_url):
        self.base_url = base_url

    def _send_request(self, method, path, **kwargs):
        """内部方法,处理实际的HTTP请求"""
        url = f"{self.base_url}{path}"
        print(f"Sending {method} request to {url} with options: {kwargs}")
        # 实际会用 requests.request(method, url, **kwargs)
        return {"status": "success", "data": "mock_data"}

    def get(self, path, **kwargs):
        """GET请求的封装,转发所有参数"""
        return self._send_request("GET", path, **kwargs)

    def post(self, path, data, **kwargs):
        """POST请求的封装,转发所有参数,同时添加 data 参数"""
        kwargs['json'] = data # 或者直接在 kwargs 里添加
        return self._send_request("POST", path, **kwargs)

client = APIClient("https://myapi.com")
client.get("/users", params={"id": 123}, headers={"Auth": "token"})
client.post("/items", data={"name": "New Item"}, timeout=10)这里的get和post方法,通过**kwargs将所有额外的关键字参数直接转发给_send_request,避免了重复编写参数传递逻辑。这种模式让API客户端非常灵活,可以轻松支持底层库(如requests)的各种参数。
3. 构建灵活的类初始化 (__init__) 或工厂函数:
当一个类或工厂函数需要接受大量可选配置时,**kwargs能让初始化方法变得非常简洁。
class DynamicConfig:
    def __init__(self, default_setting="foo", **custom_settings):
        self.settings = {"default_setting": default_setting}
        self.settings.update(custom_settings) # 合并自定义设置

    def get_setting(self, key):
        return self.settings.get(key, "Setting not found")

config1 = DynamicConfig()
print(config1.get_setting("default_setting")) # foo

config2 = DynamicConfig(default_setting="bar", database_url="sqlite:///db.db", cache_size=1024)
print(config2.get_setting("default_setting")) # bar
print(config2.get_setting("database_url")) # sqlite:///db.db这里__init__方法通过**custom_settings接收所有额外的配置项,然后将它们合并到self.settings中。这种模式非常适合那些需要高度可配置的组件。
4. 继承和方法重写:
在面向对象编程中,子类方法经常需要调用父类方法,并传递相同的参数。使用*args和**kwargs可以确保子类在调用super()时,能够无缝地传递所有参数,而不需要关心父类方法具体的签名。
class BaseProcessor:
    def process(self, *args, **kwargs):
        print(f"BaseProcessor processing with args: {args}, kwargs: {kwargs}")
        # 实际处理逻辑

class AdvancedProcessor(BaseProcessor):
    def process(self, *args, **kwargs):
        print("AdvancedProcessor doing some pre-processing...")
        # 添加子类特有的逻辑
        super().process(*args, **kwargs) # 转发所有参数给父类
        print("AdvancedProcessor doing some post-processing...")

processor = AdvancedProcessor()
processor.process(1, 2, name="test", debug=True)
这种模式保证了继承链上的参数传递的完整性和一致性。
总的来说,*args和**kwargs是Python提供给我们的强大工具,它们让函数和方法能够拥有高度的灵活性和适应性。理解并善用它们,能让我们的代码更健壮,更易于维护和扩展。它们是Python动态特性和“约定优于配置”理念的绝佳体现。
WorkBuddy 目前没有面向普通用户的公开 REST API 接口文档,扩展与集成走四条官方路径:接入 MCP 服务扩展工具能力、用连接器打通外部应用(支持公共/个人授权)、编写技能(Skill)与专家包定制工作流、在开放平台发布 Buddy 应用。另支持接入 OpenAI 兼容的自定义模型。本文含 4 张真实界面截图并如实说明现状。
解释Google Workspace MCP 11月11日与12日的agentic OAuth客户端迁移节点,区分普通REST应用、混合客户端、预览资格、用户权限和服务账户、Apps Script边界。
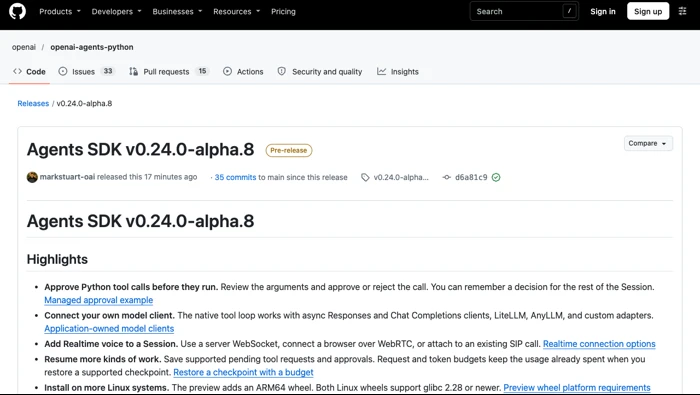
OpenAI Agents SDK v0.24.0-alpha.8预览版新增执行前审批、自有模型客户端、Realtime与预算检查点恢复,说明alpha.7回退、Linux运行及工具认证边界。
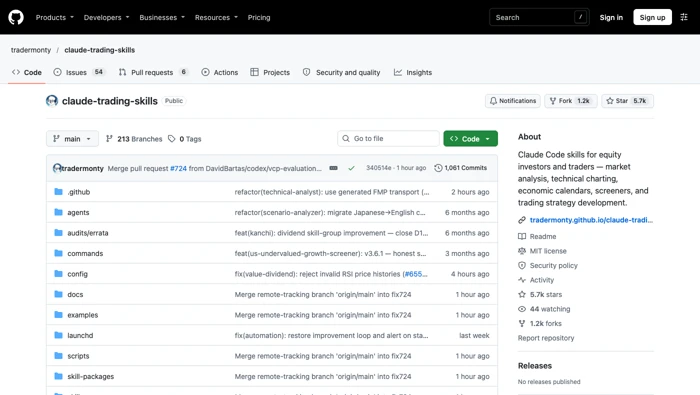
Claude Trading Skills六项技能已修复API密钥异常日志泄漏路径;not_verified保留完整安全审核缺口,离线回归通过不等于实盘验收或全面认证。
解释Microsoft C++ Language Server预览版的MSBuild编译数据库自动提取,区分CMake、自定义构建、有效Copilot订阅和CLI能力,避免把测试预发布版本当最低稳定版。

LibreOffice可通过“工具→宏”创建和运行Basic宏,也支持由Python脚本提供程序运行Python宏。两种方式都可以使用UNO接口操作文档;Excel VBA只有有限兼容支持,不能把所有Excel宏直接复制过来当作LibreOffice原生宏执行。
说明Enterprise GitHub Apps的Copilot席位管理权限,提供第一页只读GET示例,区分total_seats、授权明细、遥测活动和待取消计费条件。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



