

Java扫描网站资源路径方法详解
1.使用Java进行Web资源探测的核心在于构造HTTP请求并解析响应,通过HttpClient发送GET请求,分析状态码和响应内容判断资源是否存在。2.探测流程包括确定目标URL基址、生成潜在路径列表、构造并发送请求、分析响应结果。3.响应分析需关注状态码如200、301/302、403、404,并结合响应内容和响应头进一步判断资源状态。4.代码示例展示了如何使用Java11的HttpClient进行路径探测,并通过线程池实现并发控制。5.Web资源探测在安全审计、SEO优化、数据采集、网站迁移等方面具
1.使用Java进行Web资源探测的核心在于构造HTTP请求并解析响应,通过HttpClient发送GET请求,分析状态码和响应内容判断资源是否存在。2.探测流程包括确定目标URL基址、生成潜在路径列表、构造并发送请求、分析响应结果。3.响应分析需关注状态码如200、301/302、403、404,并结合响应内容和响应头进一步判断资源状态。4.代码示例展示了如何使用Java 11的HttpClient进行路径探测,并通过线程池实现并发控制。5.Web资源探测在安全审计、SEO优化、数据采集、网站迁移等方面具有实际应用价值。6.构建高效探测器需注意HTTP客户端选择、并发控制、响应分析逻辑、代理支持和错误处理等细节。7.探测过程中可能面临反爬机制、性能瓶颈、法律风险、误报漏报及网络不确定性等挑战。
使用Java进行Web资源探测,简单来说,就是通过编程的方式,模拟浏览器或爬虫的行为,向目标网站发送HTTP请求,然后分析响应,以此来发现网站上可能存在的、但并非直接通过链接展示出来的文件、目录或接口。这通常涉及到对URL路径的猜测、遍历,以及对HTTP状态码和响应内容的智能判断。
解决方案
要用Java实现Web资源探测,核心在于构造HTTP请求、发送请求并解析响应。现代Java应用,我个人更倾向于使用Java 11引入的java.net.http.HttpClient,它提供了异步、非阻塞的API,用起来比老旧的HttpURLConnection舒服多了,也更适合高并发的探测场景。
一个基本的探测流程大概是这样的:
- 确定目标URL基址:比如
https://example.com/。 - 生成潜在路径列表:这是关键。你可以有一个预设的字典文件(例如,常见目录名如
admin、backup、upload,或常见文件名如config.php、.env、robots.txt),也可以根据已知的URL结构进行推测(比如/v1/api/users到/v2/api/users)。 - 构造并发送HTTP请求:对每个潜在路径,拼接成完整的URL,然后使用
HttpClient发送GET请求。 - 分析HTTP响应:
- 状态码:200 OK (资源存在),301/302 Redirect (资源移动),403 Forbidden (无权限访问但资源可能存在),404 Not Found (资源不存在)。403和404尤其需要区分,因为403往往意味着“这里有东西,但你不能看”,而404就是“啥都没有”。
- 响应内容:有些网站对404页面会返回自定义内容,甚至返回200状态码但内容是“页面不存在”。这时就需要通过分析HTML内容来判断是否是真正的404。比如,可以检查响应体中是否包含“Not Found”、“页面不存在”等关键词。
- 响应头:例如
Content-Length,如果一个404页面和实际存在的页面大小差异很大,也可以作为判断依据。
这里给一个简化版的Java代码示例,展示如何使用HttpClient进行基本的路径探测:
import java.io.IOException;
import java.net.URI;
import java.net.http.HttpClient;
import java.net.http.HttpRequest;
import java.net.http.HttpResponse;
import java.util.Arrays;
import java.util.List;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

public class WebPathDiscoverer {

    private final HttpClient httpClient;
    private final String baseUrl;
    private final List commonPaths;
    private final ExecutorService executorService;

    public WebPathDiscoverer(String baseUrl, List commonPaths) {
        this.baseUrl = baseUrl;
        this.commonPaths = commonPaths;
        // 建议使用一个线程池来管理并发请求,避免资源耗尽
        this.executorService = Executors.newFixedThreadPool(10); // 10个并发线程
        this.httpClient = HttpClient.newBuilder()
                                    .executor(executorService) // 将线程池注入HttpClient
                                    .connectTimeout(java.time.Duration.ofSeconds(5)) // 连接超时
                                    .build();
    }

    public void discover() {
        System.out.println("开始探测基址: " + baseUrl);
        List> futures = commonPaths.stream()
                .map(path -> CompletableFuture.runAsync(() -> checkPath(path), executorService))
                .toList();

        // 等待所有异步任务完成
        CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).join();
        System.out.println("探测完成。");
        executorService.shutdown(); // 关闭线程池
        try {
            if (!executorService.awaitTermination(60, TimeUnit.SECONDS)) {
                executorService.shutdownNow(); // 强制关闭
            }
        } catch (InterruptedException e) {
            executorService.shutdownNow();
            Thread.currentThread().interrupt();
        }
    }

    private void checkPath(String path) {
        String fullUrl = baseUrl + (path.startsWith("/") ? path : "/" + path);
        HttpRequest request = HttpRequest.newBuilder()
                                         .uri(URI.create(fullUrl))
                                         .GET()
                                         // 模拟浏览器User-Agent,避免被直接屏蔽
                                         .header("User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/100.0.4896.127 Safari/537.36")
                                         .build();
        try {
            HttpResponse response = httpClient.send(request, HttpResponse.BodyHandlers.ofString());
            int statusCode = response.statusCode();

            // 简单的判断逻辑,实际应用中会更复杂
            if (statusCode == 200) {
                // 进一步判断是否是自定义404页面,例如检查响应体内容
                if (response.body().contains("Page Not Found") || response.body().contains("您访问的页面不存在")) {
                    System.out.println("[伪200/404] " + fullUrl + " -> 状态码: " + statusCode);
                } else {
                    System.out.println("[发现] " + fullUrl + " -> 状态码: " + statusCode + " (内容长度: " + response.body().length() + ")");
                }
            } else if (statusCode == 403) {
                System.out.println("[禁止访问] " + fullUrl + " -> 状态码: " + statusCode);
            } else if (statusCode == 301 || statusCode == 302) {
                System.out.println("[重定向] " + fullUrl + " -> 状态码: " + statusCode + " -> Location: " + response.headers().firstValue("Location").orElse("N/A"));
            } else if (statusCode == 404) {
                // System.out.println("[未找到] " + fullUrl + " -> 状态码: " + statusCode); // 404太多,通常不打印
            } else {
                System.out.println("[其他状态] " + fullUrl + " -> 状态码: " + statusCode);
            }

        } catch (IOException | InterruptedException e) {
            // System.err.println("请求 " + fullUrl + " 失败: " + e.getMessage()); // 太多错误,通常不打印
            Thread.currentThread().interrupt(); // 重新设置中断状态
        }
    }

    public static void main(String[] args) {
        String targetBaseUrl = "http://example.com"; // 替换为你要探测的目标网站
        List pathsToProbe = Arrays.asList(
            "admin/", "login.jsp", "config.php", "robots.txt", ".env", "sitemap.xml",
            "backup/", "upload/", "test/", "api/v1/users", "css/style.css", "images/logo.png"
        );

        WebPathDiscoverer discoverer = new WebPathDiscoverer(targetBaseUrl, pathsToProbe);
        discoverer.discover();
    }
}
这段代码提供了一个基础框架,实际应用中你需要维护一个更庞大、更智能的路径字典,并考虑更复杂的响应分析逻辑。
Web资源探测在实际应用中有哪些价值?
说实话,Web资源探测这东西,听起来有点“黑科技”的意思,但它在很多正规场景下都非常有价值。在我看来,它远不止是安全测试人员的专属工具,其应用范围比很多人想象的要广。
首先,安全审计和漏洞发现是它最直接、最显著的价值。很多时候,开发者可能会不小心将敏感文件(比如备份文件、配置文件、日志文件、源代码泄露)或者未授权的后台管理界面、测试接口遗留在生产环境中。这些资源可能没有在网站的任何地方被链接,但它们确实存在于服务器上。通过探测,我们可以发现这些“隐藏”的入口,从而在恶意攻击者发现它们之前修复这些潜在的安全漏洞。这就像是给自己的房子做一次彻底的安检,看看有没有哪个窗户没关严实。
其次,在SEO优化和网站健康度检查方面,它也大有用武之地。一个网站可能会因为各种原因产生死链(404页面)或者重复内容,这些都会影响搜索引擎的排名。通过探测,我们可以发现那些不应该存在的404页面,或者找到那些被意外创建的重复URL。这有助于我们清理网站,提升用户体验,也让搜索引擎更“喜欢”我们的网站。
再来,对于数据采集和内容聚合,探测也是一个基础能力。比如,你想抓取一个网站上所有公开的图片、PDF文档或者其他类型的文件,但网站并没有提供一个集中的下载页面。这时,通过对常见文件路径和扩展名的探测,你就能有效地找到并下载这些资源。这在学术研究、市场分析或者个人兴趣项目里都挺常见的。
最后,在网站迁移或重构时,Web资源探测也能发挥作用。确保所有旧的URL都被正确地重定向到新的URL,或者确认所有不再需要的旧资源已经被彻底删除,这对于保持网站的连续性和避免用户访问错误页面至关重要。我曾经遇到过一些网站迁移后,很多老链接都失效了,用户体验很糟糕,如果当时能提前做一次全面的资源探测,就能避免很多麻烦。
构建高效的Java Web资源探测器需要注意哪些细节?
构建一个高效且稳定的Java Web资源探测器,可不是简单地循环发请求那么容易。这里面门道不少,有很多细节需要我们仔细打磨。
第一点,也是最核心的,就是HTTP客户端的选择与配置。前面提到了HttpClient,它确实是Java 11+的首选,因为它原生支持异步请求,这对于并发探测至关重要。如果你还在用老版本的Java,或者有特殊需求,可以考虑Apache HttpClient或OkHttp,它们都是非常成熟且功能强大的第三方库。但无论选哪个,都要注意配置连接池、超时时间、重试策略。一个好的客户端配置能让你在面对高延迟或不稳定的网络环境时,依然保持较高的成功率和效率。别忘了设置User-Agent,模拟主流浏览器,否则一些网站可能会直接拒绝你的请求。
第二点,是并发控制与资源管理。探测大量路径时,如果每个请求都阻塞等待,效率会非常低下。所以,引入线程池(如ExecutorService)来管理并发请求是必须的。但并发也不是越多越好,过高的并发可能会瞬间压垮目标服务器,导致你的IP被封,或者被认为是拒绝服务攻击。所以,要合理设置线程池的大小,并且考虑引入一个令牌桶或漏桶算法来实现请求速率限制,做个“好公民”,不要给目标服务器带来不必要的负担。同时,要注意内存消耗,尤其是当你要处理大量响应体时。
第三点,智能的响应分析逻辑是区分一个普通探测器和优秀探测器的关键。仅仅判断HTTP状态码是远远不够的。很多网站会为404页面返回200状态码,但内容是“页面不存在”;或者403页面内容是“您无权访问”。我们需要编写更复杂的逻辑来解析响应体,比如检查特定的关键词、页面结构、或者计算页面内容的哈希值,以此来区分真实的资源和伪装的错误页面。此外,对于301/302重定向,我们可能需要决定是否跟随重定向,以及如何处理重定向链。
第四点,代理支持和IP轮换。如果你需要探测大量网站,或者目标网站有严格的IP限制,那么使用代理服务器,并实现IP轮换就变得非常必要。这样可以有效避免单个IP因请求量过大而被目标网站封禁。当然,这又会引入代理的管理、可用性检测等额外复杂性。
第五点,错误处理与日志记录。网络请求总是充满不确定性,连接超时、DNS解析失败、目标服务器无响应等情况时有发生。你的探测器必须能够优雅地处理这些异常,而不是直接崩溃。详细的日志记录也必不可少,它能帮助你追踪探测进度、发现问题、并记录所有发现的有效资源。
Web资源探测可能面临哪些挑战与风险?
Web资源探测这活儿,听起来挺酷,但实际操作起来,你会发现它充满了各种挑战,甚至还伴随着一些潜在的风险。这可不是随便写几行代码就能搞定的。
首先,最直接的挑战就是反爬虫和反自动化机制。现在很多网站都有很强的防护措施。你可能刚发了几个请求,就被目标网站识别为非人类访问,然后你的IP就被封了,或者被要求输入验证码(CAPTCHA)。这些机制包括但不限于:检查User-Agent、Referer等HTTP头;基于IP的请求频率限制;JavaScript挑战(要求浏览器执行JS来生成特定token);甚至是更复杂的机器学习模型来识别异常行为。面对这些,你的探测器可能需要模拟更真实的浏览器行为,甚至集成无头浏览器(比如Selenium或Playwright)来执行JavaScript,但这无疑会大大增加复杂度和资源消耗。
其次,是性能与资源消耗的问题。如果你要探测的路径数量庞大,比如几十万、上百万,那么如何在有限的硬件资源下高效完成探测就成了大问题。大量的并发请求会消耗大量的网络带宽、CPU和内存。如果你的代码没有经过精心优化,很可能会导致内存溢出或者网络I/O瓶颈。而且,持续的高并发请求也可能对目标服务器造成压力,甚至在极端情况下导致对方服务不稳定,这就涉及到下一个更严肃的问题。
再者,法律与道德风险是绝对不能忽视的。未经授权对他人网站进行大量的自动化请求,轻则可能被对方封禁IP,重则可能被视为恶意攻击(如DDoS),从而面临法律诉讼。在进行任何探测活动之前,务必确保你拥有明确的授权,或者你的行为完全符合目标网站的robots.txt规则和服务条款。即使是出于“善意”的安全测试,也需要提前沟通并获得书面许可。这是底线,绝不能触碰。
还有,误报和漏报也是一个实际问题。前面提到了自定义的404页面,它们可能返回200状态码,内容却是“页面不存在”。如果你的探测器不够智能,就可能把这些误判为真实资源。反之,有些资源可能被隐藏在动态生成的页面后面,或者需要特定的HTTP方法(POST、PUT等)才能访问,简单的GET请求就可能导致漏报。区分这些需要更深入的协议理解和响应分析能力。
最后,网络环境的不确定性也常常让人头疼。DNS解析失败、网络连接中断、目标服务器暂时离线、防火墙阻断等等,这些都可能导致你的请求失败。你的探测器需要有强大的容错机制,比如重试逻辑、超时设置,以应对这些突发状况,确保探测的稳定性和完整性。
Yandex官网入口是https://www.yondex.net/,该平台支持多语言切换、智能搜索匹配、虚拟键盘变更及实时翻译,提供地图、图片、新闻、购物等垂直服务,并具备账户同步、隐私管理、个性化首页和云存储等功能。
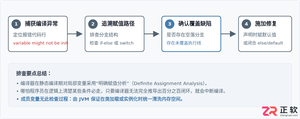
深入解析Java中局部变量未初始化编译报错与成员变量自动赋予默认值的机制差异,涵盖JVM内存分配、编译期确定性赋值检查与实际排查修复方案。
详细讲解在Java中获取当前系统时间并进行格式化输出的两种核心方案:基于Java 8全新日期时间API的DateTimeFormatter与传统遗留的SimpleDateFormat,包含完整代码示例、线程安全机制对比及生产选型建议。
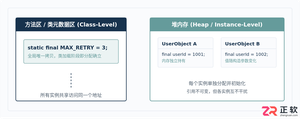
深入解析Java中final变量与static final常量的定义、内存语义、初始化时机及合法赋值路径,涵盖编译期常量优化与实战避坑指南。
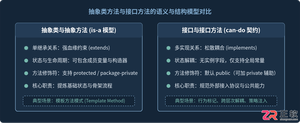
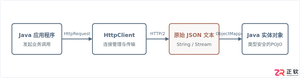
本文提供Java标准库HttpClient发起HTTP GET/POST请求并结合Jackson进行JSON数据反序列化与序列化的完整代码示例与工程实践指南。
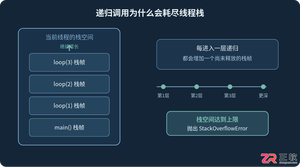
详细分析Java递归调用出现StackOverflowError的原因,结合代码说明线程栈、栈帧和递归深度之间的关系,并介绍终止条件排查、迭代改写、减少栈帧开销以及通过-Xss调整JVM栈空间的方法。
针对Java中常见的NullPointerException(NPE),本文从堆栈日志定位、典型代码触发场景、具体修复代码对比到防御体系进行系统讲解,提供实用且易上手的排查与修复方案。






火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



