

Reactive Kafka背压机制在Java中的应用解析
本文深入探讨ReactiveKafka中非阻塞背压(Non-blockingBack-pressure)的实现机制。借助Reactor框架,ReactiveKafka能够高效处理数据流,通过flatMap等操作符实现对消息消费速率的精细控制,避免系统过载。文章将提供详细的Java代码示例,并阐述其工作原理及应用的最佳实践,帮助开发者构建健壮、响应式的Kafka消费者。

本文深入探讨Reactive Kafka中非阻塞背压(Non-blocking Back-pressure)的实现机制。借助Reactor框架,Reactive Kafka能够高效处理数据流,通过flatMap等操作符实现对消息消费速率的精细控制,避免系统过载。文章将提供详细的Java代码示例,并阐述其工作原理及应用的最佳实践,帮助开发者构建健壮、响应式的Kafka消费者。
1. 引言:Reactive Kafka与背压
在现代分布式系统中,消息队列如Apache Kafka扮演着至关重要的角色。然而,如果消费者处理消息的速度跟不上生产者发送消息的速度,系统很容易因过载而崩溃。传统的阻塞式消费者在处理消息时,可能会阻塞线程,导致资源浪费和吞吐量下降。
Reactive Kafka是基于Project Reactor构建的Kafka客户端,它将Kafka的消息流转换为响应式流(Reactive Streams),从而能够利用Reactor的非阻塞特性和强大的背压(Back-pressure)机制。背压是一种流控制策略,允许消费者向上游生产者发出信号,告知其能够处理多少数据,从而防止数据洪流压垮消费者。在Reactive Kafka中,这种背压机制是天然且非阻塞的,极大地提升了系统的弹性和稳定性。
2. 非阻塞背压的核心机制
Project Reactor作为Reactive Kafka的基础,其核心在于通过操作符(Operators)来构建数据处理管道。当处理Kafka消息时,KafkaReceiver会暴露一个Flux
flatMap操作符是实现背压的常用且高效方式。当flatMap被应用于一个Flux时,它会为流中的每个元素创建一个新的内部Publisher(例如Mono或Flux),然后将这些内部Publisher的输出扁平化合并到主流中。flatMap的一个重要特性是它可以限制并发处理的内部Publisher数量。当达到并发限制时,flatMap会暂停向上游(即KafkaReceiver)请求新的元素,直到有内部Publisher完成并释放一个并发槽位。这种机制天然地实现了非阻塞背压:
- 非阻塞:即使内部处理耗时,也不会阻塞主线程或Kafka客户端的轮询线程,因为耗时操作通常在独立的线程池中异步执行。
- 背压:通过限制并发处理数,控制了从Kafka拉取消息的速度,避免消费者过载。
3. Java示例:实现Reactive Kafka非阻塞背压
以下是一个使用Java和Spring Boot(虽然示例代码是纯Java,但概念适用于Spring Boot应用)实现Reactive Kafka非阻塞背压的详细示例。
3.1 必要的依赖
在pom.xml中添加Reactive Kafka和Reactor Core依赖:
    io.projectreactor.kafka
    reactor-kafka
    1.3.18


    io.projectreactor
    reactor-core
    3.5.15
3.2 示例代码
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.common.serialization.StringDeserializer;
import reactor.core.publisher.Mono;
import reactor.kafka.receiver.KafkaReceiver;
import reactor.kafka.receiver.ReceiverOptions;
import reactor.kafka.receiver.ReceiverRecord;

import java.time.Duration;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;

public class ReactiveKafkaBackpressureExample {

    public static void main(String[] args) throws InterruptedException {
        // 1. Kafka消费者配置
        Map consumerProps = new HashMap<>();
        consumerProps.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092"); // 替换为你的Kafka地址
        consumerProps.put(ConsumerConfig.GROUP_ID_CONFIG, "my-reactive-group");
        consumerProps.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        consumerProps.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        consumerProps.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");
        // 禁用自动提交,由Reactive Kafka手动管理偏移量,以实现精确的背压和消息确认
        consumerProps.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, false);
        // 调整max.poll.records,避免一次拉取过多消息,与flatMap的并发度协同工作
        consumerProps.put(ConsumerConfig.MAX_POLL_RECORDS_CONFIG, 100);

        // 2. 配置Kafka接收器选项
        ReceiverOptions receiverOptions = ReceiverOptions.create(consumerProps)
                .subscription(Collections.singleton("my-topic")) // 订阅主题
                .addAssignListener(partitions -> System.out.println("分区分配: " + partitions))
                .addRevokeListener(partitions -> System.out.println("分区撤销: " + partitions));

        // 3. 创建Kafka接收器
        KafkaReceiver kafkaReceiver = KafkaReceiver.create(receiverOptions);

        CountDownLatch latch = new CountDownLatch(1); // 用于演示程序运行直到终止

        System.out.println("开始消费Kafka消息,应用非阻塞背压...");

        // 4. 使用flatMap操作符实现背压和消息处理
        kafkaReceiver.receive() // 获取Flux>
                // flatMapWithConcurrency: 指定并发处理消息的数量。
                // 例如,concurrency = 2 意味着最多同时处理2条消息。
                // 当2条消息都在处理中时,KafkaReceiver将暂停从Kafka拉取新消息,直到有处理完成。
                .flatMap(record -> processAndCommit(record), 2) // 设置并发度为2,模拟背压
                .doOnError(e -> System.err.println("消息处理错误: " + e.getMessage())) // 捕获并打印处理过程中的错误
                .doOnTerminate(() -> {
                    System.out.println("Kafka消费者终止。");
                    latch.countDown();
                })
                .subscribe(
                        null, // 不关心每个内部Mono的完成信号,我们只关心整个流的错误和完成
                        error -> System.err.println("流整体错误: " + error), // 捕获整个流的错误
                        () -> System.out.println("流完成。") // 流正常完成(通常不会发生,除非Kafka关闭)
                );

        // 保持主线程运行,直到有信号终止,或达到超时
        latch.await(10, TimeUnit.MINUTES);
    }

    /**
     * 模拟消息处理并提交偏移量
     * @param record 接收到的Kafka消息记录
     * @return 返回一个Mono,表示处理完成
     */
    private static Mono processAndCommit(ReceiverRecord record) {
        return Mono.defer(() -> {
            System.out.println(String.format("收到消息 -> Topic: %s, Partition: %d, Offset: %d, Key: %s, Value: %s",
                    record.topic(), record.partition(), record.offset(), record.key(), record.value()));

            // 模拟一个耗时的业务处理。Mono.delay是非阻塞的。
            return Mono.delay(Duration.ofMillis(500)) // 模拟500ms的异步处理
                    .doOnNext(x -> System.out.println("处理完成 -> Offset: " + record.offset()))
                    .then(Mono.defer(() -> {
                        // 提交偏移量。只有在消息处理成功后才提交。
                        record.receiverOffset().acknowledge();
                        System.out.println("提交偏移量 -> Offset: " + record.offset());
                        return Mono.empty(); // 返回一个完成信号,表示此消息的处理流程已结束
                    }));
        });
    }
}
3.3 代码解析
Kafka消费者配置 (consumerProps):
- BOOTSTRAP_SERVERS_CONFIG:Kafka集群地址。
- GROUP_ID_CONFIG:消费者组ID。
- KEY_DESERIALIZER_CLASS_CONFIG, VALUE_DESERIALIZER_CLASS_CONFIG:消息键值反序列化器。
- ENABLE_AUTO_COMMIT_CONFIG: false:关键设置。禁用Kafka客户端的自动偏移量提交,将偏移量提交控制权交给Reactive Kafka,以便在消息处理完成后手动提交。这是实现精确背压和“至少一次”语义的基础。
- MAX_POLL_RECORDS_CONFIG: 每次poll操作从Kafka获取的最大记录数。虽然flatMap会控制并发,但合理设置此值可以避免一次性拉取过多消息到内存,与flatMap的并发度协同工作。
ReceiverOptions配置:
- subscription(Collections.singleton("my-topic")):订阅一个或多个主题。
- addAssignListener, addRevokeListener:用于监听分区分配和撤销事件,便于日志记录或资源管理。
KafkaReceiver.create(receiverOptions):创建KafkaReceiver实例,它是Reactive Kafka消费者流的入口。
kafkaReceiver.receive():返回一个Flux
.flatMap(record -> processAndCommit(record), 2):
- 这是实现背压的核心。processAndCommit(record)方法返回一个Mono
,代表处理单条消息的异步操作。 - flatMap的第二个参数2指定了并发度。这意味着flatMap将最多同时处理2个Mono(即2条消息)。
- 当有2条消息正在处理中时,flatMap会暂停从kafkaReceiver.receive()请求新的ReceiverRecord,直到其中一个Mono完成。一旦一个Mono完成,flatMap就会向上游请求下一条消息,并启动一个新的Mono进行处理。
- Mono.delay(Duration.ofMillis(500)):在processAndCommit方法中,我们使用Mono.delay模拟了一个耗时500毫秒的异步业务处理。这个操作是非阻塞的,不会占用Kafka客户端的轮询线程。
- record.receiverOffset().acknowledge():在消息处理完成后,手动提交该消息的偏移量。这确保了只有成功处理的消息才会被标记为已消费。
- 这是实现背压的核心。processAndCommit(record)方法返回一个Mono
错误处理 (doOnError, subscribe 的错误回调):
- doOnError:用于在流中发生错误时执行副作用,例如打印错误日志。
- subscribe的错误回调:处理整个流的终止错误。
4. 背压机制深度解析
当flatMap操作符的并发度设置为N时,它的工作原理如下:
- flatMap会首先向上游(KafkaReceiver)请求N个元素。
- KafkaReceiver从Kafka拉取消息,并将N个ReceiverRecord发送给flatMap。
- flatMap为每个ReceiverRecord调用processAndCommit方法,并得到N个Mono。这些Mono开始并行执行(如果它们内部的操作是异步的)。
- 在N个Mono都在处理中时,flatMap不会再向上游请求新的元素。
- 当其中一个Mono完成时,它会释放一个并发槽位。此时,flatMap会向上游请求一个新的元素,以维持N个并发处理。
- 这个过程持续进行,flatMap始终保持最多N个消息在处理中。
这种机制有效地将消费者处理能力反馈给Kafka消息拉取过程。如果processAndCommit方法中的业务逻辑变得缓慢,导致Mono完成时间延长,那么flatMap向上游请求新消息的频率就会降低,从而减缓从Kafka拉取消息的速度,防止消费者被消息淹没。整个过程是非阻塞的,Kafka客户端的poll循环可以继续执行,处理心跳、协调等任务,而不会被业务逻辑阻塞。
5. 注意事项与最佳实践
选择合适的并发度 (flatMap参数):
- 并发度是实现背压的关键参数。设置过高可能导致消费者过载,设置过低可能浪费系统资源,降低吞吐量。
- 应根据业务处理的耗时、CPU核心数、内存等资源进行测试和调优。
- 对于I/O密集型任务,并发度可以设置得高一些;对于CPU密集型任务,并发度不应超过CPU核心数。
异步处理与线程模型:
- 在flatMap内部执行耗时操作时,务必确保这些操作是非阻塞的。例如,使用Mono.delay、Mono.fromCallable().subscribeOn(Schedulers.boundedElastic()) 或 Spring WebFlux 的异步客户端等。
- 避免在响应式流中执行阻塞I/O操作,除非将其包裹在subscribeOn(Schedulers.boundedElastic())中,并清楚其对线程池的影响。
错误处理策略:
- 单条消息处理错误:在processAndCommit内部或flatMap之后使用onErrorResume、onErrorContinue等操作符,可以处理单
chat-demo v0.1.1可以作为静态聊天客户端在本地运行,但模型、搜索、文件和语音能力仍由DeepSeek API提供。源码运行环境为Node.js 22.12及以上、Git与pnpm。Demo版本号不等于应用API版本;这套应用API未单独标版本,默认聊天模型ID是deepseek-flash。
理解GitHub Copilot CLI v1.0.111的高级请求百分比、用户提示活动图与实际路由模型窗口,区分显示口径和任务状态。
按维护分支、利用权限与节点类型对应四项修复,区分正式补丁、Beta和临时缓解的适用边界。

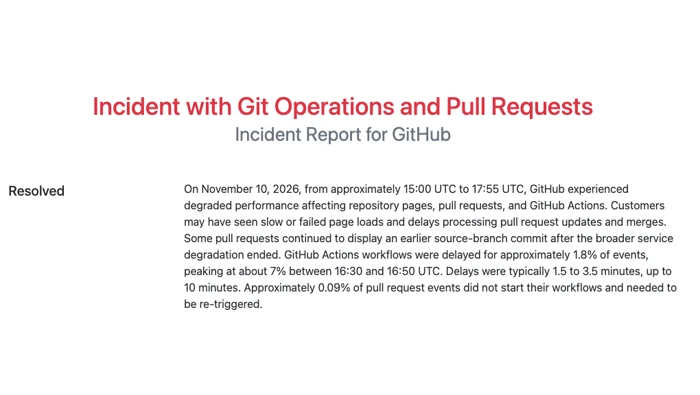
GitHub合并故障中的“已缓解并监控”和“已解决”不能互换。前者表示影响已经采取措施缓解,仍在观察稳定性;后者是供应商正式结束这场事故的状态。11月13日的Pull Requests合并超时事件先进入监控,随后于北京时间11月14日02:29标记为已解决。
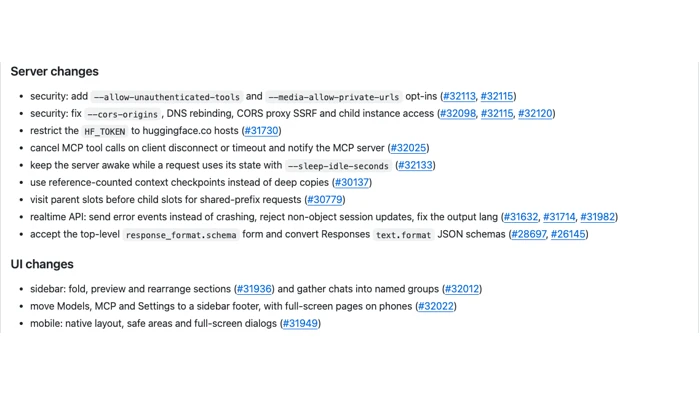
llama.cpp v1.0.0改善聊天组织、长消息编辑和附件预览;界面变化与底层API迁移、缓存及访问边界需要分别理解。
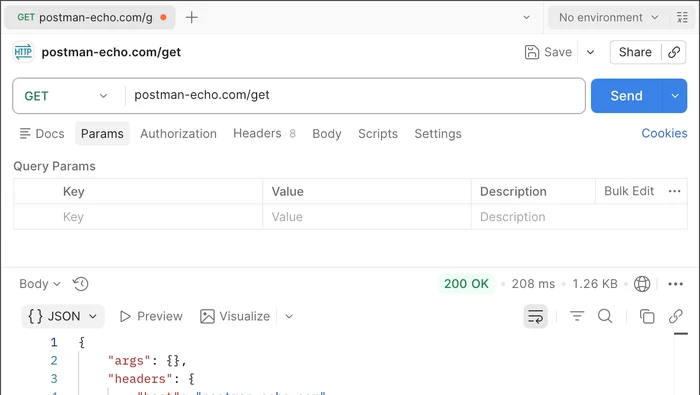
Postman 12.36.4 更新后仍有异常时,可按应用、API请求和平台服务区分问题范围,避免把补丁版本当作故障原因。
按正式、预发布和1.x维护渠道对应补丁,再结合Redis、Agent端点和Pinecone索引判断适用范围。
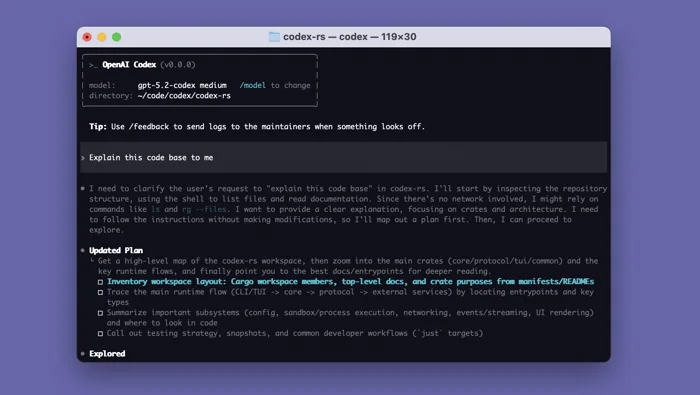
Codex CLI 0.169.0提供有明确说明的终端工作区能力;0.171.0-alpha.2为预发布,当前没有功能清单,选用时应分开评估。
llama.cpp b12345的预发布构建为Hexagon HTP后端增加Q5_0和Q5_1支持。选择模型时需要核对完整量化名称及实际运行后端,不能只看到“Q5”就视为同一种格式。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



