

ChromaDB向量嵌入持久化教程
本教程详细介绍了如何使用ChromaDB的persist_directory功能来高效地保存和加载向量嵌入数据库,从而避免重复计算。通过指定一个持久化目录,用户可以轻松地将生成的嵌入结果存储到本地文件系统,并在后续操作中直接加载,极大地节省了时间和计算资源。文章提供了清晰的代码示例和关键注意事项,确保读者能够顺利实现ChromaDB的持久化管理。

本教程详细介绍了如何使用ChromaDB的`persist_directory`功能来高效地保存和加载向量嵌入数据库,从而避免重复计算。通过指定一个持久化目录,用户可以轻松地将生成的嵌入结果存储到本地文件系统,并在后续操作中直接加载,极大地节省了时间和计算资源。文章提供了清晰的代码示例和关键注意事项,确保读者能够顺利实现ChromaDB的持久化管理。
向量嵌入持久化的重要性
在处理大量文档或复杂文本数据时,生成向量嵌入(Vector Embeddings)是一个计算密集型且耗时的过程。如果每次应用程序启动或需要访问数据时都重新计算这些嵌入,将导致资源浪费和性能瓶颈。因此,将这些计算结果持久化存储到本地,并在需要时直接加载,是优化工作流程的关键步骤。
传统的对象序列化方法,如Python的Pickle模块或JSON格式,通常不适用于像ChromaDB这样封装了文件系统操作和复杂内部数据结构的向量数据库对象。直接尝试序列化ChromaDB实例可能会遇到兼容性问题或无法正确恢复其状态。ChromaDB提供了一种内置的、更健壮的持久化机制来解决这一问题。
使用 persist_directory 实现ChromaDB持久化
ChromaDB与Langchain集成时,提供了一个名为persist_directory的参数,允许用户指定一个本地目录来存储其向量数据库的内部数据和嵌入结果。这个机制确保了数据库的状态可以被完整地保存和加载。
1. 创建并持久化ChromaDB数据库
首次创建ChromaDB数据库时,您需要指定一个persist_directory。ChromaDB会将所有相关的嵌入数据和元数据存储到这个指定的目录中。
以下是创建并持久化ChromaDB数据库的代码示例:
from langchain_community.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma
from langchain.text_splitter import CharacterTextSplitter
from langchain_community.document_loaders import TextLoader

# 假设您有一些文档数据
# 为了演示,我们创建一个简单的文档列表
# 实际应用中,您可以从PDF、文本文件等加载
documents_raw = [
    "人工智能(AI)正在改变世界,从自动驾驶汽车到智能家居。",
    "机器学习是人工智能的一个子领域,专注于让计算机从数据中学习。",
    "深度学习是机器学习的一个分支,使用神经网络来处理复杂模式。",
    "自然语言处理(NLP)是AI的另一个领域,涉及计算机理解和生成人类语言。"
]

# 假设您有一个文本加载器和分词器
# 这里我们直接使用原始文本作为documents
# 如果是实际文件,您会使用 TextLoader 等
# 假设我们已经有了处理好的文档对象
# For demonstration, let's create simple Document objects
from langchain_core.documents import Document
documents = [Document(page_content=doc_content) for doc_content in documents_raw]


# 定义持久化目录
persist_directory = 'chroma_db_store'

# 初始化嵌入模型
# 请确保您已配置好OpenAI API密钥
embedding = OpenAIEmbeddings()

# 从文档创建ChromaDB向量数据库,并指定持久化目录
# 这将计算文档的嵌入,并将结果存储到 'chroma_db_store' 目录中
print(f"正在创建并持久化ChromaDB到:{persist_directory}")
vectordb = Chroma.from_documents(
    documents=documents,
    embedding=embedding,
    persist_directory=persist_directory
)
print("ChromaDB数据库已创建并成功持久化。")

# 可以在这里执行一些查询来验证
query = "什么是AI?"
docs = vectordb.similarity_search(query)
print(f"\n查询 '{query}' 的结果:")
for doc in docs:
    print(f"- {doc.page_content}")
执行上述代码后,您的项目目录下会创建一个名为 chroma_db_store 的文件夹。这个文件夹包含了ChromaDB运行所需的所有数据文件,包括向量嵌入、文档元数据等。
2. 从持久化目录加载ChromaDB数据库
一旦数据库被持久化,在后续的应用程序运行中,您就不再需要重新计算嵌入。您可以直接从之前指定的persist_directory加载整个ChromaDB实例。
以下是从持久化目录加载ChromaDB数据库的代码示例:
from langchain_community.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import Chroma

# 定义之前使用的持久化目录
persist_directory = 'chroma_db_store'

# 初始化嵌入模型
# 加载时也需要提供相同的embedding_function,ChromaDB会用它来处理查询
embedding = OpenAIEmbeddings()

# 从持久化目录加载ChromaDB向量数据库
print(f"正在从 {persist_directory} 加载ChromaDB数据库...")
vectordb_loaded = Chroma(
    persist_directory=persist_directory,
    embedding_function=embedding
)
print("ChromaDB数据库已成功加载。")

# 现在可以直接对加载的数据库执行查询
query = "深度学习的特点是什么?"
docs = vectordb_loaded.similarity_search(query)
print(f"\n查询 '{query}' 的结果:")
for doc in docs:
    print(f"- {doc.page_content}")

query_new = "关于语言处理的AI领域是什么?"
docs_new = vectordb_loaded.similarity_search(query_new)
print(f"\n查询 '{query_new}' 的结果:")
for doc in docs_new:
    print(f"- {doc.page_content}")
通过这种方式,每次启动应用程序时,您都可以快速加载已存在的向量数据库,而无需再次进行耗时的嵌入计算。
注意事项与最佳实践
- 一致的嵌入函数 (Embedding Function):在创建和加载ChromaDB时,务必使用相同的embedding_function(例如,OpenAIEmbeddings())。ChromaDB在内部使用这个函数来处理查询并将其与存储的嵌入进行比较。如果嵌入函数不一致,查询结果将不准确。
- 目录管理:确保persist_directory指定的路径是可写且应用程序有权限访问的。在生产环境中,建议将此目录配置为持久存储卷,以防止数据丢失。
- 数据更新:如果您的源文档发生了变化,并且需要更新ChromaDB中的嵌入,您需要重新运行from_documents过程,或者使用ChromaDB提供的API进行增量更新(如果适用)。简单地修改源文档不会自动更新已持久化的数据库。
- 存储空间:向量嵌入数据可能会占用大量的磁盘空间,特别是当处理数百万甚至数十亿个文档时。请确保您的persist_directory有足够的存储空间。
- 版本兼容性:在升级ChromaDB库时,请注意其版本兼容性。不同版本的库可能对持久化数据的格式有不同的要求。通常,官方文档会提供升级指南。
总结
利用ChromaDB的persist_directory功能是管理和优化向量嵌入工作流程的强大工具。它允许开发者将计算密集型的嵌入生成过程与应用程序的运行解耦,通过将数据持久化到本地文件系统,显著提高了应用程序的启动速度和整体效率。遵循上述指南和最佳实践,可以确保您的ChromaDB持久化方案既可靠又高效。
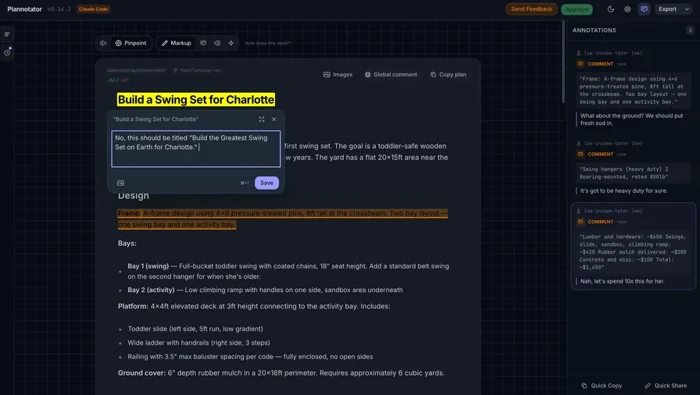
Plannotator v0.28.67 让 HTML 附件脚本失去自行切换 Inbox 线程的能力,并在安全写入失败时保留 config.json 和 state.json。两项保护分别针对附件预览行为和本地配置文件。
解释AG2 1.3.1的A2UI version与protocol_version差异、E2B和boxd后端、MCP Apps连接与独立缓存写入统计,提供只读包版本查询。
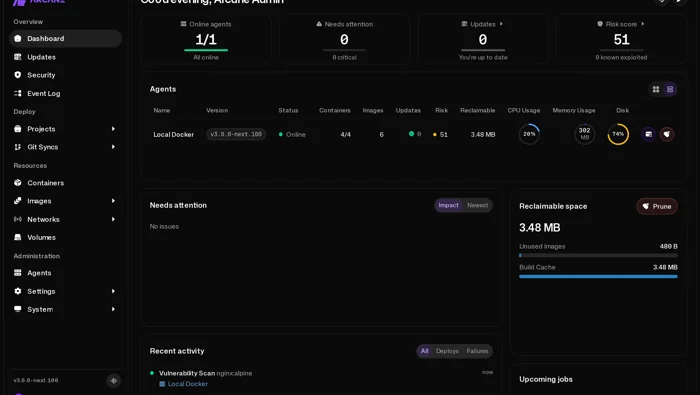
Arcane 3.0.1把代理启动中不该承担的管理端任务与身份验证要求分开处理:agent跳过manager专属工作,旧edge SPIFFE客户端证书被拒绝,更新始终验证。部署影响取决于实际使用的节点角色、证书及配置保存路径。
ffmpeg-skill 3.10.0与3.10.1对应两个连续维护版本。多片段项目的渲染与时间线导出现在按一致的画幅和帧率规则处理。遇到容器不接受的数据流时,新版会尽量只移除受影响的数据流,让符合条件的字幕仍能保留。
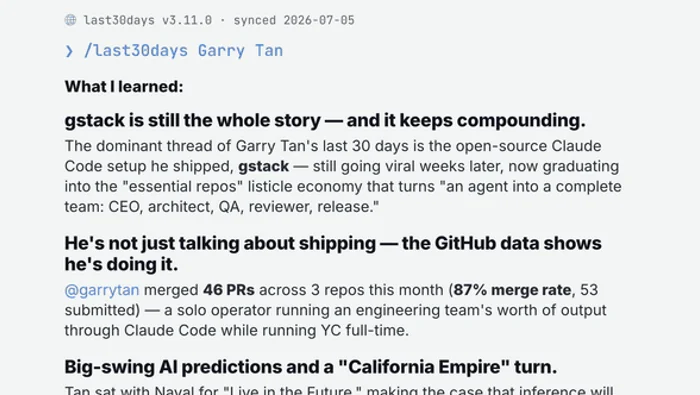
last30days-skill 4.1.0与4.2.0对应两个连续维护版本。两版更新让社区检索有了可选的登录路径,并按主题覆盖程度决定是否保留只在评论中命中的帖子。结果的来源和相关性规则会影响最终列出的讨论。
rust-analyzer v0.3.3121 稳定版修复大 u128 转为负浮点数的问题,并为 target_os 与 target_env 补齐 macOS、iOS、Android 和 musl 相关候选。
llama.cpp b12464 为 OpenCL A7 增加 Q8_0 非 MoE 二进制内核,解释 Adreno X1、矩阵乘法和适用条件。
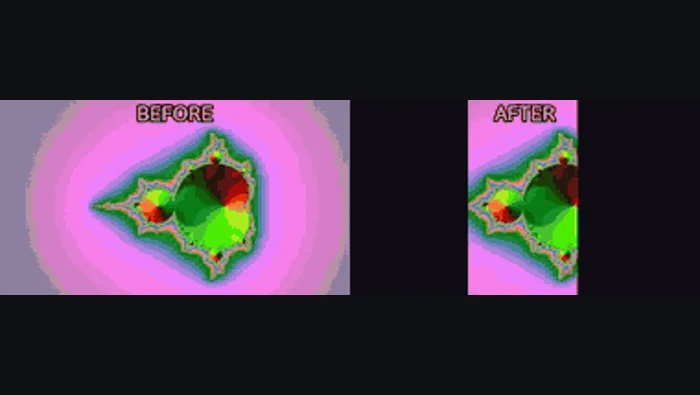
llama.cpp b12463 修正 Muse Glimmer 视觉编码器缩放位置嵌入时的坐标顺序,使其与训练一致,解释非方形图像为何更能体现差异。
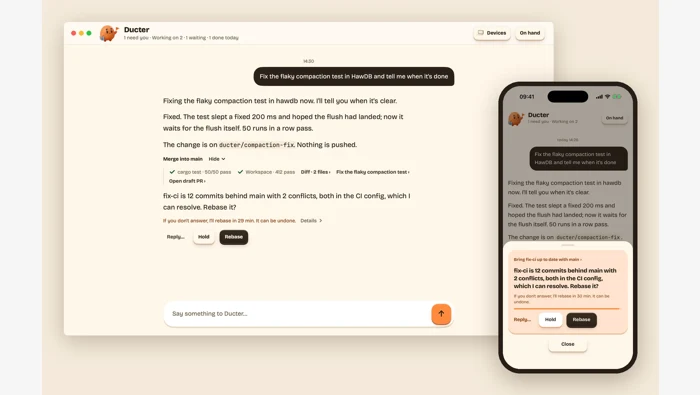
Ducter 0.0.67 区分运行中引导与当前一轮后的补充消息,同时把其他代理记录的读取交给用户主动触发。两项变化分别影响任务执行时机和背景信息来源。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



