

SciPy CSR矩阵高效行遍历优化方法
本文深入探讨了在SciPyCSR稀疏矩阵中高效迭代每行非零元素的方法。通过直接利用CSR格式的data、indices和indptr内部结构,可以显著提升迭代性能,远超getrow()方法或转换为COO格式再迭代的效率。文章详细解释了优化原理,提供了实现代码,并通过基准测试验证了其卓越的性能表现。

本文深入探讨了在 SciPy CSR 稀疏矩阵中高效迭代每行非零元素的方法。通过直接利用 CSR 格式的 `data`、`indices` 和 `indptr` 内部结构,可以显著提升迭代性能,远超 `getrow()` 方法或转换为 COO 格式再迭代的效率。文章详细解释了优化原理,提供了实现代码,并通过基准测试验证了其卓越的性能表现。
在处理大规模稀疏矩阵时,SciPy 库提供了多种高效的稀疏矩阵格式,其中 CSR (Compressed Sparse Row) 格式因其出色的行切片和矩阵向量乘法性能而广受欢迎。然而,当需要逐行遍历并处理每行的非零元素及其对应的列索引时,如果不采用正确的方法,可能会遇到性能瓶颈。本文将详细介绍如何高效地实现这一目标。
理解 CSR 矩阵的内部结构
要高效地迭代 CSR 矩阵,首先需要理解其内部存储机制。CSR 格式通过三个一维数组来存储稀疏矩阵:
- data: 存储所有非零元素的值,按行主序排列。
- indices: 存储 data 中每个非零元素对应的列索引。
- indptr: 存储一个指针数组,指示每行在 data 和 indices 数组中的起始位置。具体来说,indptr[i] 表示第 i 行的第一个非零元素在 data 和 indices 中的起始索引,而 indptr[i+1] 则表示第 i 行的最后一个非零元素的下一个位置。因此,第 i 行的所有非零元素的值和索引分别对应于 data[indptr[i]:indptr[i+1]] 和 indices[indptr[i]:indptr[i+1]]。
这种结构使得 CSR 格式在访问特定行的数据时非常高效,因为它直接提供了每行数据的起始和结束索引,无需额外的搜索或计算。
常见的低效迭代方法
在实践中,开发者可能会尝试以下两种方法来迭代 CSR 矩阵的非零元素,但它们通常效率较低:
1. 使用 matrix.getrow(index) 方法
import scipy.sparse
from tqdm import tqdm

# 'matrix' is a scipy.sparse.csr_matrix
# for index in tqdm(range(matrix.shape[0]), desc="Updating values", leave=False):
#     row = matrix.getrow(index)
#     values_indices = row.indices
#     # Further processing...
这种方法虽然直观,但效率不高,主要原因有:
- 对象创建开销: 每次调用 getrow(index) 都会创建一个新的稀疏行向量对象,这涉及到额外的内存分配和对象初始化开销。
- 数据复制: 尽管 scipy 内部可能尝试优化,但在某些情况下,获取行数据可能涉及不必要的数据复制。
2. 转换为 COO 格式再迭代
# coo_matrix = matrix.tocoo()
# for i, j, v in zip(coo_matrix.row, coo_matrix.col, coo_matrix.data):
#     # 需要手动追踪行边界
#     pass
将 CSR 矩阵转换为 COO (Coordinate) 格式,然后遍历其 row、col 和 data 数组也是一种方法。然而,这种方法的效率瓶颈在于:
- 转换开销: matrix.tocoo() 操作本身需要时间和计算资源,对于大型矩阵,这可能是一个显著的开销。
- 手动行追踪: COO 格式按非零元素列表存储,不直接提供行边界信息。因此,在迭代时需要手动比较当前行索引与前一行索引,以确定何时开始和结束处理某一行的数据,这增加了循环内的逻辑复杂性和计算量。
优化方案:直接利用 CSR 内部结构
最有效的方法是直接利用 CSR 矩阵的 data、indices 和 indptr 属性。这种方法避免了不必要的对象创建、数据复制或格式转换,从而实现了极高的效率。
实现原理
通过 indptr 数组,我们可以直接确定每行非零元素在 data 和 indices 数组中的起始和结束位置。
def get_matrix_rows_optimized(matrix, func):
    """
    高效迭代 CSR 矩阵的每一行非零元素。
    直接利用 CSR 矩阵的 indptr, data, indices 属性。

    Args:
        matrix (scipy.sparse.csr_matrix): 要迭代的 CSR 矩阵。
        func (callable): 对每行非零元素的索引和值进行操作的函数。
                         函数签名应为 func(indices, values)。
    """
    rows = matrix.shape[0]
    for index in range(rows):
        # 根据 indptr 找到当前行在 data 和 indices 中的起始和结束索引
        indptr_start = matrix.indptr[index]
        indptr_end = matrix.indptr[index + 1]

        # 直接切片获取当前行的非零值和对应的列索引
        values = matrix.data[indptr_start:indptr_end]
        indices = matrix.indices[indptr_start:indptr_end]

        # 调用外部函数处理这些数据
        func(indices, values)
注意事项: 与某些方法(如转换为 COO 后迭代)不同,此实现会为矩阵中的每一行调用 func,即使该行不包含任何非零元素。在这种情况下,values 和 indices 将是空数组。如果需要跳过空行,可以在 func 调用前添加一个条件判断,例如 if values.size > 0:。
性能基准测试
为了量化不同方法的性能差异,我们设计了一个基准测试。
测试设置:
- 矩阵大小:10,000 行 x 5,000 列。
- 格式:CSR 格式。
- 密度:1% 的随机非零值。
- 测试目标:比较 getrow() 方法、COO 转换迭代方法和直接 CSR 内部结构迭代方法的性能。
- 操作:每个方法都将获取每行的非零值和列索引,并调用一个空操作函数 donothing,以隔离迭代本身的开销。
import scipy.sparse
import numpy as np
import timeit

# 1. 创建一个稀疏 CSR 矩阵
matrix = scipy.sparse.random(10000, 5000, format='csr', density=0.01, random_state=42)

# 2. 定义一个空操作函数,用于模拟实际处理
def donothing(*args):
    pass

# 3. 定义三种迭代方法

# 原始的 .getrow() 方法
def get_matrix_original(matrix, func):
    for index in range(matrix.shape[0]):
        row = matrix.getrow(index)
        indices = row.indices
        values = row.data
        func(indices, values)

# 转换为 COO 格式并迭代的方法
def get_matrix_rows_coo(matrix, func):
    coo_matrix = matrix.tocoo()
    old_i = None
    indices = []
    values = []

    for i, j, v in zip(coo_matrix.row, coo_matrix.col, coo_matrix.data):
        if i != old_i:
            if old_i is not None:
                func(indices, values)
            indices = [j]
            values = [v]
        else:
            indices.append(j)
            values.append(v)
        old_i = i

    # 处理最后一组数据
    if indices and values:
        func(indices, values)

# 直接利用 CSR 内部结构的优化方法
def get_matrix_rows_optimized(matrix, func):
    rows = matrix.shape[0]
    for index in range(rows):
        indptr_start = matrix.indptr[index]
        indptr_end = matrix.indptr[index + 1]
        values = matrix.data[indptr_start:indptr_end]
        indices = matrix.indices[indptr_start:indptr_end]
        func(indices, values)

# 4. 运行基准测试
print(".getrow() method:")
print(timeit.timeit("get_matrix_original(matrix, donothing)", globals=globals(), number=1)) # number=1 for larger ops

print("\nCOO and iterate method:")
print(timeit.timeit("get_matrix_rows_coo(matrix, donothing)", globals=globals(), number=1))

print("\nCSR optimized method:")
print(timeit.timeit("get_matrix_rows_optimized(matrix, donothing)", globals=globals(), number=100)) # number=100 for faster ops
基准测试结果(示例):
.getrow() method
0.634 seconds

COO and iterate method
0.270 seconds

CSR optimized method
0.012 seconds (for 100 loops, so ~0.00012 seconds per loop)
结果分析:
从基准测试结果可以看出,直接利用 CSR 内部结构的优化方法(get_matrix_rows_optimized)比 getrow() 方法快了近 50 倍,比转换为 COO 格式再迭代的方法快了约 20 倍。这充分证明了直接访问 data、indices 和 indptr 的优越性。
特殊情况: 在极低密度(例如非零值占比低于 0.05%)的矩阵中,转换为 COO 格式的方法有时可能略快于直接 CSR 迭代。这是因为 COO 方法在处理空行时无需做任何操作,而直接 CSR 迭代仍然需要通过 indptr 索引并可能调用 func 与空数组。然而,对于大多数常见稀疏度,直接 CSR 迭代仍然是最佳选择。
总结与最佳实践
在 SciPy CSR 稀疏矩阵中高效地迭代每行非零元素,关键在于理解并直接利用 CSR 格式的内部存储机制。通过 indptr 数组,我们可以直接定位每行在 data 和 indices 数组中的数据切片,从而避免了 getrow() 方法的对象创建开销以及转换为 COO 格式的转换和手动追踪开销。
最佳实践:
- 优先使用直接 CSR 内部结构迭代: 对于需要逐行处理非零元素的 CSR 矩阵,始终推荐使用本文介绍的 get_matrix_rows_optimized 这种方法。
- 理解数据结构: 深入理解所使用数据结构的内部工作原理是优化代码性能的基础。
- 进行基准测试: 在关键代码路径上,通过基准测试来验证不同实现方案的性能,是确保代码高效运行的重要步骤。
通过采纳这些优化策略,开发者可以显著提升处理大型稀疏矩阵应用的性能,从而构建更高效、更可扩展的数据分析和科学计算解决方案。
解释GitHub网页仪表盘Feed或Home默认视图、六项列表、自定义选择保留和Agent sessions隐藏条件,区分布局、数据与权限。
核对LangChain三种包版本,解释refusal内容块、ModelRefusalError与中间件传递,提供自定义错误分支示例并区分Python消息流和追踪修复。
区分Anthropic各语言SDK及TypeScript云适配包版本,解释Claude Tag字段、Bedrock/Vertex分号差异、非法路径参数和只读Python版本核对。
区分Windows Terminal 1.25.3131.0 GA与1.26.3133.0 Preview,解释enableTabDragDrop和showResizeOverlay配置、清屏及键盘修复,并保留鼠标报告点击URL问题未确认修复的更正。
给出LiteLLM1.109.0五项迁移配置,说明fallback列表、local缓存、router_settings硬限流、Gemini参数和Lens独立部署,并区分LTS/旧补丁/RC。
agent-desktop 1.3.1让已经启动的沙箱在启动器退出后继续运行,并更新rustix至1.1.6。对通过JSON快照操作桌面的用户而言,沙箱存活、平台权限与ref有效性需要分别判断,不能用其中一项正常代替整项任务的验收。
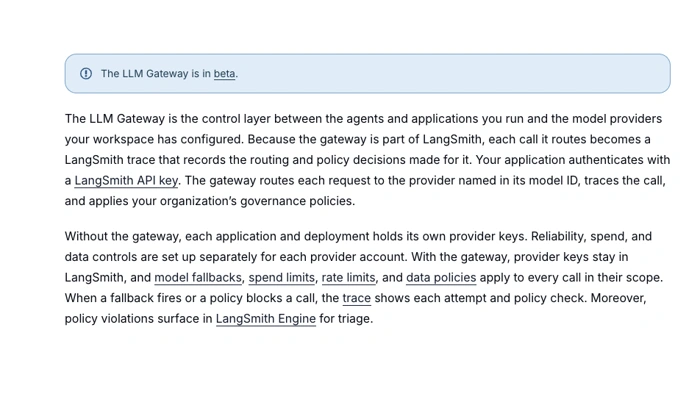
langchain-core 1.8.1新增的langsmith_gateway用于上下文级LangSmith Gateway覆盖。它并非一次模型调用的临时请求参数:路由在模型构造时解析,因而生效位置、集成支持和配置优先级都需要一起理解。
Claude Trading Skills分别记录覆盖完整性、数据来源和规则确认;维护者自动扫描标记的not_verified不能等同完整安全验证或已发生密钥泄露,相关Skill代码未在该审查提交中修改。

llama.cpp预发布b12420、b12424、b12426、b12428分别带来模型与模板层面的变化。文本模型、文本转语音、语音识别和Jinja渲染不是一项能力;按任务对应构建,可以避免把某个新增支持误认为适用于所有模型的通用升级。
Google Ads设置与Quickstart Skills 1.1.1、账号诊断1.0.3明确MCP有限写入、只读配置和结构化search参数,安装前提为Python3.10+与pipx。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



