PHP数组筛选含HTML标签项技巧
用preg_match('/<[\w]1*>/i',$item)可快速识别含HTML标签的数组元素,需先is_string()过滤非字符串项,并配合array_filter批量筛选,注意处理<实体编码及避免跨标签误匹配。>↩
用 preg_match('/<[\w]1*>/i', $item) 可快速识别含 HTML 标签的数组元素,需先 is_string() 过滤非字符串项,并配合 array_filter 批量筛选,注意处理 < 实体编码及避免跨标签误匹配。> ↩
如何用 preg_match 快速识别含 HTML 标签的数组元素
PHP 数组里混入带 HTML 标签的字符串很常见,比如从富文本编辑器或 CMS 导出的数据。直接用 strip_tags() 会删内容,而筛选需求是「只留下有标签的项」——这时别想复杂,正则最直接。
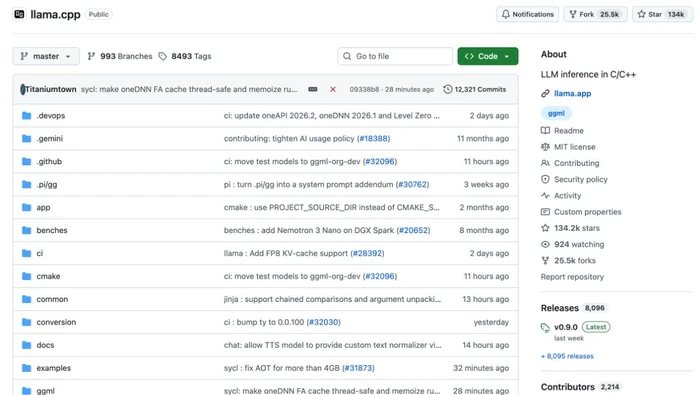
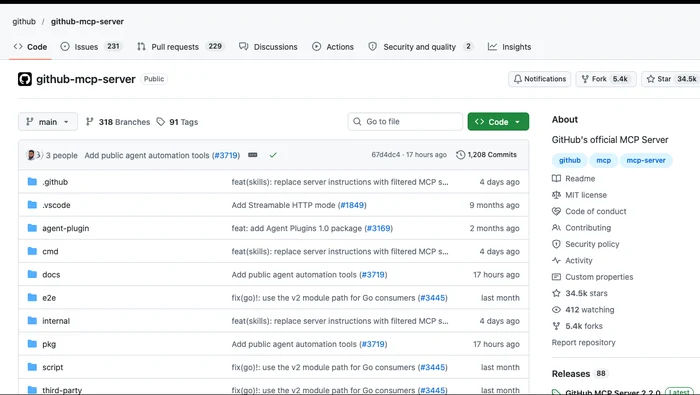
核心逻辑:匹配任意成对或自闭合的 HTML 标签(如 一次性处理整个数组,推荐用 几个关键点: 有些数据里 HTML 标签被转义成 如果这个筛选逻辑高频调用(比如在循环中处理上千条记录),每次 真正麻烦的不是怎么写,而是数据来源是否可信:用户输入、第三方 API、旧系统导出……每种场景下「什么是合法 HTML 标签」的定义都不同,得按实际边界来调正则,而不是套一个万能表达式。 ChatGPT for Academic Researchers 的五万份资助面向下一轮合格申请,全计划二十万人是长期覆盖目标。试点调查另有独立样本与证据口径。 llama.cpp b12457 为 OpenCL 的 A7 路径增加 Q4_K 非 MoE 二进制内核,说明后端、量化及模型执行路径的适用范围。 ChatGPT for Healthcare 将代理、搜索和医疗插件放在同一产品体系中。开通资格与组织设置决定成员能看到哪些工具。 GitHub MCP Server v2.2.0 提供可选的过滤技能目录、代理自动化工具和秘密扫描告警隐藏参数。 OpenBot v1.1.0-rc.1 启动时执行不可逆数据库迁移,PostgreSQL 采用两个受限角色,早期 API 迁至 /api/v2/。 open-code-review v1.13.11 支持按分支筛选现有会话,增加 Move 审查规则,并修正路径、MCP 配置及部分失败状态显示。 GitHub Desktop 3.6.12-beta2 在同一主机涉及多个账号时按仓库关联账号分组,并减少两项 Copilot 操作中的响应格式失败。 GitHub Copilot CLI 1.0.113-1预发布版中的浏览器控制针对内置 Browser Use,由管理员通过托管设置管理。 Qwen Code v0.27.4-nightly.20261116.eb3a599ef3 调整终端、无界面会话和子代理的默认共享循环,并保留命令确认中的完整命令。 GitHub Desktop 3.6.11的变化作用于客户端自带Git,该组件更新到2.56.1。独立安装的命令行Git仍是另一个环境;官方本版记录没有表示桌面客户端升级会替用户同步更新电脑上的其他Git安装。 火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。),只要字符串中出现一次就算命中。
preg_match('/<[a-zA-Z][^>]*>/i', $item) 是轻量可靠的判断式,比全量解析快得多,且不依赖 DOM 扩展/<.*?>/s —— 它会跨行误匹配注释或 JS 字符串里的 <,导致假阳性null、int),先用 is_string($item) 过滤,避免警告用
array_filter + 匿名函数批量筛选array_filter 配合内联判断,代码干净且可读性强。$htmlItems = array_filter($data, function($item) {
return is_string($item) && preg_match('/<[a-zA-Z][^>]*>/i', $item);
});
array_values())htmlspecialchars() 或 strip_tags() 做预处理——它们会改变原始内容,干扰标签检测'/<(?![?!\/])[a-zA-Z][^>]*>/i'遇到
< 实体编码怎么办?preg_match 默认无法识别。不能盲目 html_entity_decode(),因为可能把本意就是显示符号的 < 错解成标签。
strpos($item, '<') !== falsehtml_entity_decode($item, ENT_NOQUOTES, 'UTF-8')性能敏感场景下避免重复正则编译
preg_match 都会重新编译正则,开销可测。
define('HTML_TAG_PATTERN', '/<[a-zA-Z][^>]*>/i');preg_match(HTML_TAG_PATTERN, $item) 会被自动优化strpbrk($item, '<') 快速初筛,再对含 < 的项做正则精判——但要注意 < 可能出现在 JS/CDATA 中,需二次验证