

Hibernate 查询执行缓慢的真相:参数化 SQL 与执行计划优化差异
Hibernate执行相同SQL比原生客户端慢数十倍,主因并非网络或连接问题,而是JDBCPreparedStatement的参数化特性导致数据库优化器生成次优执行计划,加之Hibernate默认全量拉取结果集,双重因素显著拖慢响应。

Hibernate 执行相同 SQL 比原生客户端慢数十倍,主因并非网络或连接问题,而是 JDBC PreparedStatement 的参数化特性导致数据库优化器生成次优执行计划,加之 Hibernate 默认全量拉取结果集,双重因素显著拖慢响应。
Hibernate 执行相同 SQL 比原生客户端慢数十倍,主因并非网络或连接问题,而是 JDBC PreparedStatement 的参数化特性导致数据库优化器生成次优执行计划,加之 Hibernate 默认全量拉取结果集,双重因素显著拖慢响应。
在实际开发中,你可能遇到这样令人困惑的现象:一条由 Hibernate 自动生成的 SQL,在 SQL Developer、DBeaver 等客户端中执行仅需 1.5 秒,而通过 session.createNativeQuery() 或 JPA Repository 触发时却耗时 70+ 秒(如日志所示:67839913762 nanoseconds ≈ 67.8 秒)。这并非 Hibernate “变慢了”,而是其底层执行机制与数据库查询优化逻辑产生了隐性冲突。
? 根本原因剖析
1. 执行计划差异:参数化 vs 字面量 SQL
Hibernate 始终使用 PreparedStatement(带 ? 占位符),例如:
SELECT * FROM GP_CUSTOMER WHERE CUSTNO = ?
而 SQL 客户端通常执行的是“字面量 SQL”(Literal SQL):
SELECT * FROM GP_CUSTOMER WHERE CUSTNO = 'C123456789'
关键区别在于:
✅ 字面量 SQL 允许数据库优化器基于具体值(如 'C123456789')精确估算选择率、索引区分度、数据分布,从而生成高效率的执行计划(如走索引范围扫描);
⚠️ 参数化 SQL 因缺乏实际值,优化器往往采用保守估计(如假设选择率为 1% 或全表扫描),尤其在统计信息陈旧、列基数高或存在绑定变量窥探(Bind Variable Peeking)禁用时,极易生成低效计划(如全表扫描 + 排序)。
? Oracle 中可通过 ALTER SESSION SET "_optim_peek_user_binds" = TRUE 启用绑定变量窥探(默认 11g+ 已启用,但 RAC 或特定补丁版本可能关闭);PostgreSQL 14+ 支持 PREPARE 语句的计划重编译;MySQL 则依赖 prepared_statement_cache_size 和查询缓存策略。
2. 结果集处理方式不同
SQL 客户端通常只获取前 N 行(如默认 fetch size=50)用于展示,而 Hibernate 在执行 findAll() 或分页查询时,会完整遍历 ResultSet 并映射全部实体(即使 PageRequest.of(0, 10) 只需 10 条)——因为 JpaRepository.findAll(Pageable) 底层仍需先执行 COUNT(*) + 主查询,且主查询未加 LIMIT(除非配置 hibernate.order_by.default_null_ordering 或使用 @Query 自定义)。
以你的示例为例:
public PagefindAllCustomers() { Pageable limit = PageRequest.of(0, 10); return gpCustomerRepository.findAll(limit); // ❌ 实际触发 COUNT + 全表 SELECT }
若表中有百万级记录,Hibernate 会加载全部结果再截取前 10 条(除非数据库方言支持 OFFSET/FETCH 下推),造成严重 I/O 与内存开销。
✅ 验证与解决方案
▪ 步骤一:公平对比 —— 用 JDBC 复现 Hibernate 行为
编写纯 JDBC 测试,完全模拟 Hibernate 流程:
String sql = "SELECT CUSTNO, COMPANY FROM GP_CUSTOMER";
try (Connection conn = dataSource.getConnection();
     PreparedStatement ps = conn.prepareStatement(sql);
     ResultSet rs = ps.executeQuery()) {

    int count = 0;
    while (rs.next()) { // ⚠️ 必须遍历到底!否则不反映真实耗时
        count++;
        // 映射 GpCustomer(模拟 Hibernate 实体化)
        new GpCustomer(rs.getString("CUSTNO"), rs.getString("COMPANY"));
    }
    System.out.println("Fetched " + count + " rows");
}若此时耗时也飙升至分钟级,则确认是数据库执行计划或全量拉取所致,而非 Hibernate 框架开销。
▪ 步骤二:优化策略清单
| 方案 | 操作 | 适用场景 |
|---|---|---|
| 启用绑定变量窥探 | Oracle:ALTER SYSTEM SET "_optim_peek_user_binds" = TRUE SCOPE=BOTH; | 使用 PreparedStatement 且统计信息准确 |
| 强制使用字面量(慎用) | @Query(value = "SELECT * FROM GP_CUSTOMER WHERE CUSTNO = :custno", nativeQuery = true) + @QueryHints(@QueryHint(name = "org.hibernate.cacheable", value = "false")) | 超高频、低基数查询(避免 SQL 注入!) |
| 分页下推优化 | 升级到 Spring Data JPA 3.0+,确保 spring.jpa.database-platform=oracle(自动使用 OFFSET ... FETCH) | 大表分页,避免 COUNT(*) + 全查 |
| 添加查询提示(Hint) | @Query("SELECT /*+ INDEX(e IDX_CUSTNO) */ e FROM GpCustomer e") | 明确引导优化器走索引 |
| 更新统计信息 | Oracle: EXEC DBMS_STATS.GATHER_TABLE_STATS('SCHEMA', 'GP_CUSTOMER'); | 表数据变更频繁后必做 |
▪ 步骤三:监控与诊断(推荐)
- 开启 Oracle SQL Trace + TKPROF,对比两者的 Execution Plan(关注 Rows, Cost, Operation);
- 使用 V$SQL_PLAN 查看 SQL_ID 对应的实际执行计划是否一致;
- Hibernate 日志中开启 logging.level.org.hibernate.type.descriptor.sql.BasicBinder=TRACE,确认绑定参数值是否合理(如空值、极长字符串导致隐式类型转换)。
? 总结
Hibernate 本身不“慢”,它只是将 JDBC 的通用性与 ORM 抽象代价显性化。性能落差的本质,是数据库优化器在面对参数化 SQL 时的信息缺失,叠加 ORM 全量映射的默认行为。解决思路始终围绕两点:
? 让数据库“看清”参数价值(通过统计信息、绑定窥探、Hint);
? 让 Hibernate “少做无用功”(分页下推、延迟加载、投影查询 @Query("SELECT new dto(...)"))。
切勿直接归咎于框架——精准定位执行计划差异,才是破局关键。
Nod 0.8.1补充连接服务状态与原因、Attio Cloudflare 403诊断,并让Gmail在连接服务429或503后延后计划轮询。
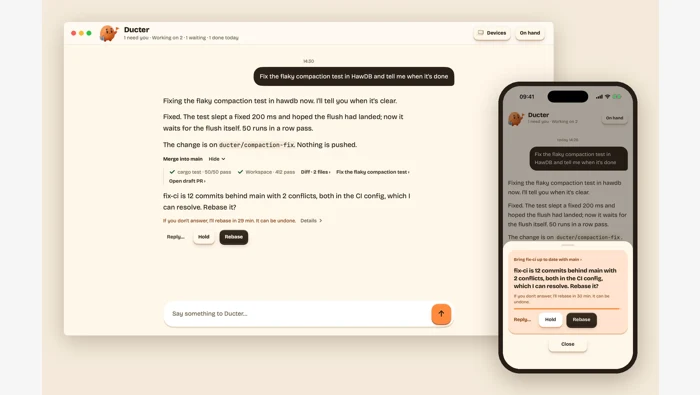
Ducter 0.0.59扩展Telegram、Slack和Mac iMessage会话,区分项目目录来源、Git可选、等待状态与附件入口。
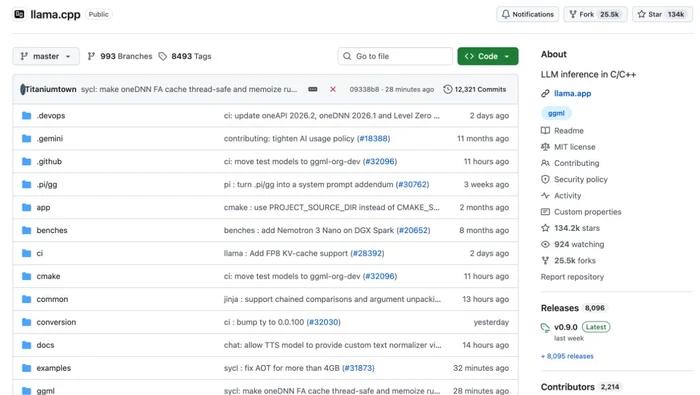
llama.cpp b12435、b12436、b12438预发布构建,分别解释Vulkan并列选择确定性、32位编译与Jinja JSON键排序的适用范围。
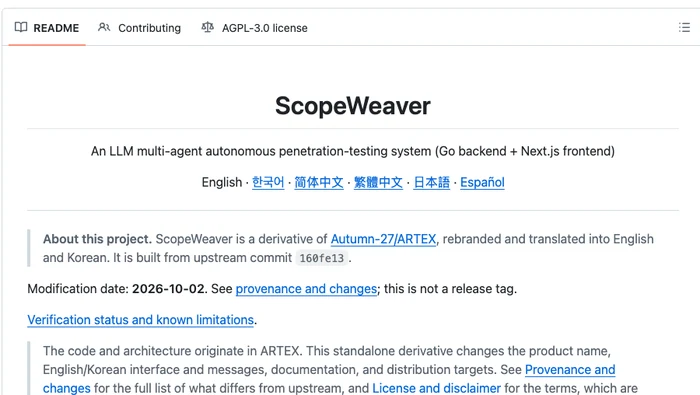
ScopeWeaver 0.9.2、0.9.3与0.9.4分别调整桥运行时、Zod依赖和同进程服务器重建后的暂停状态;区分版本对象与作者本地研究用途声明。
AG2 1.3.2统一缓存Token统计并更新ACP1.x依赖;解释预算提前触达、报表口径与Python3.15构建限制。

llama.cpp b12433避免AMD设备将奇数src0列送入需要偶数列的MMVF路径:满足偶数条件才保留MMVF,其他形状沿用既有回退。对应改动发生在MUL_MAT_ID处理和相关同步判断中,范围限定于代码说明中的类型与token条件。
Ducter 0.0.58调整任务阅读、执行中消息和后台会话,区分下一步发送与做完再说,并说明tailnet HTTPS辅助的条件。
Unlimited OCR 2官方确认百度智能云TextMind渠道;区分云端入口、账号权限配额与本地模型部署,避免混淆接口和计费条件。
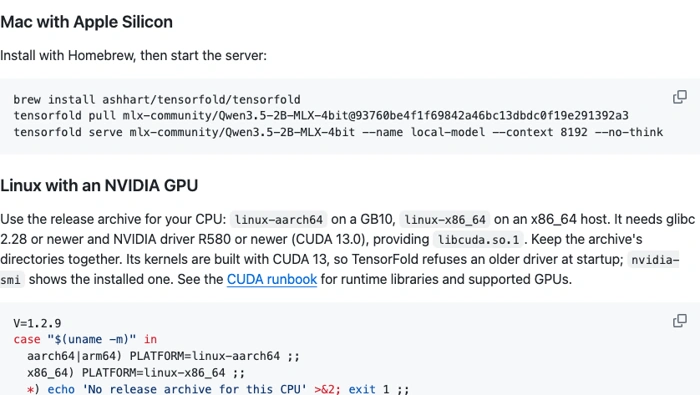
TensorFold 1.2.9的服务配置文件用于保存和复用启动参数,Ollama兼容API则在同一推理路径上提供聊天、生成和模型查询等接口。理解配置优先级及后端限制,比只看到“兼容”就直接迁移全部流量更有用。
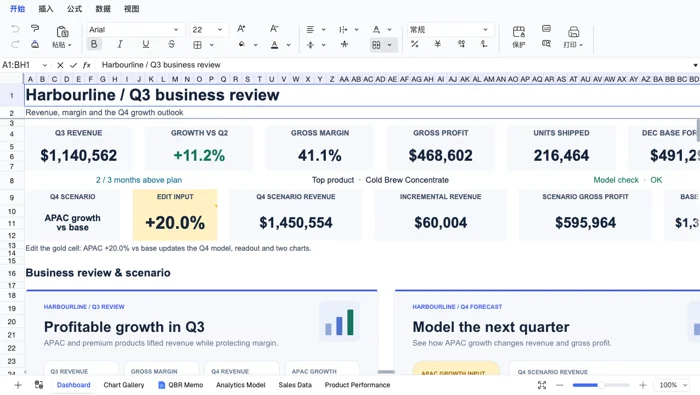
理解Univer 1.5.2的关键,是把额外混淆与构建压缩分开。本版删除二次混淆插件及相关配置,同时保留Pro模块的minify设置;它解释的是产物处理方式的变化,不代表增加了表格或公式能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



