

Django处理海量历史数据的冷热分离方法
真正的冷热分离核心是热数据留主库、冷数据移出主库以降低索引压力、减少备份体积并避免拖慢查询计划器;否则跨分区查询仍会全表扫描。
真正的冷热分离核心是热数据留主库、冷数据移出主库以降低索引压力、减少备份体积并避免拖慢查询计划器;否则跨分区查询仍会全表扫描。
冷热分离不是加个路由就能解决的
直接在 Django 的 urls.py 里按时间分路由(比如把 /archive/2020/ 指向另一个 view)只是表层分流,不碰数据存储结构。真正的冷热分离核心是:**热数据留在主库高频读写,冷数据移出主库、降低索引压力、减少备份体积、避免拖慢查询计划器**。否则哪怕你路由分开了,Article.objects.filter(pub_date__year=2018) 这类跨分区查询仍会扫全表或触发低效索引,PostgreSQL 或 MySQL 都扛不住千万级历史记录。
用 Django ORM 做归档迁移容易踩的三个坑
别用 QuerySet.delete() + bulk_create() 直接搬——它不保留自增 ID、不处理外键约束、不兼容事务回滚边界。生产环境必须保证原子性与一致性:
- 用
django.db.transaction.atomic包裹整个迁移批次,单次操作控制在 5000 条以内(避免长事务锁表) - 归档前先禁用相关模型的
post_save信号(否则每条都触发缓存更新或日志写入) - 目标表(如
article_archive)字段定义必须和原表完全一致,包括db_column、default、null,否则bulk_insert会静默丢字段
示例关键逻辑:
with transaction.atomic():
    qs = Article.objects.filter(pub_date__lt='2020-01-01').select_related('author')
    records = [ArticleArchive.from_article(a) for a in qs.iterator(chunk_size=2000)]
    ArticleArchive.objects.bulk_create(records, batch_size=1000)
    qs.delete()  # 真删除,非软删
定时脚本别依赖 Django shell 或 manage.py runscript
用 manage.py runscript 跑归档,一旦脚本卡住或被 kill,没有 checkpoint 机制,下次得重头来;用 shell 交互式执行更不可控。正确做法是写独立 Python 脚本,通过系统 cron 或 APScheduler 触发,并自带断点续传:
- 每次运行前查
ArchiveLog.objects.filter(status='done').order_by('-end_time').first(),取上次归档截止时间作为本次起点 - 把当前批次的
min_id和max_id记进ArchiveLog表,失败时可精准重试 - 脚本开头加
os.environ.setdefault('DJANGO_SETTINGS_MODULE', 'myproject.settings'),确保能加载 settings 和数据库路由
别把脚本放在 management/commands/ 下假装是命令——它需要稳定运行数小时,而 Django 命令默认无超时保护、无日志轮转、无资源隔离。
数据库路由配置要区分「读」和「写」两个维度
只靠 db_for_read 把历史查询导到从库没用,因为归档后的热查询(如后台搜索)仍会命中主库。必须配合模型层面的路由控制:
- 在
settings.DATABASES中为归档库单独配一个 alias,比如'archive' - 定义路由类,对
ArticleArchive模型强制所有读写走archive,但对Article模型的get_queryset方法做条件判断:if pub_date < timezone.now() - timedelta(days=730): return using('archive') - 注意
select_related和prefetch_related会忽略路由——跨库关联必须手动拆解,比如先查ArticleArchive,再用author_id单独查主库User
路由不是开关,是细粒度的流量染色。没做写的分离,归档库就只是个备份盘;没做读的动态判定,冷数据查询照样压垮主库连接池。
最常被忽略的是外键引用完整性:归档后,Comment.article_id 仍指向主库 Article.id,但对应记录已不存在。要么改外键为 IntegerField 并加业务层校验,要么用视图做跨库联合查询——后者在 PostgreSQL 里可用 postgres_fdw,MySQL 则基本只能妥协为应用层双查。
遇到Git合并冲突别慌张,本文详解冲突产生的原因及标准处理流程,涵盖查看冲突文件、理解标记含义、手动修改代码及完成合并提交的完整步骤,助你高效解决协作开发中的代码冲突问题。
深入对比Java中获取当前时间戳的两种主流方式:System.currentTimeMillis与java.time.Instant。分析二者的精度差异、API设计、时钟回拨影响与实际选型建议。
针对大数据工程场景,系统对比Java、Scala与Python在执行性能、生态结合、开发效率和维护成本上的核心差异,给出清晰的架构选型依据与落地方案。
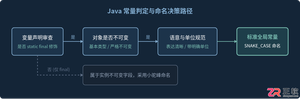
深入解析Java常量命名标准、大写下划线语义规则,剖析接口常量反模式的危害与本质原因,并提供枚举、不可实例化常量工具类等工业级最佳替代方案。
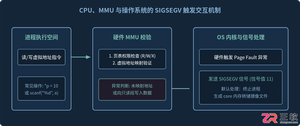
针对C语言常见的段错误(Segmentation fault)问题,详细剖析内存非法访问根因,提供结合GDB、Core Dump与AddressSanitizer的标准化排查解决步骤与预防方法。
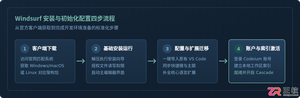
本文提供全面的Windsurf开发工具安装与使用详细教程,覆盖客户端下载安装、环境配置与VS Code插件迁移、Cascade核心协作中枢使用技巧、Chat与Write双模式实战及高效开发规范。

全面盘点Flutter主流状态管理框架,深度解析Provider、Riverpod、Bloc与GetX的核心机制、优缺点及适用场景,提供系统化的状态管理选型指南。
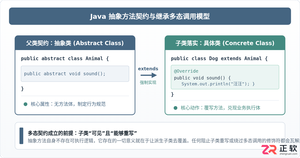
深入剖析Java中抽象方法为何严禁使用private和static修饰符。从面向对象契约规范、方法继承重写、JVM动态绑定(invokevirtual)与静态解析(invokestatic)等底层机制展开详细推导,结合编译报错示例与全景对比,彻底理清修饰符限制背后的设计逻辑。
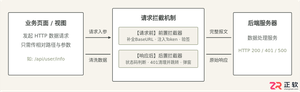
详细讲解uni-app中网络请求拦截的配置方法与实现路径,包含uni.addInterceptor原生API拦截与Promise二次封装方案、Token注入、全局错误处理及踩坑提醒。




IntelliJ IDEA 是 JetBrains 推出的专业集成开发环境,重点服务于 Java、Kotlin 与 JVM 项目开发。软件集成代码补全、静态检查、重构、调试、测试、版本控制及构建工具,并可借助插件扩展语言和框架支持。

JetBrains PyCharm 是面向 Python 开发者的集成开发环境,提供智能补全、代码检查、重构、调试、测试、版本控制及虚拟环境管理功能。Mac 版兼容 Intel 与 Apple 芯片,核心功能可免费使用。

JetBrains WebStorm 是面向 JavaScript、TypeScript 和现代 Web 技术的专业集成开发环境,可智能理解项目结构,提供代码补全、重构、错误检查、运行调试、测试及 Git 工具。

JetBrains IntelliJ IDEA 是以 Java、Kotlin 和 JVM 项目为核心的专业集成开发环境,提供智能补全、代码检查、安全重构、调试、测试、版本控制及构建工具集成。统一发行版的核心功能可免费用于商业和非商业项目,

PhpStorm 是 JetBrains 面向 PHP 与现代 Web 开发打造的专业集成开发环境,提供代码补全、静态检查、重构、调试、测试、数据库、版本控制及前端语言支持。Windows 用户可直接下载安装程序,

PyCharm 是 JetBrains 推出的 Python 集成开发环境,提供智能代码补全、错误检查、重构、调试、测试、Git、终端及 Jupyter Notebook 支持。统一版安装后可体验 30 天 Pro 功能,


