

PySpark读取多CSV并按列名合并方法
本文介绍如何在保证正确性(按列名对齐而非列序)的前提下,显著提升PySpark批量读取异构CSV文件的性能,避免逐文件读取的高开销,通过“分组统一读取+智能schema归类”实现接近单次加载的速度与语义正确的unionByName效果。

本文介绍如何在保证正确性(按列名对齐而非列序)的前提下,显著提升 PySpark 批量读取异构 CSV 文件的性能,避免逐文件读取的高开销,通过“分组统一读取 + 智能 schema 归类”实现接近单次加载的速度与语义正确的 unionByName 效果。
本文介绍如何在保证正确性(按列名对齐而非列序)的前提下,显著提升 PySpark 批量读取异构 CSV 文件的性能,避免逐文件读取的高开销,通过“分组统一读取 + 智能 schema 归类”实现接近单次加载的速度与语义正确的 unionByName 效果。
PySpark 原生的通配符路径读取(如 /*.csv)虽快,但其底层按列位置(index)对齐,无法处理各 CSV 文件列顺序不同、列集不全等常见异构场景——正如示例中 2.csv 缺失列 B 且 C 位于第二列,直接合并会导致数据错位(8 被错误填入 B 列)。而逐文件读取 + unionByName(allowMissingColumns=True) 虽语义正确,却因多次 Spark 作业调度、重复解析开销,性能下降明显(100 文件从 6s 延至 16s)。
真正的高效解法在于减少读取次数 + 保留列名语义,核心思路是:先轻量获取所有文件的 header(首行),按 schema 结构聚类;再对每组结构一致的文件批量读取,最后组间 unionByName。
✅ 推荐优化方案(两阶段高性能流程)
第一阶段:Schema 分组(纯 Python,极快)
无需 Spark,仅用轻量 I/O 获取每个 CSV 的列名列表,并哈希归类:
from collections import defaultdict
import os

def get_csv_headers(file_path):
    """安全读取 CSV 首行(跳过空行/BOM),返回列名元组"""
    with open(file_path, 'r', encoding='utf-8') as f:
        for line in f:
            if line.strip():
                return tuple(col.strip() for col in line.strip().split(','))
    return tuple()

# 示例:本地目录分组(HDFS/S3 需替换为对应 SDK,如 boto3 或 Hadoop FS)
base_dir = "/path/to/csv/folder"
schema_groups = defaultdict(list)

for fname in os.listdir(base_dir):
    if fname.endswith(".csv"):
        full_path = os.path.join(base_dir, fname)
        try:
            header = get_csv_headers(full_path)
            schema_groups[header].append(full_path)
        except Exception as e:
            print(f"Skip {fname}: {e}")

# 输出分组结果(例如):
# {('A','B','C'): ['1.csv'], ('A','C'): ['2.csv', '3.csv']}
⚠️ 注意:若文件在 HDFS 或 S3,需改用 hdfs.client.Client 或 boto3.S3Client.get_object() 流式读取前几 KB 获取首行,避免下载全量文件。
第二阶段:分组批量读取 + 合并
对每个 schema 组使用通配符一次性读取(保留高效性),再跨组 unionByName:
from pyspark.sql import DataFrame

dfs_by_schema = []
for schema, paths in schema_groups.items():
    # 构造路径字符串(Spark 支持逗号分隔多路径)
    path_list = ",".join(paths)
    df = spark.read.format("csv") \
        .option("header", "true") \
        .option("inferSchema", "false") \  # 关闭推断,提速且确保列序与 header 严格一致
        .load(path_list)
    dfs_by_schema.append(df)

# 按 schema 复杂度排序(可选:让宽表优先,减少中间 shuffle)
dfs_by_schema.sort(key=lambda df: len(df.columns), reverse=True)

# 逐组 unionByName(自动对齐列名,缺失列补 null)
result_df = dfs_by_schema[0]
for df in dfs_by_schema[1:]:
    result_df = result_df.unionByName(df, allowMissingColumns=True)
✅ 性能对比与关键优势
| 方法 | 读取次数 | Schema 对齐 | 100 文件耗时(估算) | 适用场景 |
|---|---|---|---|---|
| /*.csv 单次读取 | 1 | ❌ 按列序 | ~6s | 列结构完全一致 |
| 逐文件 unionByName | 100 | ✅ 按列名 | ~16s | 小批量、列差异大 |
| 分组批量读取 | N(N=分组数,通常 ≪100) | ✅ 按列名 | ~7–9s | ✅ 推荐:平衡速度与正确性 |
- 为什么更快?
- 减少 Spark 任务启动开销(从 100 次降至 2–5 次);
- 每组内利用 Spark 原生 CSV 批处理优化(向量化解析、内存复用);
- inferSchema=False 避免重复类型推断,进一步提速。
? 补充建议
- 动态列处理:若列名存在大小写/空格差异,预处理 header 时统一标准化(如 col.lower().strip())。
- 元数据缓存:将 schema_groups 结果持久化(如 JSON 文件),后续增量更新只需比对新增文件。
- 云存储适配:S3 上使用 s3a://bucket/path/*.csv 通配符本身支持,但 header 探测需 boto3;HDFS 可用 hadoop fs -cat 管道流式提取。
该方案在保持 unionByName 语义严谨性的前提下,逼近原生通配符读取的性能边界,是生产环境中处理异构 CSV 批量加载的最佳实践路径。

遇到PHP递归报错时,不要盲目调大max_nesting_level。本文教你区分Xdebug限制、内存耗尽和正则递归错误,提供代码级的终止条件优化与迭代替代方案,彻底解决栈溢出问题。

本文分析PHP递归中static变量导致的状态污染及引用传递引发的共享数据修改问题。提供具体的代码复现、缓存键设计建议及调试打印技巧,帮助开发者避免隐蔽的逻辑错误。

解析PHP递归函数在树形数据处理中的性能瓶颈,提供预加载数据消除I/O、使用显式栈替代深层递归的实战方案,帮助开发者在代码可读性与执行效率间做出合理取舍。
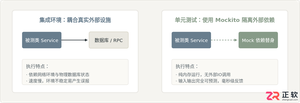
详细讲解在Java单元测试中如何使用Mockito模拟依赖对象,包括引入依赖、创建Mock、打桩返回值、行为验证以及Mock与Spy的核心差异和常见陷阱排查。
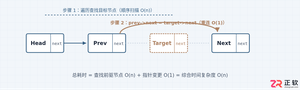
详细分析链表删除节点的时间复杂度,深入探讨单链表与双向链表在不同已知前提下的查找与删除开销,并结合完整代码与清晰图解进行对比总结。
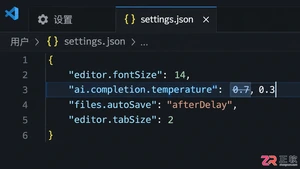
想知道如何让AI写出的代码更贴合你的习惯?本文手把手教你在VS Code中调整Codex相关模型参数,通过修改配置文件优化温度值和令牌限制,解决代码建议不准确或响应慢的问题。
通过实测展示Claude Code在终端中如何理解自然语言指令、自动修改代码文件并处理复杂编程任务,帮助开发者评估其实际辅助能力。
本教程详细讲解如何使用Visual Studio创建WinForms项目,通过添加按钮和标签控件并编写点击事件代码,实现一个基础的计数器功能,适合C#初学者快速上手Windows窗体应用开发。
详解Cursor编辑器中自动补全功能的开启与优化设置,涵盖Tab触发机制、上下文窗口调整及模型切换,帮助开发者解决补全延迟、干扰大等问题,提升编码流畅度。
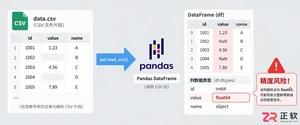
详解Pandas中数据格式转换的核心方法,包括astype强制转换、to_numeric容错处理及日期解析技巧,解决常见类型错误并提升数据处理效率。




Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。

Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。


Photoshop 2026 是 Adobe 推出的专业图像处理与视觉设计软件,支持 Windows、macOS 和 iPad 等平台,广泛应用于摄影修图、电商设计、平面海报、数字绘画及视觉合成等创作场景。
Blender 是一款免费开源、跨平台的专业 3D 创作软件,集建模、动画、渲染、视频编辑与视觉合成等功能于一体,广泛应用于影视动画、游戏设计和建筑可视化等领域。软件支持 Cycles 物理渲染器与 Eevee 实时渲染引擎,并提供多边形建模、骨骼绑定、物理模拟等专业工具。Blender 兼容 Windows、macOS 和 Linux 系统,安装包轻巧、运行流畅,依托活跃的全球开发者社区持续更新,是从初学者到专业创作者都值得选择的正版 3D 创作工具。