

如何配置Filebeat处理大量日志
高吞吐场景下的 Filebeat 配置与调优 一 核心原则与架构选择 面对海量日志,如何让Filebeat既反赌又站得稳?关键在于遵循几个核心设计原则。 输入选型要新:优先采用Filebeat 7.0+版本引入的 filestream 输入类型。相较于传统的 log 输入,它在处理效率、稳定性和资源
高吞吐场景下的 Filebeat 配置与调优
一 核心原则与架构选择
面对海量日志,如何让Filebeat既反赌又站得稳?关键在于遵循几个核心设计原则。
- 输入选型要新:优先采用Filebeat 7.0+版本引入的
filestream输入类型。相较于传统的log输入,它在处理效率、稳定性和资源控制方面都有显著提升。 - 职责边界要清:尽量让采集端“轻装上阵”。复杂的日志解析、字段提取等工作,最好下沉到Logstash、Elasticsearch Ingest Pipeline或下游处理链路中。这样做能有效降低Filebeat自身的CPU消耗和处理延迟。
- 流量控制要有:务必开启背压感知与限流能力。Filebeat在与Logstash或Elasticsearch通信时具备反压机制,能在下游高负载时自动降低发送速率,这是避免内存溢出和数据丢失的重要安全阀。
- 扩展能力要足:在超大规模或多租户环境下,单点能力总有上限。可以考虑部署多实例,通过物理机、容器或K8s,按日志目录或业务线进行负载分摊。如果流量波动剧烈,引入Kafka或Redis作为缓冲层来削峰填谷,是一个值得考虑的架构选择。
二 关键配置示例与说明
理论说完了,来看点实际的。下面是一份针对高吞吐场景优化的 filebeat.yml 配置示例,关键参数都已标注。
# filebeat.yml 高吞吐示例(按实际环境调整数值)
filebeat.inputs:
- type: filestream # 7.0+ 推荐
  enabled: true
  paths:
    - /var/log/**/*.log
  ignore_older: 72h # 忽略过旧文件,减少扫描与状态规模
  scan_frequency: 15s # 降低扫描频率,减少 CPU 与 I/O
  close_inactive: 5m # 不活跃文件及时关闭句柄,释放 fd
  harvester_limit: 1000 # 并发 harvester 上限(按内存与 fd 评估)

  # 多行日志示例(Ja va 堆栈)
  multiline.pattern: '^\['
  multiline.negate: true
  multiline.match: after
  multiline.max_lines: 10000

  # 可选:按条件减少事件量
  # include_lines: ['ERROR', 'WARN']
  # exclude_lines: ['DEBUG']

# 减少采集端处理,尽量后置解析
processors:
- add_host_metadata: ~
- add_cloud_metadata: ~
  # 如确需轻量处理再启用,避免复杂 grok
  # - dissect:
  # tokenizer: "%{ts} %{level} %{msg}"
  # target_prefix: ""

# 队列与可靠性(持久化队列)
queue:
  type: persisted
  max_bytes: 1GB
  flush.min_events: 2048
  flush.timeout: 1s

# 输出到 Logstash(推荐在 Logstash 做解析与路由)
output.logstash:
  hosts: ["logstash-0.example.com:5044", "logstash-1.example.com:5044"]
  loadbalance: true
  bulk_max_size: 2048
  compression_level: 3
  worker: 4 # 输出并发(按下游承受能力调整)

# 输出到 Elasticsearch(直连时)
# output.elasticsearch:
# hosts: ["es-0.example.com:9200", "es-1.example.com:9200"]
# bulk_max_size: 2048
# compression: true
# worker: 4

# 监控与自检
monitoring:
  enabled: true
  elasticsearch:
    hosts: ["monitoring-es.example.com:9200"]
    index: "filebeat-monitoring-%{[agent.version]}-%{+yyyy.MM.dd}"

# 注册表(状态文件)调优
path.data: /var/lib/filebeat
filebeat.registry.flush: 1s
这些参数可不是随便填的,每个都关乎性能和稳定性:
- 资源管控三剑客:
ignore_older、scan_frequency、close_inactive。它们共同决定了Filebeat需要监控的文件集合规模以及持有的文件句柄数量,直接影响到内存和文件描述符的占用。 - 并发天花板:
harvester_limit设置了并发读取文件的上限,是防止系统资源被“吃干榨净”的关键防线。 - 数据安全垫:
queue.type: persisted配合max_bytes和flush参数,启用了持久化队列。这不仅能应对进程突然宕机,避免数据丢失,还能缓冲突发流量,让系统更有韧性。 - 输出效率优化:
bulk_max_size、worker、compression这几个参数联手,旨在提升批量发送效率,降低网络带宽消耗。 - 负载均衡:通过
loadbalance和配置多个输出worker,可以将压力均匀分摊到Logstash集群或多个ES节点上,避免单点过载。
三 运行环境与资源调优
配置再好,也离不开运行环境的支撑。这方面有几个常见的优化点:
- 系统层面:
- 务必调高进程可用的文件描述符上限(例如通过systemd的
LimitNOFILE配置),否则“too many open files”这个错误迟早会找上门。 harvester_limit和worker的数量需要结合服务器的实际内存和网络带宽,通过压测来评估确定,并非越大越好。
- 务必调高进程可用的文件描述符上限(例如通过systemd的
- 容器化部署:
- 在Kubernetes环境中,可以考虑根据日志目录或业务标签,部署多个Filebeat实例,避免单个实例负载过重。
- 一定要将
registry和data目录进行持久化挂载(Volume)。这能确保实例重启后可以快速恢复进度,不会重复发送或丢失数据。
- 网络与中间件:
- 面对极高并发或跨机房场景,建议通过Logstash或Kafka进行日志的汇聚和缓冲。这相当于在采集端和存储端之间加了一个“蓄水池”,能有效降低对下游存储系统的直接冲击。
- 启用压缩(
compression_level: 3)可以显著减少网络带宽占用。同时,也需要关注网络层面的丢包和重传情况,它们可能成为隐藏的性能瓶颈。
四 监控、验证与渐进式调优
配置上线并非终点,持续的观察和调优才是保证长期稳定的秘诀。
- 监控与告警:
- 开启Filebeat的自监控功能,在Kibana中密切关注几个核心指标:每秒发布事件数、已确认事件数、关闭的harvester数、注册表大小、CPU/内存使用率以及输出错误数。
- 光看Filebeat自身还不够,必须结合后端(Logstash/ES)的监控数据,关注其处理队列长度、被拒绝的事件数以及批量请求拒绝情况,才能形成完整的视图。
- 验证与压测:
- 使用esrally、日志生成工具,或者复制生产环境的影子流量进行压测。逐步调整
bulk_max_size、worker、harvester_limit等参数,观察系统延迟和错误率的拐点,找到最佳平衡。 - 验证
ignore_older、close_inactive等参数是否按预期生效,确认注册表文件的大小和系统文件句柄的占用处于健康范围。
- 使用esrally、日志生成工具,或者复制生产环境的影子流量进行压测。逐步调整
- 渐进式调优路径:
- 求稳:首先确保基础采集链路稳定可靠,数据不丢不重。
- 提速:在此基础上,优化批量发送和并发参数,提升吞吐量。
- 减负:将复杂的解析逻辑后移,让Filebeat更专注于高效采集。
- 扩展:最终通过引入缓冲层、部署多实例来应对规模的增长。
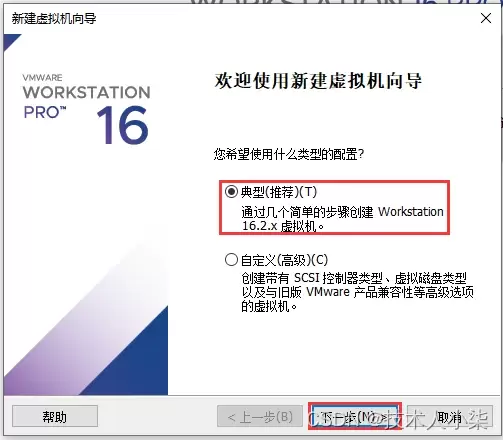
本文详细讲解如何在VMware Workstation中从零开始安装CentOS 7虚拟机。内容涵盖ISO镜像准备、典型配置创建、硬件参数分配(磁盘与内存)、安装器操作及首次启动后的版本与网络验证。通过规范化的步骤指引,帮助读者快速搭建稳定可用的Linux学习环境,并解决常见的启动与网络故障。
在CentOS系统上管理Python依赖库需先更新系统并安装Python3、pip及开发工具。安装方式包括pip(推荐)、yum/dnf(系统级)和conda。通过虚拟环境隔离依赖、用requirements.txt记录版本可避免冲突。卸载通过pip或yum/dnf完成。常见问题涉及权限、缺失系统依赖及版本兼容性。
在CentOS编译Java乱码时,需检查系统编码设为UTF-8,编译用-encodingUTF-8,运行设-Dfile.encoding=UTF-8,确保源文件编码一致,调整IDE编码,中文显示异常则安装中文字体。
通过升级JDK版本、启用增量编译与并行编译、优化JVM参数、利用构建工具高级特性、改进代码结构、进行系统级调优及持续监控分析,可显著提升CentOS环境下Java编译性能,减少重复编译,优化内存使用,从而缩短构建时间,提高开发效率。
在CentOS上编译Java程序时,需安装JDK并正确设置JAVA_HOME环境变量,通过命令查找安装路径并配置到~/.bashrc或/etc/profile中。同时关注编译器错误消息,修复代码语法或逻辑错误,确保Maven或Gradle等构建工具正确安装配置。
在CentOS上编译Golang程序,常见问题包括环境变量配置错误、依赖包管理混乱、glibc版本不兼容、编译器工具链缺失、代码或缓存异常、Go版本不匹配及权限不足,可通过逐一排查对应方法解决。
在CentOS上编译Golang:先安装开发工具包、wget和git;下载Go源码压缩包并解压至/usr/local;配置GOROOT和PATH环境变量(如添加至~/.bashrc),执行source生效;运行goversion验证安装成功。
在CentOS上提升Golang编译速度,可通过优化编译选项(如并行编译、去除调试信息)、将缓存目录指向SSD并定期清理,拆分代码为小包、消除循环依赖、使用vendor本地依赖,升级多核CPU、16GB以上内存和SSD,以及设置GOPROXY、采用PGO优化、升级Go版本等方式实现。
在CentOS编译Go程序时,需正确配置GOROOT、GOPATH等环境变量,使用GoModules管理依赖,注意Glibc版本兼容性,根据需求设置CGO_ENABLED=0实现静态链接,合理配置交叉编译参数,优化二进制文件大小,解决权限问题,并确保Go版本与项目要求一致。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



