

Pandas 条件驱动的循环填充:基于另一张表的动态 fillna 实战教程
本文详解如何利用 Pandas 结合条件筛选、布尔索引与 itertools.cycle,实现跨 DataFrame 的循环式 fillna——即根据主表的分组条件(如 'aa'/'bb'),从权限表中按访问能力(Accessor1/Accessor2)轮询分配人员姓名,并自动循环复用。 在数据处理
本文详解如何利用 Pandas 结合条件筛选、布尔索引与 itertools.cycle,实现跨 DataFrame 的循环式 fillna——即根据主表的分组条件(如 'aa'/'bb'),从权限表中按访问能力(Accessor1/Accessor2)轮询分配人员姓名,并自动循环复用。
在数据处理的实际场景里,你是否遇到过这样的需求:需要根据一组业务规则,为待处理的记录循环指派符合条件的资源?比如,手头有一批任务,需要根据任务类型(比如部门‘aa’或‘bb’),从一张权限表里,轮流分配拥有特定访问能力(Access1或Access2)的人员。这可不是简单的查找替换,而是带条件、跨表格、还要能循环复用的复杂逻辑。
Pandas原生的fillna()方法虽然强大,但面对这种复合需求就显得力不从心了。不过别担心,通过巧妙地组合布尔索引、分组预处理以及Python内置的迭代器工具,我们可以构建出一个既优雅又高效的解决方案。整个流程可以清晰地分为四步:数据准备、权限标准化、构建循环序列,最后是按条件映射填充。下面就来一步步拆解。
✅ 步骤 1:准备并标准化数据
万事开头先造数据。我们创建两张示例表:一张是待填充的主表(table_1),另一张是作为数据源的权限表(table_2)。为了让后续的条件筛选更高效,一个关键动作是将权限表中的‘Yes’/‘No’文本列转换为布尔类型。
import pandas as pd
import numpy as np
from itertools import cycle

# Table 1: 主表(待填充)
table_1 = pd.DataFrame({
    "ID": [1, 2, 3, 4, 5, 6, 7],
    "Condition": ['aa', 'aa', 'bb', 'bb', 'aa', 'bb', 'aa'],
    "Access1": [np.nan] * 7,
    "Access2": [np.nan] * 7
})

# Table 2: 权限表(源数据)
table_2 = pd.DataFrame({
    "Name": ['John', 'Mary', 'Bob', 'Ben', 'Peter'],
    "Condition": ['aa', 'aa', 'aa', 'bb', 'bb'],
    "Accessor1": ['Yes', 'No', 'Yes', 'Yes', 'No'],
    "Accessor2": ['No', 'Yes', 'Yes', 'Yes', 'Yes']
})

# 标准化:转为布尔,便于向量化筛选
table_2['Accessor1'] = table_2['Accessor1'] == 'Yes'
table_2['Accessor2'] = table_2['Accessor2'] == 'Yes'
这里有个小技巧:直接使用
col == 'Yes'进行向量化比较,远比用apply(lambda x: ...)来得高效,这也是Pandas推荐的写法。
✅ 步骤 2:按条件 & 权限预生成循环序列
接下来是核心设计。我们需要为每一种“条件-权限”组合,预先准备好一个可以无限循环的人员姓名序列。比如,对于条件‘aa’且拥有Accessor1权限的人,我们提取出名单,并用itertools.cycle包装成一个循环迭代器。
# 按 Condition 分组,提取可用姓名
def get_cyclic_names(df, cond_val, accessor_col):
    subset = df[(df['Condition'] == cond_val) & df[accessor_col]]
    return cycle(subset['Name'].tolist())

# 构建四个循环器(对应 aa/bb × Access1/Access2)
aa_access1_cycle = get_cyclic_names(table_2, 'aa', 'Accessor1')
aa_access2_cycle = get_cyclic_names(table_2, 'aa', 'Accessor2')
bb_access1_cycle = get_cyclic_names(table_2, 'bb', 'Accessor1')
bb_access2_cycle = get_cyclic_names(table_2, 'bb', 'Accessor2')
这样做的好处显而易见:当某个条件下的可用人员被分配一轮后,迭代器会自动从头开始,实现循环复用。例如,条件‘aa’下Access1的分配顺序会是 John → Bob → John…,完美符合“轮询”的业务要求。
✅ 步骤 3:逐行映射填充(向量化友好版)
到了填充环节,要避免使用低效的逐行循环(如for i in range(len()))。这里采用map()配合lambda函数,为每一行生成对应的填充值,语义清晰且易于扩展。
# 为 Access1 列生成填充序列
access1_fill = table_1['Condition'].map(
    lambda cond: next(aa_access1_cycle) if cond == 'aa' else next(bb_access1_cycle))

# 为 Access2 列生成填充序列
access2_fill = table_1['Condition'].map(
    lambda cond: next(aa_access2_cycle) if cond == 'aa' else next(bb_access2_cycle))

# 批量填充 NaN(仅填充空值,保留已有值)
table_1['Access1'] = table_1['Access1'].fillna(pd.Series(access1_fill))
table_1['Access2'] = table_1['Access2'].fillna(pd.Series(access2_fill))
这种方法的优势在于:
map()函数天然适用于Pandas Series,逻辑一目了然;而fillna()则确保了只替换真正的空值(NaN),不会覆盖已经存在的有效数据,安全性更高。
✅ 最终结果验证
运行上述代码后,主表table_1就被成功地填充了。最终结果如下,完全符合我们“按条件循环分配”的预期:
| ID | Condition | Access1 | Access2 |
|---|---|---|---|
| 1 | aa | John | Mary |
| 2 | aa | Bob | Bob |
| 3 | bb | Ben | Ben |
| 4 | bb | Ben | Peter |
| 5 | aa | John | Mary |
| 6 | bb | Ben | Ben |
| 7 | aa | Bob | Bob |
? 进阶建议与优化方向
掌握了基础方法后,我们还可以从几个方向思考如何让它更强大:
- 可扩展性:如果业务条件(Condition)或权限列(Access)数量增加,可以将所有循环器存储在一个嵌套字典中,例如
cycles = {'aa': {'Access1': ..., 'Access2': ...}, ...},然后配合groupby().apply()动态调用,使代码更具普适性。 - 性能优化:面对超大规模数据集时,可以考虑用
numpy.where结合预计算的索引数组来替代map函数,减少Python层的开销,提升运行速度。 - 健壮性增强:在构建循环器之前,添加断言检查,确保每个条件-权限组合下至少有一个可用人员(
len(...) > 0),避免后续调用next()时因空序列而报错。 - 纯 Pandas 替代方案? 坦白说,要完全避免Python层的迭代逻辑来实现这种确定性循环比较困难。虽然可以用
pd.concat(...).sample(frac=1)来模拟随机分配,但对于要求严格按顺序轮询(FIFO)的业务场景,本文介绍的确定性循环方案无疑是更合适的选择。
总的来说,这套方法在Pandas的数据处理生态中,为“条件化循环填充”这类问题提供了一个兼顾可读性、可维护性与执行效率的经典范式。希望这个思路能为你解决类似的数据分配难题带来启发。
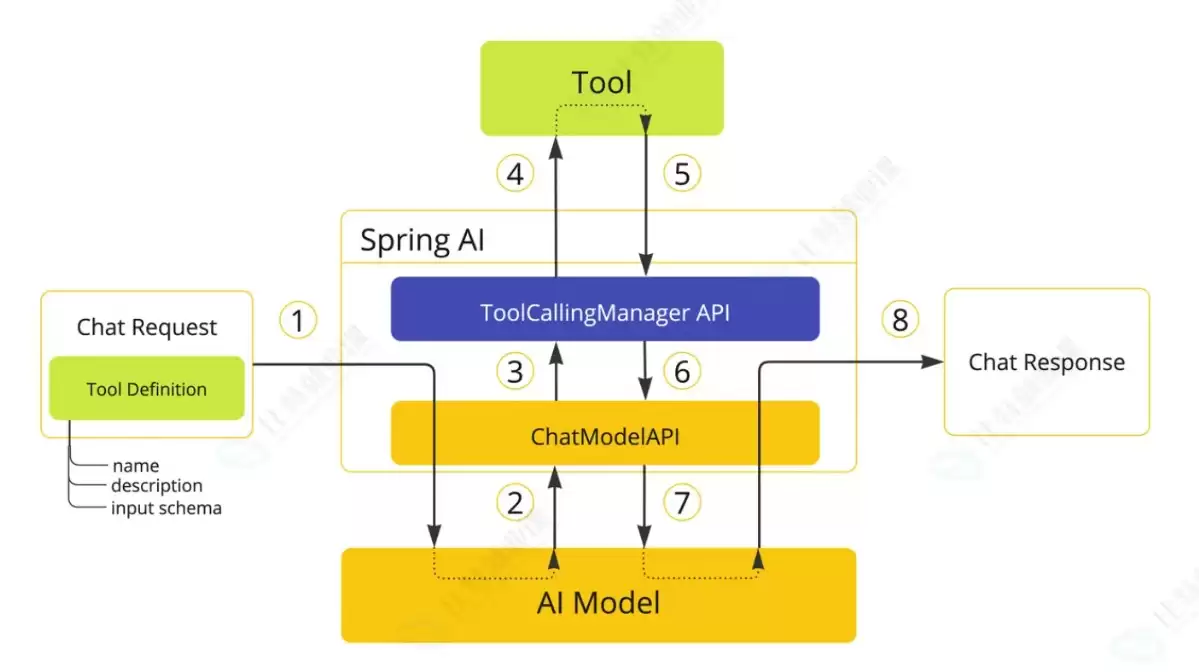
前言 简单来说,这篇教程讲的是如何让大模型在对话过程中,主动调用你写好的 Ja va 方法——比如查个时间、查个天气,完全不需要手动干预。大模型自己判断什么时候该调用哪个工具,然后把结果组织成自然语言回复给你。 版本信息 Spring Boot:3.4.5 spring-ai-alibaba-sta
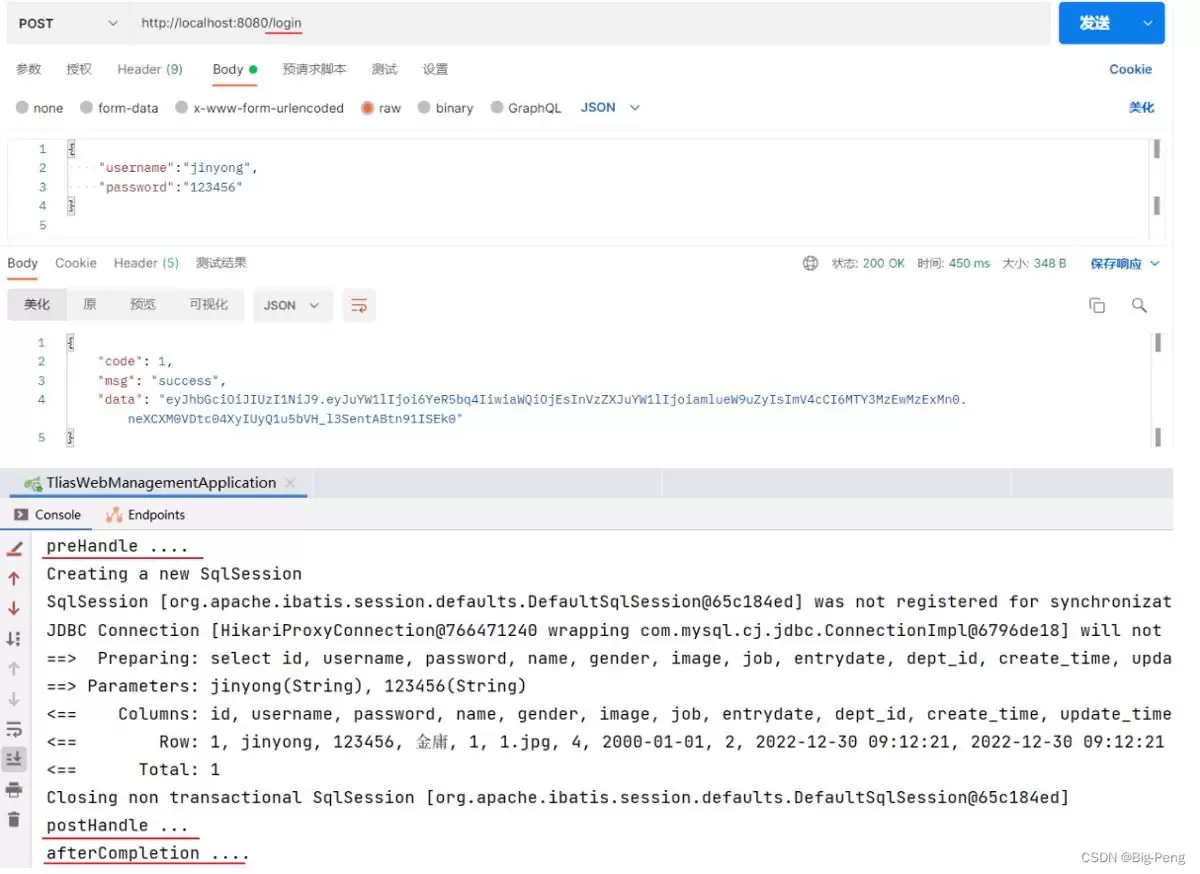
1.快速入门 拦截器是什么?简单来说,它是一种动态拦截方法调用的机制,和过滤器有点像,但它是Spring框架自带的,专门用来动态拦截控制器方法的执行。 那拦截器到底能做什么?最常见的用途就是拦截请求,在指定方法执行前后,根据业务需求插入一些预先写好的逻辑。比如登录校验——我们可以把校验逻辑全塞进拦截
语音转写技术已经不是什么新鲜事了,但真正把它用顺手、接进自己的项目里,还是得靠靠谱的API。讯飞听见的实时语音转写API就是这样一个工具,能帮开发者快速把语音转成文字,省去自己折腾底层算法的麻烦。下面直接上实战步骤,从零开始,一步步走通。 准备工作 首先,得去讯飞开放平台注册个账号,拿到API密钥—
动态数组扩容并非原地扩展,而是创建新内存后迁移数据。Java中可用System.arraycopy精确控制复制,或使用Arrays.copyOf快速扩容;C++中推荐std::copy或memmove替代手动循环。应避免使用realloc,因其存在内存泄漏风险且不兼容面向对象模型。
基于SpringBoot整合RocketMQ,通过自动装配机制完成配置加载与Bean注册,提供RocketMQTemplate实现同步、异步、单向消息发送;支持普通、广播、分区有序、延迟及批量消息,消费者通过注解实现集群或广播消费,框架内置重试与位点维护。
静态变量属于类本身,位于方法区,全局共享,适合配置参数与计数器,需注意线程安全与不参与序列化。静态方法是工具类核心载体,只能访问静态成员。静态代码块在类加载时执行一次,用于预热资源。静态内部类可独立实例化,避免内存泄漏;静态导入简化调用,慎用通配符。

在这篇文章中,我们将通过一个实战案例来学习如何利用PHP编写一个个性化的多对一通讯录功能。在这个案例中,我们将展示如何使用数据库存储联系人信息,并通过编写相应的代码实现添加、编辑、删除联系人等功能。同时,我们将介绍如何实现多对一的关系,即一个用户可以拥有多个联系人信息。环境搭建为了开始这个项目,我们需要搭建一个PHP开发环境。你可以选择使用XAMPP、WAM
在PHP编程中,常常会遇到需要交换两个变量的值的场景。通常我们会使用一个中间变量来实现交换操作,但是其实在PHP中,我们可以通过不使用中间变量来实现两个变量的互换。本文将介绍如何在PHP中实现这一功能,并给出具体的代码示例。要实现不使用中间变量直接交换两个变量的值,我们可以利用加减法或者异或运算来实现。下面分别介绍两种实现方式的具体代码示例:使用加减法实现变
实战教程:使用PHP开发登录鉴权功能在现代化的网络应用中,登录鉴权功能是非常重要的一部分。它能够保护用户的隐私和数据安全,确保只有合法的用户可以访问特定的功能和资源。本文将介绍如何使用PHP开发一个简单而强大的登录鉴权功能。第一步:创建数据库和用户表首先,我们需要创建一个数据库,并创建一个用户表来存储用户的登录信息。可以使用MySQL数据库来完成
解决Visual Studio 2017离线安装包签名验证失败的问题。指南涵盖如何从联网设备获取并导入受信任根证书,如何处理离线布局中的Certificates文件夹,以及如何利用事件查看器中的CAPI2日志进行深度故障排查,确保离线环境下的顺利安装。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



