

PHP怎么处理Gearman分布式任务_PHP作业队列系统集成【方法】
PHP集成Gearman:从“能跑”到“跑得稳”的四个关键细节 在分布式任务处理的世界里,GEARMAN_SUCCESS 这个返回值,常常给人一种安全的错觉。它只告诉你任务“提交成功”,至于后续是顺利执行、卡在半路,还是无声无息地消失,它一概不管。说白了,PHP集成Gearman的核心挑战,从来不是
PHP集成Gearman:从“能跑”到“跑得稳”的四个关键细节
在分布式任务处理的世界里,GEARMAN_SUCCESS 这个返回值,常常给人一种安全的错觉。它只告诉你任务“提交成功”,至于后续是顺利执行、卡在半路,还是无声无息地消失,它一概不管。说白了,PHP集成Gearman的核心挑战,从来不是“把任务发出去”,而是如何构建一个“发得稳、接得住、查得清、容得错”的健壮系统。下面,我们就来拆解其中几个最容易踩坑的环节。
如何确保GearmanClient连上gearmand并真正可用
第一个常见的误解,就发生在连接阶段。很多开发者看到 $client->addServer() 返回 true,就以为万事大吉。其实,这个方法只是把服务器地址加入客户端的候选列表,并没有触发真正的网络连接探测。
那么,怎么确认连接真的通了?答案是主动“探针”。要么调用 $client->ping() 发送一个心跳包,要么发起一次轻量级的测试任务(比如 $client->doNormal('echo', 'test')),用实际的网络交互来验证。
这里有几个实操建议,能帮你避开不少暗礁:
- 地址要显式,别偷懒:始终明确指定 host 和 port,写成
$client->addServer('127.0.0.1', 4730)。依赖默认值,在复杂的部署环境中就是给自己埋雷。 - 启动前先“体检”:在客户端初始化后,不妨加一层健康检查。例如:
if (!$client->ping('gearman_health_check')) { throw new RuntimeException('Gearman server unreachable at 127.0.0.1:4730'); } - 谨慎对待客户端实例:不要为了图省事,在全局复用同一个
Client实例。一次请求中的超时或断连状态,可能会污染后续的所有调用。更稳妥的做法是每次请求新建实例,或者使用经过验证的连接池来管理。 - 注意服务端配置:别忘了,
gearmand默认只监听本地回环地址127.0.0.1。如果你的应用需要跨机器部署,启动服务端时必须加上-h 0.0.0.0参数,并确保防火墙开放了相应端口。
addTask与doBackground的关键区别和选型依据
这是两个容易混淆的提交方法,用错了场景,效果可能南辕北辙。
addTask 是设计用来批量、并行提交任务的。但请注意,它只是一个“计划”入口,必须配合后续的 $client->runTasks() 调用,任务才会被真正发送出去。而 doBackground 则是单次、异步提交的利器,调用后立即返回一个唯一的 job handle,进程不会阻塞等待结果。
实际开发中,下面这几个坑屡见不鲜:
- 用了
addTask却忘了调用runTasks(),导致任务静静地躺在内存里,根本没发出去,而且没有任何错误提示。 - 调用
doBackground后,随手丢弃了返回的 job handle。这下好了,任务如同断线的风筝,后续想查询状态、监控积压、或是实现重试机制,都无从下手。 - 误以为
doBackground是“一发了之”。其实,它仍然可能在网络层或服务端被拒绝,所以必须检查$client->returnCode() === GEARMAN_SUCCESS来确认提交成功。 - 在高并发场景下,毫无节制地调用
doBackground,可能会瞬间压垮gearmand的内存队列(默认配置下任务不持久化),直接导致任务丢失。
立即学习“PHP免费学习笔记(深入)”;
Worker端注册function name时的隐性约束
Function name(函数名)在Gearman里,远不止一个字符串那么简单。它本质上是Worker向世界宣告的“我能做什么”的能力标识。多个Worker可以注册同名的function,gearmand 会自动进行负载均衡。
但这里有个极其关键的“静默失败”陷阱:如果Client提交了一个没有任何Worker注册的function name,这个任务会被 gearmand 直接丢弃,既不会报错,也不会留下任何失败日志。
所以,必须建立严格的规范:
- 保持两端一致:所有function name必须在Client和Worker两端严格保持一致。最佳实践是将它们提取为常量或统一的配置项,彻底杜绝硬编码带来的不一致风险。
- Worker启动要“自报家门”:Worker启动时,应该主动记录日志,明确列出自己注册了哪些function,例如:
echo "Registered: resize_image, send_sms, generate_pdf\n";。这为运维排查提供了第一手信息。 - 上线前先确认:在部署新的任务类型前,先通过
gearadmin --status命令,确认至少有一个Worker已经就绪并注册了该function。 - 命名要规范:function name中应避免使用空格、斜杠、控制字符等。只使用字母、数字和下划线是最安全的选择,某些版本的
gearmand对特殊字符的处理可能不一致,导致静默截断或注册失败。
怎么查一个background job是否执行完成或失败
对于异步的background job,没有同步返回值可供判断。唯一官方的状态查询途径,是轮询 $client->jobStatus($handle) 方法。它会返回一个包含四个字段的数组:is_known、is_running、numerator、denominator。
解读这几个状态字段,需要一点技巧:
is_known === false:这是一个危险信号。它意味着gearmand已经不认识这个job handle了。通常是因为任务已超过默认的24小时留存期被清理,或者handle本身就不正确。is_running === false && is_known === true:这表示任务已经结束运行。但是,请注意,这并不等同于任务成功!它只代表Worker进程结束了处理。任务在业务逻辑层是成功还是失败,取决于Worker是正常return还是抛出了异常,而这部分信息,Client端是无法直接通过Gearman协议获取的。
正因为如此,在要求可靠性的生产环境中,更务实的方案是引入外部存储:让Worker在任务处理完成后,无论成败,都将结果(或错误信息)写入Redis或数据库,并以原job handle作为查询键。Client端不再仅仅依赖 jobStatus,而是用这个handle去外部存储查询最终状态。这才是构建可追踪任务链的关键。
最后,别忘了控制查询频率。用 jobStatus 进行过于频繁的轮询(比如每100毫秒一次),会给 gearmand 带来不必要的负担。合理的查询间隔至少应在500毫秒以上,并且一定要为整个查询过程设置一个总超时时间(例如5分钟),避免无限等待。
说到底,Gearman的简单性封装在它清晰的协议里,但它的脆弱性也恰恰隐藏在诸多细节之中:没有自动重试机制,没有内置的持久化保障,也没有中心化的任务追踪界面。所有这些关乎健壮性的部分,都需要开发者在 Client 和 Worker 两端亲手补齐——尤其是对job handle生命周期的精细管理、对function name一致性的严格校验,以及任务失败后状态的外部化落库。把这些细节做到位,你的异步任务系统才能真正扛得住压力。
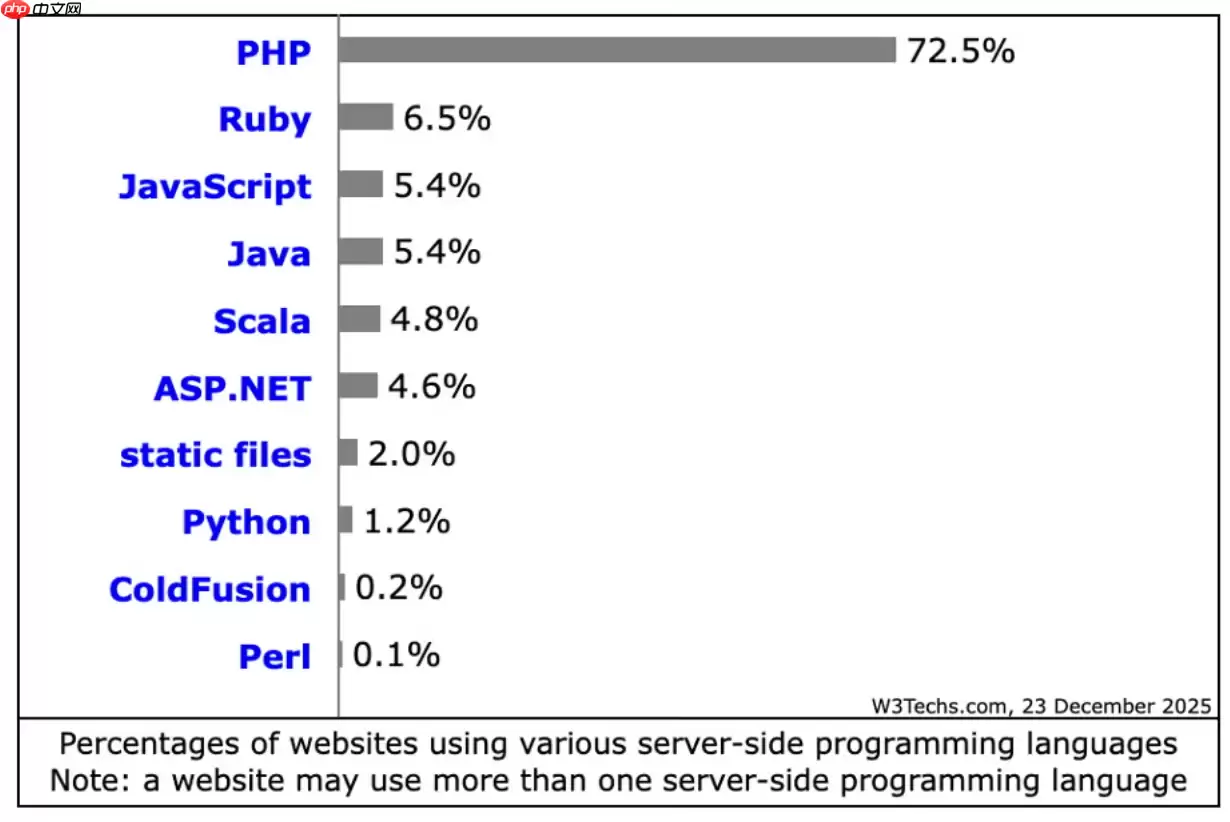
PHP在2026年仍适用于现代网站构建,在常规Web服务和内容密集型站点中较Python、Java等保持优势。其JIT编译优化性能,安全补丁及时,全面支持云原生,拥有成熟框架生态,整体成本较低。
在Debian系统上为PHP配置SSL加密,通常涉及以下几个步骤:安装SSL证书:首先,你需要一个SSL证书。你可以从Let’s Encrypt免费获取,或者购买一个商业证书。使用Let’s Encrypt:sudo apt updatesudo apt install certbotsudo ce
在Linux服务器上,若要使用ThinkPHP框架进行备份,一般会涉及到以下这些方面:数据库备份:使用mysqldump或mysql命令行工具来备份数据库。示例命令:mysqldump -u username -p database_name > backup_database.sql这将生成一个S
在Linux服务器上查看PHP错误日志的方法如下:首先,得找到PHP错误日志文件所在的位置。一般来说,它会在/var/log/php或者/var/log/apache2目录下。当然啦,你也可以通过下面这个命令来找到它:php --ini在输出的信息中,找到"ErrorLog"一行,它会显示错误日志文
在Linux系统下配置PHP以支持SSL,通常需要以下几个步骤:1. 安装PHP和SSL模块首先,确保你已经安装了PHP以及相关的SSL模块。你可以使用包管理器来安装这些软件包。在Debian/Ubuntu上:sudo apt updatesudo apt install php php-ssl在C
在Linux下配置PHP连接MySQL,你需要确保已经安装了PHP和MySQL,并且它们都在运行。接下来,请按照以下步骤操作:安装PHP MySQL扩展:对于PHP 7.x,你需要安装php-mysql扩展。在终端中运行以下命令:sudo apt-get updatesudo apt-get ins
想要通过配置PHP-FPM(FastCGI进程管理器)来加快网站响应速度,需要从多个方面入手,比如调整进程管理参数、优化PHP代码、启用OPcache等等。下面就为大家详细介绍一些关键步骤和实用建议。1. 调整PHP-FPM进程管理参数1.1 增加进程数根据服务器的CPU和内存资源,适当增加PHP-
手把手教你在Linux服务器上配置PHP一 安装与基础检查更新索引并安装所需组件(以 Ubuntu/Debian 为例):安装 Web 与 PHP:sudo apt update && sudo apt install nginx php-fpm php-mysql php-cli php-gd p
Veitool后台框架ThinkPHP版v2.3.5发布,核心升级至ThinkPHP8.1.4,性能与兼容性提升。集成JWT认证,自动生成令牌及RSA密钥对;新增可选RSA加密传输,增强数据安全;fileLibrary增加复制所选文件链接功能。
介绍 LabEx在线PHP演练场,为用户打造了一个完备的在线PHP环境。在这里,用户无需在本地进行任何配置,就能畅享完整的PHP开发体验。这是一个功能多样的平台,无论是Web开发者、系统管理员,还是学生群体,它都能满足需求,为大家探索和实验PHP及Web技术,提供了绝佳的空间。 使用 LabEx 在






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
