

TensorFlow 3 中 Autoencoder 构建常见错误及修复指南
TensorFlow 3 中 Autoencoder 构建常见错误及修复指南 本文详解在 TensorFlow 3(Keras 3)中构建自编码器时因 tf.math.reduce_prod 返回张量而非标量导致的 Invalid dtype 错误,并提供兼容 Keras 3 的完整可运行解决方案。
TensorFlow 3 中 Autoencoder 构建常见错误及修复指南
本文详解在 TensorFlow 3(Keras 3)中构建自编码器时因 tf.math.reduce_prod 返回张量而非标量导致的 Invalid dtype 错误,并提供兼容 Keras 3 的完整可运行解决方案。
升级到 TensorFlow 3(也就是默认采用 Keras 3 作为高阶 API)后,很多开发者会发现,以前跑得通的自编码器代码突然报错了。一个典型的“坑”就藏在构建全连接层时,对输入形状的计算里。具体来说,如果你习惯性地将 tf.math.reduce_prod(shape) 或 keras.ops.prod(shape) 的返回值直接传给 Dense 层的 units 参数,那么大概率会遭遇一个令人困惑的异常:
ValueError: Exception encountered when calling Autoencoder.call().Invalid dtype:
表面上看,错误信息指向了数据类型(dtype)问题,但问题的根源其实更隐蔽。这本质上是因为,上述计算函数返回的是一个标量张量(比如 units 必须是一个纯粹的 Python 整数(int)。当框架试图处理这个张量对象时,就会产生类型混淆,从而抛出那个看似关于 dtype 的报错。
✅ 正确做法:显式提取标量值
那么,正确的做法是什么?关键在于必须将这个张量显式地转换为 Python 原生整数。在 Keras 3 的语境下,更推荐使用 .item() 方法,因为它具有更好的跨后端兼容性。相比之下,依赖 .numpy() 的方法在非 TensorFlow 后端(如 JAX 或 PyTorch)下可能会失效。
下面是一个完整、可运行的解决方案,它修复了上述错误,并遵循了 Keras 3 的最佳实践:
import tensorflow as tf
import keras
from keras import layers, losses, models
from tensorflow.keras.datasets import fashion_mnist

# 数据预处理
(x_train, _), (x_test, _) = fashion_mnist.load_data()
x_train = x_train.astype('float32') / 255.0
x_test = x_test.astype('float32') / 255.0

# 输入形状(排除 batch 维度)
shape = x_test.shape[1:]  # e.g., (28, 28)
latent_dim = 64

class Autoencoder(keras.Model):
    def __init__(self, latent_dim, shape):
        super().__init__()
        self.latent_dim = latent_dim
        self.shape = shape

        # Encoder:显式声明 Input 层,确保 shape 兼容性(Keras 3 必需)
        self.encoder = keras.Sequential([
            keras.Input(shape=shape),  # ← 关键:定义输入形状,避免 batch 维度歧义
            layers.Flatten(),
            layers.Dense(latent_dim, activation='relu'),
        ])

        # Decoder:使用 .item() 安全提取 prod 结果
        flattened_size = keras.ops.prod(shape).item()  # ✅ 正确:转为 int
        self.decoder = keras.Sequential([
            layers.Dense(flattened_size, activation='sigmoid'),
            layers.Reshape(shape)
        ])

    def call(self, x):
        encoded = self.encoder(x)
        decoded = self.decoder(encoded)
        return decoded

# 实例化并训练
autoencoder = Autoencoder(latent_dim, shape)
autoencoder.compile(optimizer='adam', loss=losses.MeanSquaredError())
autoencoder.fit(
    x_train, x_train,
    epochs=10,
    batch_size=32,
    shuffle=True,
    validation_data=(x_test, x_test),
    verbose=1
)
⚠️ 注意事项与最佳实践
除了核心的修复步骤,还有几个细节值得注意,它们能帮助你的代码更加健壮,并适应 Keras 3 的新特性:
- Input 层不可省略:在 Keras 3 中,尤其是在使用 Sequential 模型且该模型需要被独立调用时,在首层明确使用
keras.Input来定义输入形状变得非常重要。这能确保模型拥有清晰的静态形状信息,避免在调用call()方法时产生意外错误。 - 避免 .numpy() 在非 TF 后端使用:为了代码的未来兼容性,应当养成使用
.item()的习惯。.numpy()方法依赖于 TensorFlow 的即时执行模式,一旦切换到 JAX 或 PyTorch 后端就会失效,而.item()则是通用的解决方案。 - 验证 shape 计算:虽然
x_test.shape[1:]通常是安全的,但在构建模型前打印确认一下总是一个好习惯。例如:print(f"Input shape: {shape}, flattened size: {keras.ops.prod(shape).item()}") # 输出:Input shape: (28, 28), flattened size: 784 - 激活函数选择:当输入数据被归一化到 [0, 1] 区间时,在解码器输出层使用 sigmoid 激活函数是合适的。如果后续考虑使用 tanh 激活函数,则需要记得将输入数据同步缩放至 [-1, 1] 区间。
✅ 总结
总的来说,这个问题的出现,反映了 Keras 3 在类型安全性上所做的强化:它不再自动、隐式地将张量转换为标量。修复起来其实非常清晰,主要就是两步:
第一,在计算展平后的大小时,用 .item() 方法安全地提取出整数,取代旧的 .numpy() 方式。
第二,在编码器的 Sequential 模型开头,显式添加 keras.Input(shape=...) 层来定义输入。
遵循这个模式,你就能既复用那些经典教程中的网络架构逻辑,又能确保代码在 Keras 3 的多后端环境下顺畅运行,兼具健壮性与前瞻性。
Reddit 用户“PresentSpecific5666”昨天发了一篇长文,对着5年前那台Pixel 6一顿猛批,最后撂下一句话:以后再也不会买谷歌的手机了。免费机子?不存在的,免费也不值得用。 先说个背景。这位老哥和妻子当年是在Sprint并入T-Mobile时,一人免费领了一台Pixel 6。
8月14日消息,谷歌已于本周正式推出年度旗舰 Pixel 11 系列,阵容一共包括 Pixel 11 标准版、Pixel 11 Pro、Pixel 11 Pro XL 以及 Pixel 11 Pro Fold 四款机型。这一代产品率先搭载谷歌自研的 Tensor G6 芯片,不过这颗芯片具体采用了怎
8 月 14 日消息,Google(谷歌)硬件副总裁彭昱钧昨日确认,本周早些时候发布的 Pixel 11 系列智能手机所搭载的 Tensor G6 芯片采用台积电最新改良 3nm 制程。这意味着此前“Tensor G6 移动端首发台积电 2nm”的传闻不实。谷歌给 Tensor G6 的定位很明确:
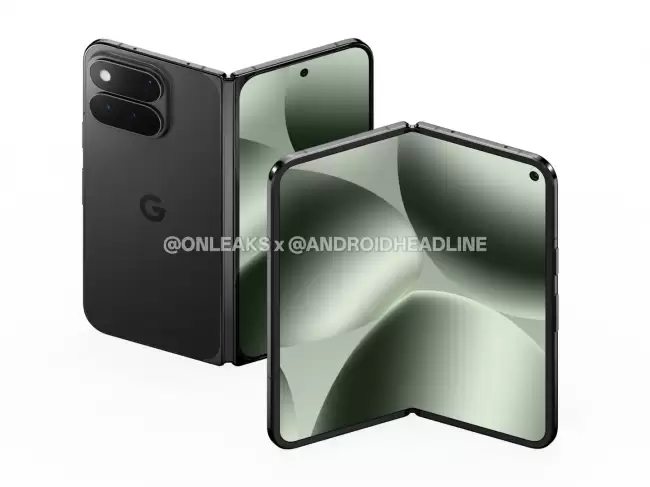
谷歌Pixel11ProFold通过FCC认证,文件出现联发科关键词,暗示TensorG6芯片或放弃三星Exynos基带,改用联发科M90基带以降低功耗,此前传闻得到证实。
台积电2nm制程量产,谷歌为首发客户,Pixel11系列8月12日发布,搭载TensorG6芯片,早于苹果约一个月。苹果A20芯片9月登场,高通、联发科也将推出2nm芯片,2nm工艺竞争全面升温。
谷歌自研Tensor芯片问世近五年,在AI任务上实现目标,但续航、温控和性能短板明显。超七成受访者认为应放弃,主要因其未兑现技术承诺,且性能不及骁龙与苹果A系列。不过,短期谷歌并未放弃,下一代TensorG6将继续搭载。
谷歌Pixel 11系列旗舰机型将于8月12日发布,这已经是板上钉钉的事。而主打中端市场的Pixel 11a,则要等到明年春季才姗姗来迟。不过,最近有知情人士提前曝光了Pixel 11a的核心配置,这应该是目前关于该机最全面的一次参数泄露了。 谷歌Pixel 11系列CAD渲染图 具体来看,Pixe
一项针对一千七百多位用户的调查结果显示,大约百分之六十九点二的受访用户认为谷歌应终止自研Tensor处理器研发项目,主要原因在于其性能、续航和发热表现均不佳,而支持继续开发的仅占百分之三十一。
在TensorFlow中,通过构造多维散列索引实现top-k原位更新:先广播索引至所有空间维度,再转为三维坐标,最后用tf.tensor_scatter_nd_update定点更新,避免拼接重排序,节省内存,支持图模式与反向传播,适用于高效稀疏梯度更新。
tf.function将函数编译为静态计算图,跳过Python解释器并融合算子以加速推理,但首次调用迹化较慢,需多次调用同一签名才有效。适合输入结构固定、shape稳定的前向推理,应使用input_signature约束shape并避免频繁变化。预热后实测吞吐和延迟,CPU提速更明显,但内存占用增加。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



