

浅析Python闭包如何捕获自由变量
一、从一个计数器开始 很多朋友在学习作用域时,都遇到过下面这段让人困惑的代码: def make_counter(): count = 0 def counter(): count += 1 # 这里会报错 return count return counter c = make_counter()
一、从一个计数器开始
很多朋友在学习作用域时,都遇到过下面这段让人困惑的代码:
def make_counter():
    count = 0
    def counter():
        count += 1   # 这里会报错
        return count
    return counter

c = make_counter()
print(c())  # UnboundLocalError: local variable 'count' referenced before assignment
这可不是什么bug——恰恰相反,这是Python作用域规则在“说话”。报错的根源就藏在count += 1这行看似简单的代码里,而理解它,几乎是理解闭包本质的必经之路。
要彻底搞懂这段代码,我们得先理清Python的作用域规则,以及闭包到底是怎么工作的。
二、LEGB 规则:名字查找的顺序
在Python的世界里,每当需要查找一个变量名时,解释器都会遵循一个固定的顺序,我们称之为LEGB法则:
- L(Local):当前函数内部定义的变量
- E(Enclosing):外层嵌套函数中的变量
- G(Global):模块级全局变量
- B(Built-in):Python内置的名字,比如
len、print
用一段代码来验证这个顺序,会非常直观:
x = "global"  # G 层

def outer():
    x = "enclosing"  # E 层

    def inner():
        x = "local"  # L 层
        print(x)  # -> local(找到了就停)

    inner()

outer()
每一层都可以定义和上层同名的变量,它们彼此独立,互不干扰。Python之所以这样设计,是因为名字查找发生在运行时,而非编译时——解释器执行到哪一行,才去对应的作用域里寻找变量。
LEGB规则可以这样可视化理解:
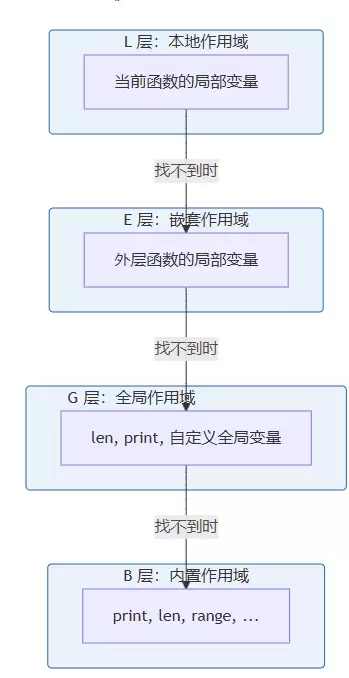
查找过程就像从圆心向外扩散,由内而外,找到即止。
三、global关键字:打破 E 层
现在回到开头那个报错的计数器。问题出在count += 1这行,它实际上等价于:
count = count + 1
Python解释器看到这行代码时,发现等号左边出现了count,就立刻判定count应该是当前作用域(L层)的局部变量。但麻烦来了:count实际上定义在make_counter()的作用域里(E层),并不在counter()的局部作用域里。Python拒绝在E层为L层创建同名变量,于是UnboundLocalError就出现了。
一个直接的解决思路是,把count提升到全局作用域:
count = 0

def make_counter():
    global count  # 声明接下来访问全局的 count
    count += 1
    return count

print(make_counter())  # 1
print(make_counter())  # 2
但global有个致命的缺陷:它让count变成了模块级的全局变量。这意味着,如果你创建多个make_counter()实例,它们将共享同一个count,计数器之间的状态隔离被完全破坏了。
四、nonlocal关键字:访问 E 层变量
nonlocal可以看作是global的近亲,但作用域完全不同。它允许在L层函数中修改E层(即嵌套外层)的变量:
def make_counter():
    count = 0

    def counter():
        nonlocal count  # 声明:接下来对 count 的赋值操作,作用于外层的 count
        count += 1
        return count

    return counter

c = make_counter()
print(c())  # 1
print(c())  # 2
print(c())  # 3
关键在于,nonlocal不会在L层创建新变量,也不涉及G层——它直接作用于最近一层外层函数的变量。
这里简单对比一下global和nonlocal:
| 关键字 | 作用层 | 行为 |
|---|---|---|
global | 模块级 G 层 | 读写全局变量,多个函数共享 |
nonlocal | 嵌套外层 E 层 | 读写外层函数变量,多个闭包独立 |
五、闭包的完整执行流程
理解了nonlocal,我们再完整地看一遍闭包的执行流程。还是最初报错的代码,但这次我们先不加任何关键字:
def make_counter():
    count = 0  # <- E 层变量

    def counter():
        print("count 当前值:", count)  # 读 E 层变量 - 没问题
        return count  # 读 E 层变量 - 没问题

    return counter
看到了吗?单纯的读操作(不加nonlocal)是不会报错的——Python允许读取外层变量。只有写操作(比如count = something或count += something)才会触发UnboundLocalError,因为等号左边让Python误以为你要创建一个新的L层变量。
当Python看到nonlocal count这行声明时,在编译期(生成字节码的阶段)就已经把这件事记录下来了:
import dis

def make_counter():
    count = 0

    def counter():
        nonlocal count
        count += 1
        return count

    return counter

# counter 函数的字节码
dis.dis(counter := make_counter())
关键字节码如下:
5 2 LOAD_GLOBAL 0 (count)
4 LOAD_CONST 1 (1)
6 BINARY_OP 0 (+)
8 STORE_FAST 0 (count)
10 LOAD_FAST 0 (count)
12 RETURN_VALUE
注意LOAD_GLOBAL 0 (count)这一行,这就是nonlocal的实现方式。如果没有nonlocal声明,这行会变成LOAD_FAST(试图读取L层变量),紧接着的STORE_FAST就会因为变量未定义而触发UnboundLocalError。
六、闭包变量的生命周期
闭包有一个容易被忽略但至关重要的特性:闭包变量的生命周期和闭包函数本身一样长。
def make_multiplier(factor):
    # factor 绑定在 make_multiplier 的局部作用域里
    def multiply(value):
        return value * factor
    return multiply

doubler = make_multiplier(2)

# make_multiplier() 已经执行完毕退出了
# 但 doubler 仍然持有 factor=2
print(doubler(5))   # 10
print(doubler(100)) # 200
factor原本是make_multiplier()的局部变量。按照常规,函数执行完毕,其局部变量就该被销毁了。但doubler还在引用它,所以Python的垃圾回收机制检测到factor仍有外部引用,就把它保留下来,并通过一个叫做cell的对象包装后,存入doubler.__closure__属性中。
这就是为什么我们能通过doubler.__closure__[0].cell_contents读取到2——cell对象就是闭包变量在内存中的载体。
>>> doubler.__closure__ (| ,) >>> doubler.__closure__[0].cell_contents 2 |
再看一个复杂点的例子,验证多个闭包如何共享同一个外层变量:
def processor(initial=0):
    total = initial

    def add(x):
        nonlocal total
        total += x
        return total

    def subtract(x):
        nonlocal total
        total -= x
        return total

    return add, subtract

add, subtract = processor(100)

print(add(30))     # 130,total = 100 + 30
print(subtract(20)) # 110,total = 130 - 20
print(add(10))     # 120,total = 110 + 10
add和subtract这两个闭包函数,指向的是同一个cell对象。因此,修改total对两个函数都生效。这种“共享状态”的特性,在事件处理器、回调函数等场景中非常有用。
七、闭包的典型应用场景
场景一:函数工厂(最常见用法)
根据不同的参数,动态生成具有特定功能的函数:
def power_factory(exp):
    def power(base):
        return base ** exp
    return power

square = power_factory(2)
cube = power_factory(3)

print(square(5))  # 25
print(cube(5))    # 125
exp这个参数被捕获在各自的闭包里,square和cube拥有独立的exp值,互不干扰。相比为每种指数都写一个专门的函数,函数工厂的方式显然更灵活、更优雅。
场景二:带记忆的递归函数
def memoized_fibonacci():
    cache = {}  # E 层变量

    def fib(n):
        if n in cache:
            return cache[n]
        if n <= 1:
            result = n
        else:
            result = fib(n-1) + fib(n-2)
        cache[n] = result
        return result

    return fib

fib = memoized_fibonacci()
print(fib(100))  # 354224848179261915075
print(fib(200))  # 280571172992510140037611908417314019
cache字典在闭包中持久化,每次递归调用都能访问同一个缓存。这巧妙地避免了普通递归中,子问题被重复计算的巨大开销。
场景三:装饰器(闭包的直接应用)
装饰器本质上就是闭包的一个经典应用:
import functools
import time

def timing_decorator(fn):
    @functools.wraps(fn)
    def wrapper(*args, **kwargs):
        # fn 和 elapsed_time 都是闭包变量
        start = time.perf_counter()
        result = fn(*args, **kwargs)
        elapsed = time.perf_counter() - start
        print(f"{fn.__name__} 耗时 {elapsed:.4f}s")
        return result
    return wrapper
wrapper函数捕获了两个自由变量:fn(被装饰的函数)和用于计时的变量。timing_decorator返回的wrapper闭包里,装着对被装饰函数的引用。当你调用被装饰后的函数时,实际执行的是这个wrapper。
八、闭包的常见错误:迟绑定
这是闭包概念里最隐蔽的一个坑。当闭包在循环中被创建时,所有闭包实例捕获的其实是同一个变量,而这个变量的值,是以闭包被调用时的值为准,而不是创建时的值:
def create_multipliers():
    multipliers = []
    for i in range(5):
        multipliers.append(lambda x: x * i)  # i 是自由变量
    return multipliers

fns = create_multipliers()

# 全部返回 4*4=16,而不是 0*4, 1*4, 2*4, 3*4, 4*4
print([fn(4) for fn in fns])  # [16, 16, 16, 16, 16]
问题在于,循环结束时i = 4,而所有闭包引用的是同一个i。所以当它们被调用时,拿到的都是最终的4,结果自然都是4 * 4 = 16。
解决方法:利用默认参数在闭包创建时立即捕获当前值:
def create_multipliers_fixed():
    multipliers = []
    for i in range(5):
        multipliers.append(lambda x, i=i: x * i)  # i=i 把当前值绑定为默认值
    return multipliers

fns = create_multipliers_fixed()
print([fn(4) for fn in fns])  # [0, 4, 8, 12, 16]
在lambda x, i=i: ...中,右边的i是自由变量,在定义时取值为当前的循环变量;左边的i是默认参数,被绑定到lambda的局部作用域。每次循环迭代,当前i的值都被“冻结”进默认参数,之后循环变量再怎么变化,也影响不到已经绑定好的值了。
使用functools.partial也能达到同样的效果:
import functools

def create_multipliers_partial():
    multipliers = []
    for i in range(5):
        multipliers.append(functools.partial(lambda x, i: x * i, i=i))
    return multipliers
九、__closure__与自由变量的深度解析
我们可以通过__code__.co_freevars属性,直接查看一个函数捕获了哪些自由变量:
def outer(x):
def inner(y):
# z 从更外层捕获
def deeper(z):
return x + y + z
return deeper
return inner
# 查看各层函数的自由变量
outer_fn = outer(10)
inner_fn = outer_fn(20)
deeper_fn = inner_fn(30)
>>> outer_fn.__code__.co_freevars
('x',)
>>> inner_fn.__code__.co_freevars
('x', 'y')
>>> deeper_fn.__code__.co_freevars
('x', 'y', 'z')
# __closure__ 的顺序和 co_freevars 一一对应
>>> deeper_fn.__closure__
(, , | )
>>> deeper_fn.__closure__[0].cell_contents, \
deeper_fn.__closure__[1].cell_contents, \
deeper_fn.__closure__[2].cell_contents
(10, 20, 30)
| | |
co_freevars是字节码层面的元信息,告诉解释器哪些名字是自由变量;而__closure__则是这些自由变量对应的cell对象序列,两者的顺序是完全一致的。
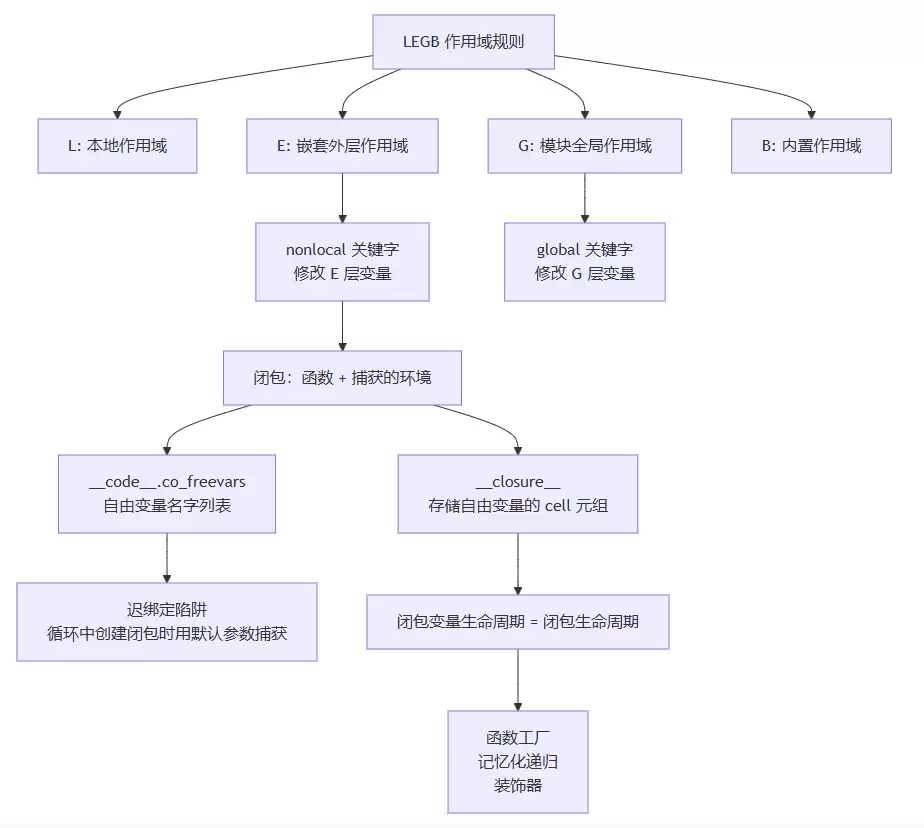
十、知识点总结
本篇LangGraph Python中文入门教程详解,系统梳理StateGraph状态机定义、节点编写、边与条件路由、检查点持久化(MemorySaver)等核心机制,提供从环境安装到完整循环智能体构建的代码示例与实操指导。
面向后端开发者,基于 Python 官方文档说明如何在 Windows 上安装 Python、创建 venv 虚拟环境及使用 pip 管理依赖。包含可复制命令、验证方法及工具选择边界,避免常见配置误区。
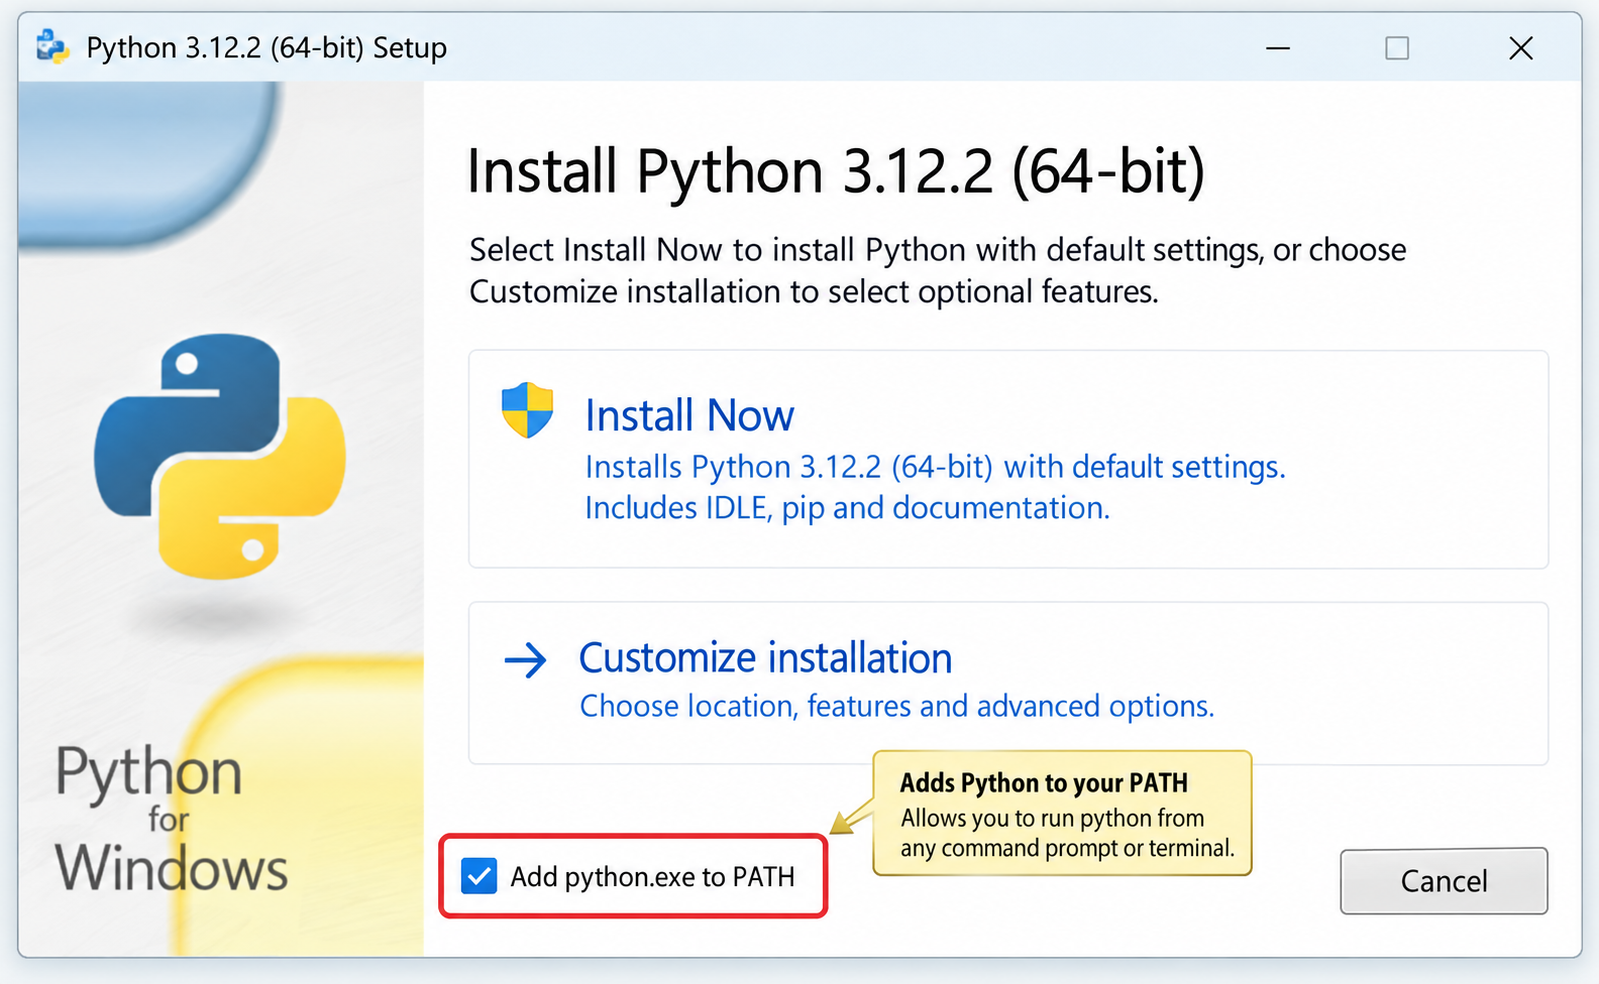
针对Windows初学者的Python安装实战指南。详细讲解如何从Python官网下载匹配架构的安装包,重点演示安装首屏勾选“Add python.exe to PATH”的关键操作,并提供使用python --version和py命令验证环境变量的具体步骤,帮助新手快速搭建开发环境并排查路径问题。
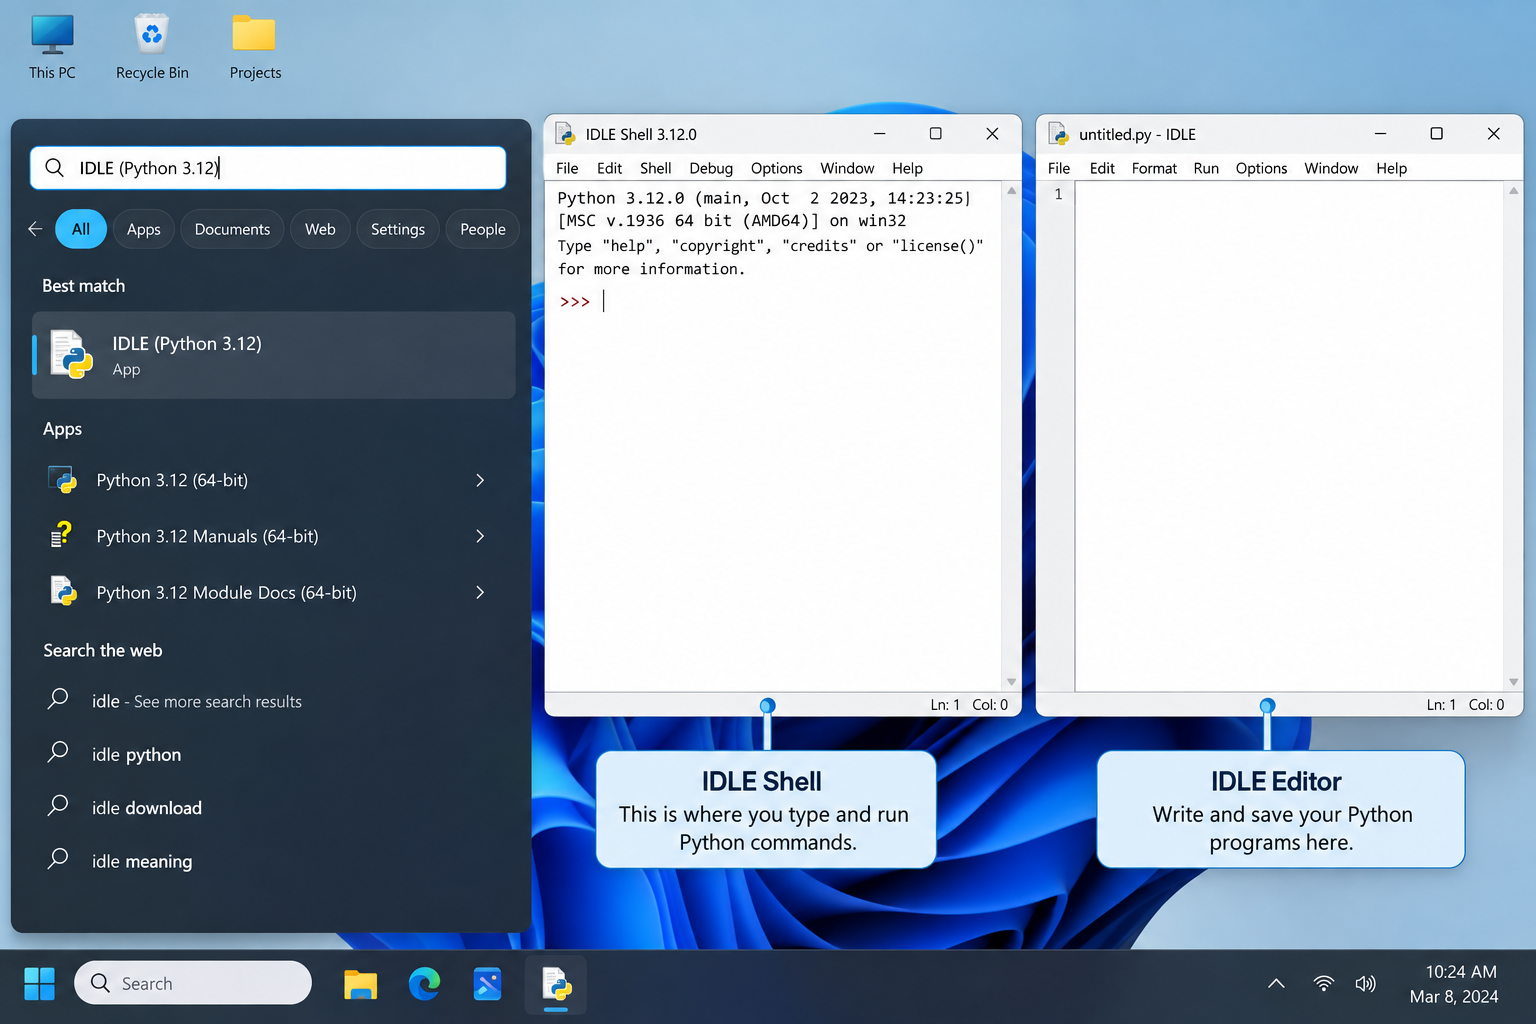
刚在Windows安装好Python却不知道如何启动?本文详细演示如何通过开始菜单找到并打开IDLE集成开发环境,以及如何在PowerShell或命令提示符中使用python和py命令启动交互式解释器、运行.py脚本文件。包含退出解释器的方法及常见启动问题排查,帮助初学者快速验证安装成功并开始编写代码。

了解Python编程领域中最好的就业行业导语:近年来,Python作为一种易学易用的编程语言,越来越受到企业和开发者的青睐。在Python编程领域中,有许多就业机会,涵盖了各个行业。本文将介绍一些Python编程领域中最好的就业行业,并提供相应的代码示例。数据科学和机器学习数据科学和机器学习是Python编程领域中最热门的行业之一。Python在数据科学和机
针对Python处理CSV文件时常见的编码报错、内存溢出和数据类型错误,本文对比标准库csv与Pandas库的适用场景,提供可复制的代码示例和因果排查思路,帮助开发者选择最优处理方案。
本文介绍如何使用Python的sorted函数对字典按值进行升序和降序排序,结合具体代码示例和应用场景,帮助读者理解排序逻辑及其在数据处理中的实际价值。
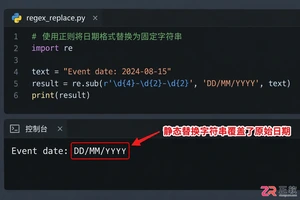
深入讲解Python中使用re.sub进行正则匹配与替换的技巧,涵盖基础语法、分组引用及回调函数应用,帮助开发者解决复杂字符串修改需求,提升代码效率与可维护性。
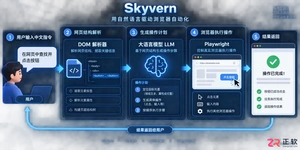
Skyvern是一款基于大语言模型的开源浏览器自动化框架,目前仅提供英文界面且无官方中文版。本文指导用户通过GitHub获取源码,使用Docker快速部署本地环境,并解释其如何通过DOM树解析与自然语言指令实现网页自动操作,同时提供针对中文用户的配置建议与替代方案。




Postman是一套面向API全生命周期的开发与测试平台,可在Mac上发送和调试多种协议请求,管理集合、环境及认证信息,并完成脚本测试、模拟服务、监控、文档发布和团队协作。它适合开发、测试及运维人员使用,提供个人免费方案。

Docker Desktop 是 Docker 官方为 Mac 提供的容器开发环境,集成 Docker Engine、命令行工具、Compose、Build、Kubernetes 与图形化管理界面。

Android Studio 是 Google 面向安卓应用开发提供的官方集成开发环境,基于 IntelliJ IDEA 构建。它整合智能代码编辑、Gradle 构建、界面预览、设备模拟、性能分析、调试测试及 APK 分析等工具。

PixPix 是面向品牌、卖家和内容团队的在线 AI 图片视频创作平台,提供图视频 Agent、无限画布、图片生成、视频生成、自然语言编辑及商品套图、产品精修和带货视频等电商工具。

Postman 是面向 API 全生命周期的开发与协作平台。Windows 桌面版可用于构建和发送 HTTP、GraphQL、gRPC、WebSocket、MQTT 等请求,并提供环境变量、集合、脚本测试、模拟服务、监控、文档及团队工作区等

Docker Desktop 为 Windows 开发者提供集成式容器环境,内置 Docker Engine、命令行工具、Compose、Build 与 Kubernetes 等组件,可在本机完成镜像构建、容器运行、日志查看和资源管理。