

循环队列数组实现指南:变量头尾指针取模运算实战技巧
循环队列通过数组实现,核心在于头尾指针的职责与取模运算。front指向队首,rear指向下一个空位,移动时需取模以确保回环。判空条件为front等于rear,判满则需牺牲一个存储单元。入队和出队操作后需立即取模,避免越界。动态内存管理时需注意分配与释放顺序,防止内存泄漏。
循环队列用数组实现,听起来简单,但很多朋友在动手写代码时,总会卡在几个关键点上:头尾指针到底指哪里?为什么判空和判满的公式长得那么像?那个“牺牲一个单元”又是怎么回事?
其实,核心逻辑就两点:用 front 指向队首元素,用 rear 指向下一个入队位置;所有指针的移动,都靠 取模运算 来实现回环。关键不在于死记硬背代码,而在于理解这套设计背后的“为什么”。
头尾指针的物理意义必须理清
front 和 rear 虽然都是数组下标,但它们的职责截然不同:
- front 始终指向当前队列中第一个有效元素,也就是出队时要取走的那个。
- rear 则始终指向下一个待插入的空位置,它本身不存储数据,更像是一个“占位哨兵”。
正因为 rear 指向的是“空位”,所以计算实际元素个数时,公式是 (rear - front + capacity) % capacity。这个公式在那些没有额外 size 字段的实现中,非常实用。
判空与判满的统一逻辑
空和满的状态,都源于同一个现象:front 和 rear 相遇了。那怎么区分呢?最经典也最推荐的做法,就是主动牺牲一个存储单元——也就是说,数组长度申请为 k+1,但只允许存 k 个元素。
- 判空:
front == rear。队列初始化时就是这个状态。 - 判满:
(rear + 1) % (k + 1) == front。理解一下:因为 rear 指向的是空位,当队列满时,这个空位再往后挪一位,就会撞上 front。那个被刻意留出的空单元,就是区分“空”和“满”的关键依据。
这里有个细节必须注意:取模运算的模数必须是 k + 1,而不是 k。如果你申请了 k+1 的空间却用 k 来取模,判满条件就会错位,极易导致数组越界或者状态误判。
入队、出队与取模操作细节
指针移动后,必须立即进行取模映射,确保它始终落在数组范围内。千万别想着先移动、最后再统一处理,那样很容易出错。
- 入队流程:
① 判断队列是否已满。
② 将元素放入data[rear]。
③ 将 rear 更新为(rear + 1) % (k + 1)。 - 出队流程:
① 判断队列是否为空。
② 将 front 更新为(front + 1) % (k + 1)。
这里不需要去清空原来data[front]的值,因为从逻辑上看,那个位置已经不属于队列了。 - 获取队首:直接返回
data[front](操作前务必先判空)。 - 获取队尾:返回
data[(rear - 1 + k + 1) % (k + 1)]。因为 rear 指向空位,所以队尾元素在 rear 的前一个位置。先减1可能得到负数,加上容量再取模,是确保下标非负的安全写法。
内存分配与释放的常见坑
当队列结构体和内部数组都是动态申请时,内存管理的顺序就特别重要,一不留神就会导致内存泄漏。
- 创建时:先 malloc 队列结构体,再为其内部的 data 数组 malloc 空间,大小是
sizeof(元素类型) * (k + 1)。 - 销毁时:顺序必须反过来,先
free(obj->data),再free(obj)。如果只 free 了结构体指针,那么它内部指向的数组内存就丢失了,造成内存泄漏。 - 另外,切记不要对栈上定义的数组(比如
int a[10])调用 free,free 只能用于释放堆上动态申请的内存。
把这些逻辑理顺了,循环队列的实现就不再是机械的代码填空,而是一套有章可循、环环相扣的设计。下次再遇到,你就能清楚地知道每一步在做什么,以及为什么要这么做了。

深入解析C++中动态数组的初始化机制,涵盖new操作符的不同用法、基本类型与类对象的初始化差异,以及为何在现代C++开发中应优先使用std::vector。
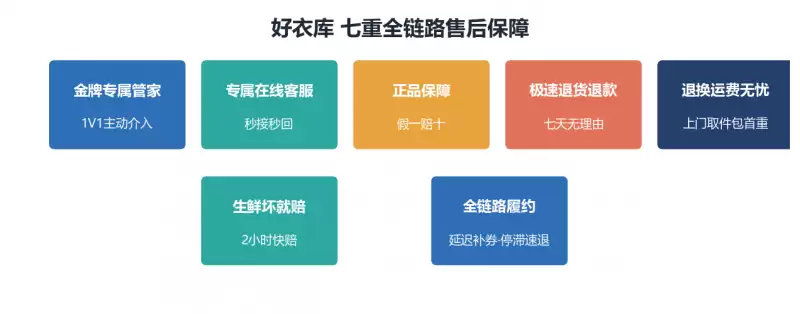
好衣库售后全程由平台统一受理,绝不甩给店主,店主零售后负担。物流合作顺丰、京东、菜鸟三大优质快递,退货运费险由人保、众安保承保。消费者全面享直购标准,退换货由平台全额兜底,买卖双方均安心省心无忧。
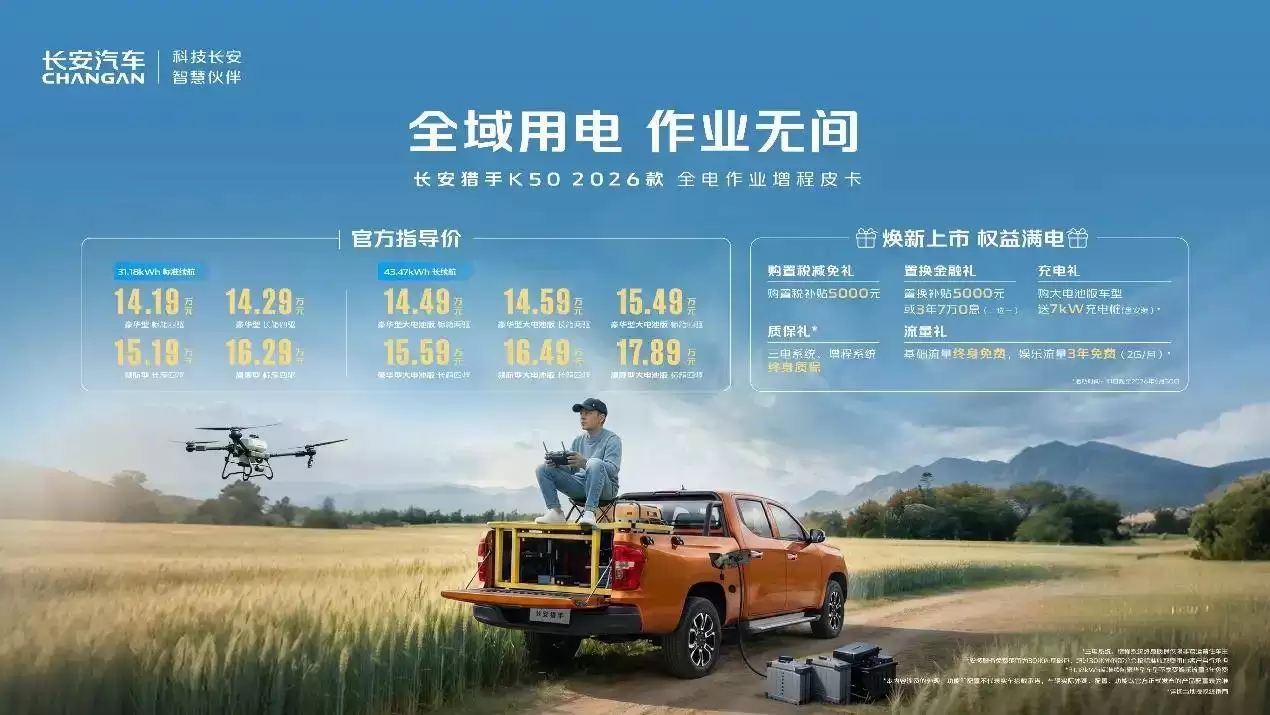
2026款长安猎手K50增程皮卡上市,售价14.19万至17.89万元。搭载2.0T超级大增程系统,双电机峰值功率240kW,百公里加速5.9秒。配备宁德时代2C电池,纯电续航192公里,总电力储备239kWh,支持30kW+3.3kW双功率供电,实现全场景用电覆盖。
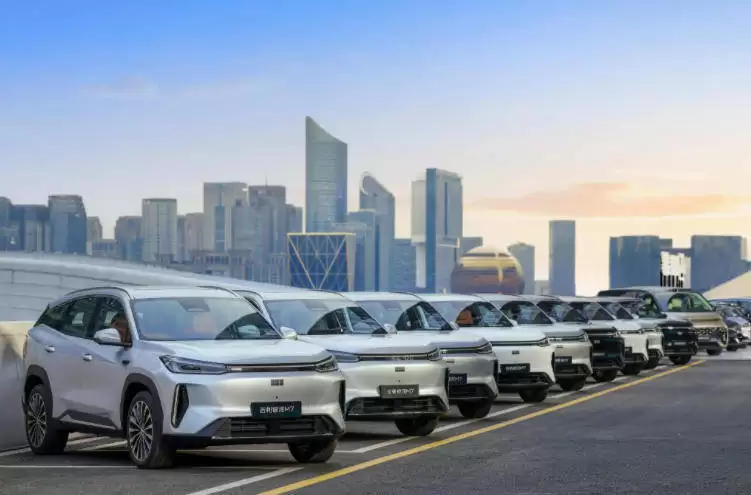
2026年5月,国内乘用车出口78.4万辆,同比增长75.1%,占厂商总销量35%。新车型成为增长核心引擎,零跑A10以2.2万辆登顶新车型冠军。消费者需求加速从功能满足转向体验升级,汽车产业进入高速迭代周期,推动行业洗牌。
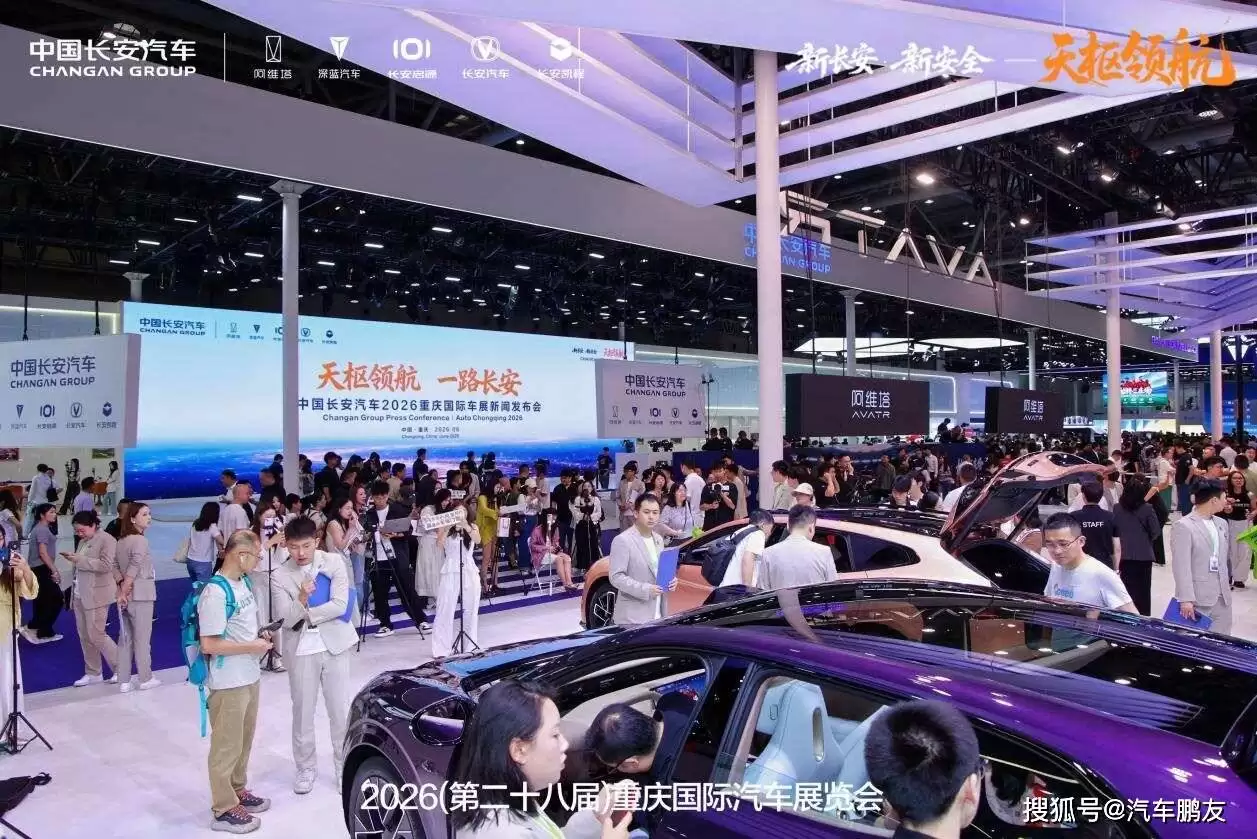
长安汽车在重庆车展发布“天枢领航”辅助驾驶系统,从安全防护、减轻压力到智能交互三个维度升级出行体验。该系统基于十七年技术深耕,依托天枢智能实验中心积累超40万虚拟场景,实测500万公里覆盖185类典型场景,形成技术-场景-用户闭环优化机制。
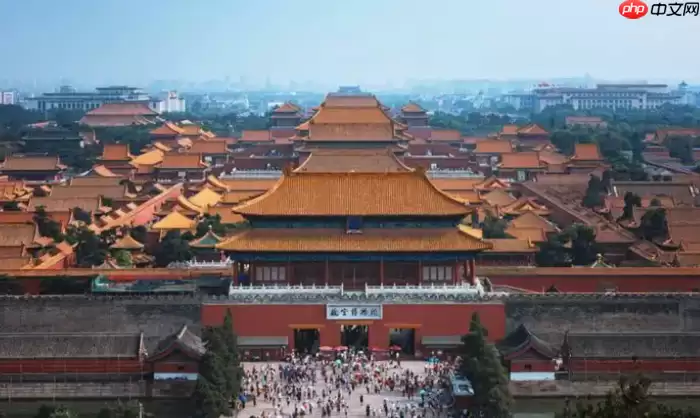
2025年度北京历史文化名城保护大事记发布,收录94项代表性事件。关键进展包括《北京中轴线世界文化遗产保护条例》施行、先农坛校址腾退实现空间贯通、长辛店老镇启动区开街、路县故城遗址公园试运行等,标志保护工作从被动抢救转向主动规划。
DBeaver25.3.3发布,优化SQL编辑器响应速度与资源占用,AI辅助自动禁用不兼容模型的temperature参数。数据编辑器默认对SELECT查询自动统计行数,修复数据迁移对话框尺寸异常。重构自动提交逻辑,升级UI布局,修正事务状态显示及macOS欢迎画面。数据库适配增强:ClickHouse修复空格解析,Sybase修复双击表打开,DuckDB新

红米十七与Note十七系列已经通过多项国际认证。红米十七搭载骁龙六sGen二四G版,含日本专属版本和POCO联名版C九五Pro。Note十七系列由三款机型组成,均基于骁龙平台,预计二零二六年七至八月率先在中国上市。
当地时间6月9日,美股三大指数走势分化,纳指与标普500双双收跌。科技板块调整明显,半导体ETF盘中最大跌幅超7%,费城半导体指数一度大跌逾8.6%。ARM跌超6%,Coherent跌逾11%,部分AI相关个股也显著回调。
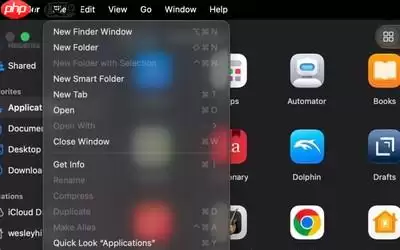
macOSGoldenGate更新后移除了菜单项图标,回归简洁纯文字布局。此前Tahoe版本引入图标但辨识度低,反而拖慢浏览效率。此次调整遵循简洁原则,显著提升可读性与操作效率,是对用户反馈的理性精简。这一改动减少视觉干扰,菜单栏更清晰,用户可快速定位功能。






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
