

2023年顶级会议和竞赛中的电信AI公司论文分享
近年来,中国电信在人工智能技术方向持续努力。2023年11月28日,中国电信数字智能科技分公司正式更名为中电信人工智能科技有限公司(以下简称“电信AI公司”)。2023年,电信AI公司在21项国内外顶级AI竞赛中连续获奖,申请了100多项专利,并在CVPR、ACMMM、ICCV等顶级会议和期刊上发表了30多篇论文,展现了国资央企在人工智能技术领域布局的初步成果作为中国电信开展人工智能业务的专业公司,电信AI公司是一家科技型、能力型和平台型企业。公司致力于攻克人工智能核心技术、研究前沿技术和推进产业空间拓展
近年来,中国电信在人工智能技术方向持续努力。2023年11月28日,中国电信数字智能科技分公司正式更名为中电信人工智能科技有限公司(以下简称“电信AI公司”)。2023年,电信AI公司在21项国内外顶级AI竞赛中连续获奖,申请了100多项专利,并在CVPR、ACM MM、ICCV等顶级会议和期刊上发表了30多篇论文,展现了国资央企在人工智能技术领域布局的初步成果
作为中国电信开展人工智能业务的专业公司,电信AI公司是一家科技型、能力型和平台型企业。公司致力于攻克人工智能核心技术、研究前沿技术和推进产业空间拓展,旨在成为一个百亿级别的人工智能服务商。在过去的两年中,电信AI公司成功地自主研发了一系列创新应用成果,如星河AI算法仓赋能平台、星云AI四级算力平台和星辰通用基础大模型等。现在,公司拥有800多名员工,平均年龄31岁,其中80%为研发人员,70%来自于国内外互联网大厂和AI头部企业。为了加速大模型时代的研发进展,公司拥有2500多个A100等效算力的训练卡以及300多名专职的数据标注人员。同时,公司还联合上海人工智能实验室、西安交通大学、北京邮电大学和智源研究院等科研机构,面向中国电信的6000万视联网和数亿用户场景,共同打造国际一流的人工智能技术和应用
接下来,我们将回顾和分享电信AI公司在2023年取得的一些重要科研成果。本次分享将介绍AI研发中心CV算法团队在ICCV 2023赛事中获得Temporal Action Localisation赛道冠军的技术成果。ICCV是国际计算机视觉领域的三大顶级会议之一,每两年举办一次,业内评价极高。本文将分享该团队在此次挑战中所采用的算法思路和方案
ICCV 2023感知测试挑战-时间动作定位冠军技术分享
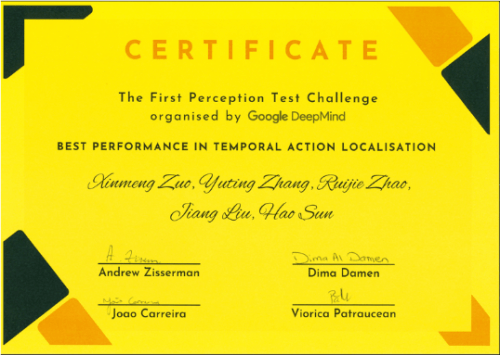
比赛概况和团队背景
DeepMind发起的ICCV 2023首届感知测试挑战旨在评估模型在视频、音频和文本模态中的能力。该竞赛涵盖了四个技能领域、四种推理类型和六个计算任务,以全面评估多模态感知模型的能力。其中,Temporal Action Localisation赛道的核心任务是对未剪辑的视频内容进行深入理解和准确的动作定位,该技术对自动驾驶系统、视频监控分析等多种应用场景具有重要意义
本次比赛中,参赛团队由电信AI公司交通算法方向的成员组成,该团队名为CTCV。电信AI公司在计算机视觉技术领域深入研究,并积累了丰富的经验。其技术成果已在城市治理、交通治安等多个业务领域广泛应用,并持续服务海量用户
引言是一篇文章的开头部分,旨在引起读者的兴趣并提供背景信息。一个好的引言可以吸引读者的注意力,概括文章的主题,并激发读者继续阅读的欲望。在写引言时,需要注意语言简洁明了,内容准确有力。引言的目的是为了引导读者进入文章的主题,因此需要引用相关的事实、数据或引人思考的问题。总之,引言是文章的门户,可以决定读者是否继续阅读下去
视频理解中的一个挑战性问题是在视频中定位和分类动作的任务,即时序动作定位(Temporal Action Localisation, TAL)
TAL技术近期取得了显著进展。举例来说,TadTR和ReAct采用了类似DETR的基于Transformer的解码器来进行动作检测,将动作实例建模为一组可学习的集合。而TallFormer则利用基于Transformer的编码器来提取视频表征
尽管以上方法在时序动作定位方面已经取得了良好的效果,但在视频感知能力方面存在一些限制。要更好地定位动作实例,可靠的视频特征表达是关键。我们的团队首先采用VideoMAE-v2框架,加入adapter+linear层,训练了具有两种不同主干网络的动作类别预测模型,并使用模型分类层前一层进行TAL任务的特征提取。接下来,我们利用改进的ActionFormer框架训练了TAL任务,并修改了WBF方法以适应TAL任务。最终,我们的方法在评测集上实现了0.50的mAP,排名第一,领先第二名的团队3个百分点,比Google DeepMind提供的基准模型高出34个百分点
2 竞赛解决方案
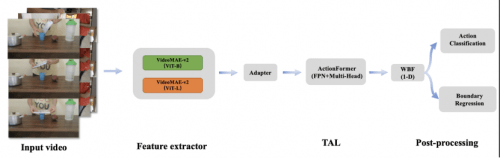
算法概览如下图所示:
2.1 数据增强
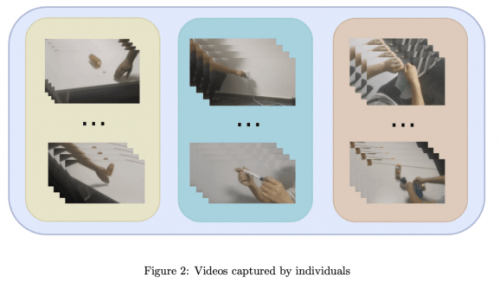
在Temporal Action Localisation赛道中,CTCV团队使用的数据集是未经修剪的用于动作定位的视频,具有高分辨率,并且包含多个动作实例的特点。通过分析数据集,发现训练集相较于验证集缺少了三个类别的标签。为了保证模型验证的充分性以及满足竞赛的要求,团队采集了少量的视频数据,并将其加入训练数据集中,以丰富训练样本。同时为了简化标注过程,每个视频预设只包含一个动作
请参考图2中自主采集的视频样例
2.2 动作识别和特征提取
近年来,出现了许多基于大规模数据训练的基础模型,这些模型通过零样本识别、线性探测、提示微调、微调等方法,将基础模型的强大泛化能力应用到多个下游任务中,有效推动了人工智能领域的多个方面的进步
TAL赛道中的动作定位和识别十分具有挑战性。例如,"假装将某物撕成碎片"和"将某物撕成碎片"这两个动作非常相似,这无疑给特征层面带来了更大的挑战。因此,直接使用现有的预训练模型提取特征的效果并不理想
因此,我们团队通过解析JSON标注文件,将TAL数据集转换为动作识别数据集。然后,我们以Vit-B和Vit-L为主干网络,在VideoMAE-v2网络后增加adapter层和用于分类的linear层,训练同数据域下的动作分类器。我们还将动作分类模型去掉linear层,用于视频特征的提取。VitB模型的特征维度为768,而ViTL模型的特征维度为1024。当我们同时将这两种特征进行concat时,我们生成了一个新的特征,维度为1792,这个特征将作为训练时序动作定位模型的备选。在训练的初期,我们尝试了音频特征,但实验结果发现mAP指标有所下降。因此,在随后的实验中,我们没有考虑音频特征
2.3 时序动作定位
Actionformer是一个以时间为序的动作定位设计的anchor-free模型。它融合了多尺度特征和时间维度的局部自注意力。在本次竞赛中,CTCV团队选择Actionformer作为动作定位的基准模型,用于预测动作发生的边界(起止时间)和类别
CTCV团队对动作边界回归和动作分类任务进行了统一处理。相对于基线训练结构,首先将视频特征编码到多尺度的Transformer中。然后在模型的回归和分类的head分支中引入了特征金字塔层,以增强网络特征表达能力,每个时间步骤的head分支会生成一个动作候选。同时,通过增加head数量到32,并引入fpn1D结构,进一步提升了模型的定位和识别能力
1-D的2.4 WBF
加权盒子融合(Weighted Boxes Fusion,简称WBF)是一种创新的检测框融合方法。该方法利用所有检测框的置信度来构造最终的预测框,在图像目标检测中表现出了不错的效果。与NMS和soft-NMS方法不同,加权盒子融合不会舍弃任何预测结果,而是利用所有提出的边界框的置信度分数来构造平均的盒子。这种方法大大提高了预测矩形的准确性
在WBF的启发下,CTCV团队将动作的一维边界框类比为一维线段,并对WBF方法进行了修改,使其适用于TAL任务。实验结果显示该方法的有效性,如图3所示
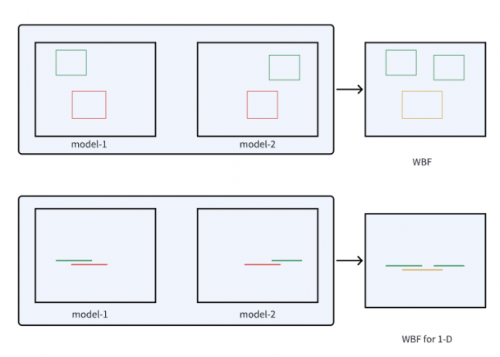
改进后的一维WBF示意图如图3所示
3 实验结果
3.1 评估指标。 评估标准
评估指标是mAP,用于本次挑战赛。mAP是通过计算不同动作类别和IoU阈值的平均精确度来确定的。CTCV团队以0.1的增量评估IoU阈值,范围从0.1到0.5
3.2 实验细节重写如下:
为了得到多样化的模型,CTCV团队对训练数据集进行了80%的重复采样,总共进行了5次。分别采用了Vit-B、Vit-L和concat的特征进行模型训练,成功得到了15个多样化的模型。最终,这些模型的评估结果被输入到WBF模块,并为每个模型结果分配了相同的融合权重
实验结果如下所示:
表1中显示了不同特征的性能比较。第一行和第二行展示了使用ViT-B和ViT-L特征的结果。第三行展示了ViT-B和ViT-L特征级联的结果
在实验过程中,CTCV团队发现级联特征的平均精确度(mAP)略低于ViT-L,但仍优于ViT-B。尽管如此,通过在验证集上的各种方法表现,我们将不同特征在评测集的预测结果借助WBF进行融合,最终提交到系统的mAP为0.50
需要重新改写的内容是:4 结论
CTCV团队在本次竞赛中采取了多项策略来提升性能。首先,他们通过数据收集来增强验证集中缺失的类别的训练数据。其次,他们利用VideoMAE-v2框架加入adapter层来训练视频特征提取器,并通过改进的ActionFormer框架来训练TAL任务。此外,他们还修改了WBF方法以有效地融合测试结果。最终,CTCV团队在评测集上取得了0.50的mAP,名列第一。 电信AI公司一直秉持着“技术从业务中来,到业务中去”的发展理念。他们将竞赛视为检验和提升技术能力的重要平台,并通过参与竞赛不断优化和完善技术方案,为客户提供更高质量的服务。同时,参与竞赛也为团队成员提供了宝贵的学习和成长机会
Google与Gentle Monster、Warby Parker及Samsung合作的智能眼镜开放预订,计划12月10日开售。产品支持Gemini、语音导航与翻译;购买前应核对美国/韩国账号、18岁及兼容手机要求,并区分相机视觉与聊天历史的隐私设置。
NVIDIA董事会宣布黄仁勋立即辞去总裁、CEO及董事职务,由CFO Colette Kress兼任临时CEO,Harvey C. Jones出任董事长。此次公告确认的是管理层交接,客户应持续核对正式产品与交付公告。
OpenAI已于北京时间11月12日04:52:40确认登录、注册与部分ChatGPT功能事件恢复,调查范围也曾包括通过OpenAI API创建会话的错误率。该事件已恢复,用户应核对失败操作与实际结果,不能推断所有API都曾不可用。
OpenAI已于北京时间11月12日17:25:12确认图像API错误率升高事件解决,事件先涉及GPT image 2.5 Sunburst与Flare,随后扩展到2.6对应变体。开发者应检查失败请求,避免把恢复确认误解为生成结果自动补回或计费政策变化。
OpenAI 已确认Workspace Agent新运行故障恢复,官方于北京时间11月12日16:32:37将事件标记为已解决。此事件范围是新运行,恢复确认不代表失败任务自动补跑;用户应检查自己的运行记录与业务结果。
百度文心闪电与文心一镜上线千帆API。梳理两款模型的能力差异、适用场景、官方计费、接入流程与常见问题,说明128K输出、异步视频任务和素材要求。
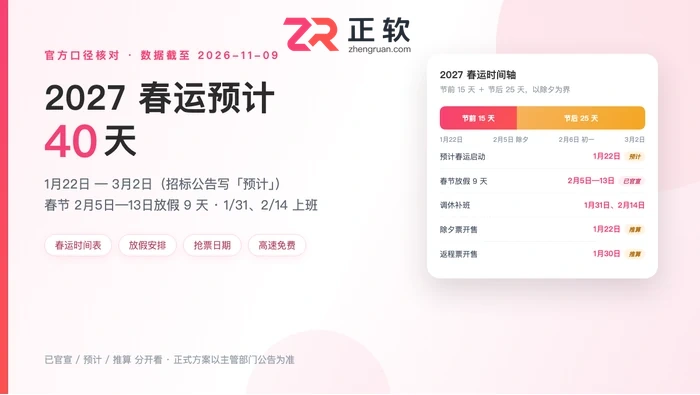
2027年春运预计1月22日开始、3月2日结束共40天,该日期出自官方招标公告的「预计」口径,交通运输部正式方案尚未发布。已官宣的是春节2月5日至13日放假9天、1月31日与2月14日上班(国办发明电〔2026〕10号)。本文按13步一步一图核对官方原文、春运日历、抢票日期推算、高速免费规则与候补购票,附时间表速查与常见问题。
面向计划进行后续训练与研究的开发者,百度于2026年11月5日开放ERNIE 5.5 Flash Base模型权重。该版本定位为基座模型,不具备直接对话适配能力,不同于面向普通用户的聊天助手。本文解析基座模型与聊天应用的区别,说明下载权重并非完整落地流程,需结合运行框架、硬件资源及许可条件进行评估。提醒用户此次开放不涉及文心全系产品升级,建议开发团队先阅读模型卡与许可要求,通过小规模任务验证输出效果与资源占用,避免直接用默认聊天体验作为唯一判断标准。
解析宇树科技营收增长但净利下降的原因,说明一加Ace 7 Pro 185Hz高刷的具体适用场景,并厘清Gemini 4 Carbon在长任务与代码安全方面的开放范围,提供准确的数据阅读方法。
Mate70 Pro与iPhone16 Pro拍照样张对比:观察食物暖色、展厅背景色差和红叶层次,说明构图与拍摄条件的限制,区分风格偏好与综合影像能力。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



