

对话小宿科技:搜索比推理便宜10倍,但90%的人不知道
随着AIAgent普及,其高昂的Token成本成为痛点,主要源于重复搜索、低质量上下文等造成的浪费。智能搜索专为Agent设计,通过将搜索与模型推理解耦,提供精准、结构化的任务信息,从而优化处理链路、降低成本。开发者应优先治理搜索与上下文质量,减少无效Token,再依据任务复杂度进行优化。
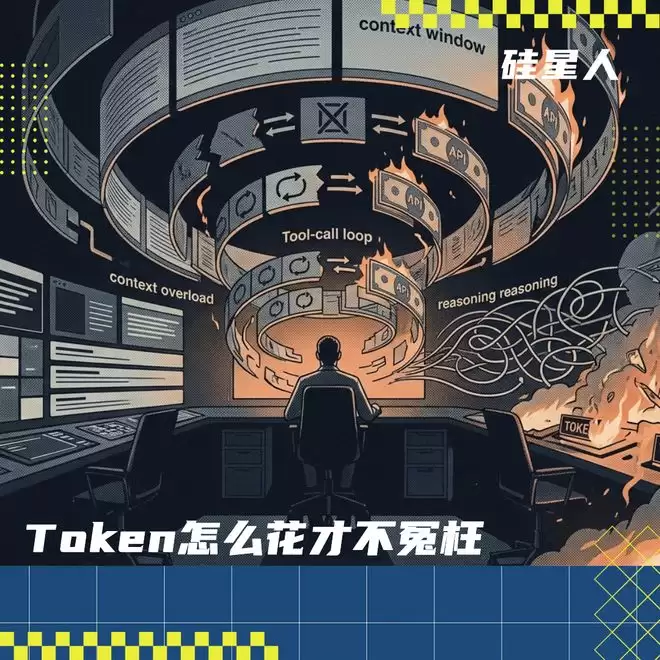
OpenClaw的风靡,让不少开发者第一次看清了自己的Token账单——一个用户请求触发多轮工具调用,每次携带超长上下文,实际的API成本远超想象,有时甚至是订阅费用的数十倍。Token账单,正在成为越来越多Agent开发者的心头之患。
这显然不是健康的商业模式。一个Agent应用,如果连自己的Token成本结构都算不清楚,就谈不上走向市场。问题或许不全在于Token太贵,而在于大量Token被花在了不该花的地方:重复搜索、低质量上下文、错误粒度的信息,以及选错的模型。
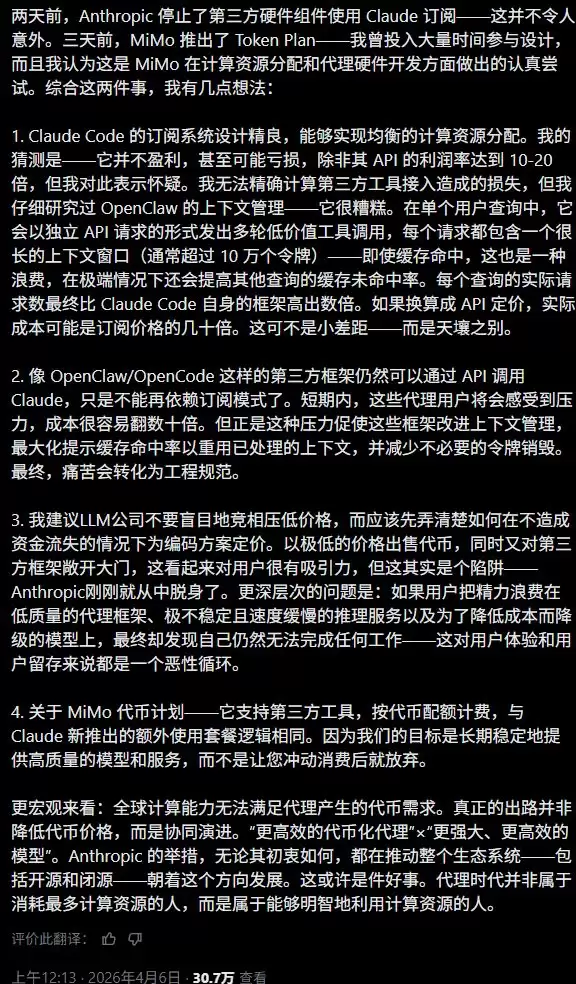
小米MiMo大模型负责人罗福莉此前在博文中也提到:Agent时代不属于消耗最多算力的人,而属于最会使用算力的人。每个做AI的人,都应该建立自己的Token经济学。
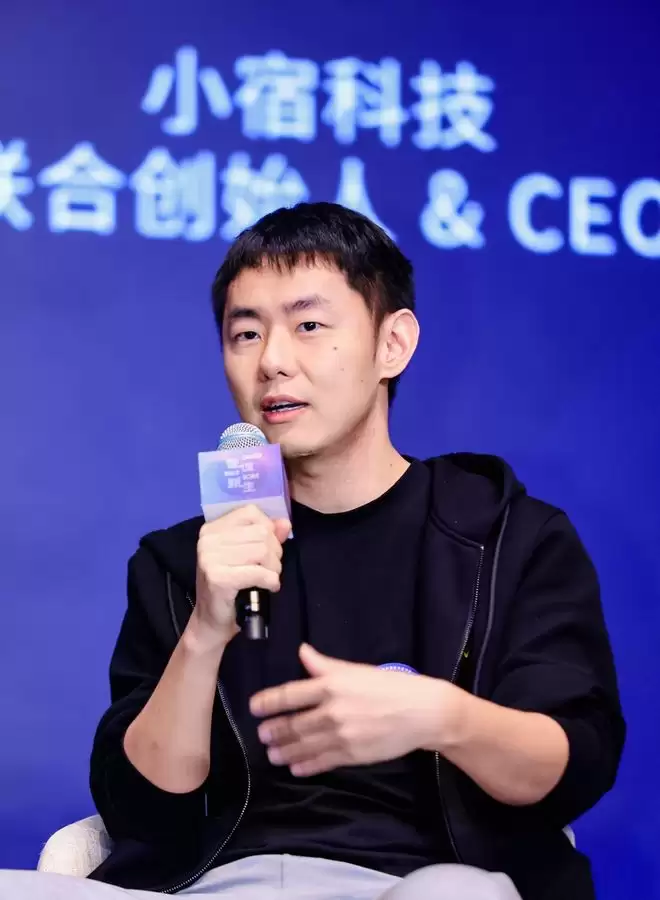
带着这个问题,我们找到了杜知恒:小宿科技的CEO兼联合创始人,亲历了搜索引擎从PC端向移动端迁移的整个过程。小宿科技的主营业务是智能搜索,为AI Agent提供搜索引擎服务。这不同于给人用的搜索,而是专为Kimi、DeepSeek、Manus等Agent产品调用的智能搜索基础设施。目前,国内超过50%的头部Agent企业都在使用他们的搜索API,月调用量达到数亿次。
在智能搜索这条路上深耕多年,杜知恒对于“Token怎么花才不冤枉”这件事,积累了大量的实战经验。我们和他深入聊了聊:搜索怎么做才省Token?搜索和推理该如何配合?模型又该怎么选才划算?
一、智能搜索,从源头把信息喂对
问:我们常说AI“联网搜索”,但Agent调用搜索引擎,和人类打开浏览器搜索,本质上有什么不同?
杜知恒:区别非常大。人在用搜索引擎时,本质上是在“浏览信息”——会被标题吸引,用摘要来判断要不要点进去,然后一条一条地阅读。所以传统搜索长期优化的目标是相关性和点击效率,核心指标是CTR(点击率)。
但Agent调用搜索,根本目的不是浏览,而是获取执行任务所必须的“原材料”。它可能在基于搜索做研究、写报告、定计划,或者把搜索结果传给下一个工具继续处理。在Agent的链路里,搜索结果不是一个“入口”,而是任务链路的“原材料”。
这一字之差,意味着优化目标完全不同。你不再需要把最容易点击的链接放在前面,而是要交付一组足够完整、可信、可追溯、且模型能高效读取的内容。举个具体例子:如果你让Agent规划一次新加坡亲子度假,Agent不会像人一样一条条点开比较,而是需要快速抓取签证、航班、酒店价格、儿童设施、天气、安全性等全部信息,然后整合成可执行的行程。搜索在这里的作用,是批量、快速、精准地提供执行所需的原材料。
问:现在AI生成的内容越来越多,有些甚至一本正经地胡说八道,搜索引擎能判断出来吗?
杜知恒:我们的质量控制是多层次的。
第一层是来源和内容质量的基础筛选。这包括网页之间的互相引用关系、是否来自权威媒体或机构、语言表达的结构质量等,模型会对这些做一轮整体评估。
第二层是信息密度和原创性判断。一篇内容有没有真实的信息增量?有没有原始出处?还是仅仅是对更早内容的重复加工?这里也会用到时间戳——如果一条内容比它的原始来源发布得晚,大概率只是转述。
第三层是交叉验证。我们会把需要判断的内容与原始发布源——最新文件、论文、数据库、可信媒体——做比对。如果一条信息链条全部是转述,它基本上就不可用。
除此之外,我们还会控制结果之间的互补性。对人来说,10条结果里有7条内容重复是可接受的,点一条就够了。但对Agent来说,重复就是浪费,它需要的是不同角度、不同信源的信息覆盖,让每一条结果都有增量价值。
问:这里面有一个问题,传统搜索引擎靠点击率做迭代,但Agent不点击,你们怎么知道搜索结果的好坏?
杜知恒:这是Agent时代做搜索最核心的挑战之一。用人来搜索,你能实时看到每一类query的点击情况,CTR高就是比CTR低的效果好,A/B测试非常直接。但对Agent来说,不管搜索结果好不好,客户都是直接拿走10条或20条,你看不到任何点击信号。
反馈的来源因此变成了客户本身。客户的Agent在某个场景下质量不好,它自己能感知——用户会追问,给出差评,或者Agent反复处理同一个已经回答过的问题。虽然不像点击率那样非零即一,但这都是强化学习可以利用的信号。
问:这意味着你们必须和客户深度绑定,客户愿意和你们共享优化所需的反馈信息吗?
杜知恒:这本质上是一个信任问题,也是这个赛道真正的壁垒所在。客户要优化他的Agent质量,就需要对调用的搜索API提更具体的建议和要求。但反馈信号是最有价值的数据,他只有足够信任你,才愿意共建。
信任的前提是基础能力过关,你至少要达到接近主流商业引擎的水平,客户才会认真和你合作。在这个基础之上,他会告诉你某个垂类的前几条质量有什么问题,某类query的结果总让人不满意。这更像是市场上的长期交易关系:你们每天在交互,某天他告诉你周四的鱼不够新鲜,你就去优化你的供应链。
高质量的深度合作客户一定是有限的,我们也会挑选合作对象。把所有信号都扔进来等于没做,你需要那些需求有普适性的客户,他们的反馈才能真正帮助提升基础能力,这对双方都是有价值的互依关系。
二、搜索与推理解耦:能查就别算
问:现在很多开发者直接用模型自带的搜索能力,比如开了联网的GPT。单独拆出来搜索这一层,有什么好处?
杜知恒:从最抽象的层面来说,人类面对一个问题只有两个选项:一是绞尽脑汁去推理计算,比如做一道数学题;二是去查,用字典,用搜索引擎,看有没有直接的结果。对Agent来说完全一样,一种是用模型做推理,另一种是去互联网上查看有没有原生结果。
大部分情况下,查字典比做推理更可靠、也更便宜。推理会产生幻觉,搜索虽然也不能保证百分之百准确,但错误率远低于凭空推理。更重要的是,推理消耗的Token要多得多。所以但凡有确定答案的问题,调用搜索的性价比远高于让模型自己推理。
目前很多Agent还没有建立“优先搜索”的习惯,很多本可以查一下就解决的问题走了推理链路,既不准确也不经济。
问:在具体执行层面,一次复杂任务里,搜索嵌在哪里?
杜知恒:搜索不是单点触发的,而是嵌在任务链路的中间层。还是用旅行规划举例:Agent拿到任务后,首先用推理把任务拆解成若干子问题——目的地信息、签证要求、航班选项、酒店、儿童设施等。然后针对每一层子问题,调用最适合的工具:有些调搜索引擎,有些直接调携程的API,有些调天气服务。最后再用推理把所有结果整合成可执行的方案。
所以一次完整任务的结构是:推理拆解→多层搜索与工具调用→推理整合。第一段推理负责分解,最后的推理负责综合,中间的执行链路尽量让搜索和专用工具来承担,这才是性价比最高的设计。
问:搜索结果的输出形式怎么定?什么时候给长文本,什么时候给短摘要?
杜知恒:这取决于客户场景的优先级。有些场景是时延优先的,比如聊天机器人实时回复,用户等不了太久,这时候应该给短摘要,让Agent能快速整合出回答。有些场景是质量优先的,比如学术研究、生成深度报告,这时候需要把网页甚至PDF的完整内容都读出来,给Agent一个干净完整的长文本,让它有足够的原材料工作。
这不是我们单方面决定的,而是基于客户的具体场景配置。本质上都是实时数据的获取,只是交付形态不同,搜索结果对客户的Agent来说是一种输入,不同的场景对输入的要求是完全不一样的。
三、Token怎么省,选择非常重要
问:模型越来越多,开发者怎么选?同一个产品的不同场景,能选择不同的模型么?
杜知恒:我觉得这是今天很多开发者都会遇到的一个现实问题。模型越来越多之后,最容易出现的误区,就是把问题简单理解成“到底该选哪一个最强的模型”。
但真实业务不是这样运转的。一个Agent要完成任务,背后通常同时涉及数据获取、信息处理、上下文组织、模型推理和工程编排等多个环节。
这些环节不是彼此独立的。很多问题表面上看是模型效果问题,实际上可能是数据质量不够、上下文过长,或者链路设计本身不够合理;表面上看是调用成本高,往下拆解,往往也不一定是模型本身贵,而是不同复杂度的任务被放进了同一种处理方式里。
从我们的视角看,开发者当然可以,而且应该在同一个产品的不同场景里使用不同能力层级的模型。
因为同一个产品内部,本来就会同时存在很多不同性质的任务:有些是分类、抽取、翻译、改写这类相对标准化的任务;有些是复杂理解、长链路决策、多工具协同这类更吃推理能力的任务。它们对模型能力、稳定性、延迟和成本的要求,本来就不一样。
如果所有场景都用同一套最高配置,效果未必最好,成本通常也不合理;但如果只追求低价,把所有任务都压到低配模型上,也很容易在稳定性和结果质量上出问题。
真正重要的,不是先问“哪个模型最强”,而是先把任务拆开,看清楚每个环节到底需要什么能力、什么质量要求、什么响应速度,以及什么样的成本结构。
当这些问题想清楚之后,模型选择反而会变得更自然:不是围绕模型去做产品,而是围绕场景去配置能力。
问:你之前提到模型内绑搜索的成本是独立搜索API的5到10倍。罗福莉也指出很多系统频繁压缩搜索返回结果导致缓存失效。这个5-10倍具体怎么来的?开发者把搜索从模型里解耦出来单独采购,实际能省多少?
杜知恒:这个5到10倍,是几层成本叠加出来的结果。
第一层,搜索结果变成了持续性的上下文包袱。正常情况下一次搜索调用,结果返回了就结束了。但搜索绑进模型内部之后,这些内容会进入长上下文,在后续每轮推理里被反复携带——成本从“一次查询”变成了“多轮放大”。
第二层,对搜索结果的二次处理本身也在烧Token。很多系统会对结果做摘要、压缩、改写再塞回模型,本意是省钱,但策略不合理的话,这一步本身就在额外消耗Token,同时还可能丢掉关键信息,结果是既没省到钱,效果反而变差了。
第三层,缓存命中率被大幅拉低。搜索结果是高度动态的,一旦进入上下文,每次输入都在变,缓存复用几乎直接失效。
第四层,把本该在模型外完成的事情全交给了模型。抓取、正文提取、去重、排序、结构化,这些在模型外都可以高效完成,但如果全扔给模型来做,就是在用最贵的一层系统做最不划算的事。
这几层叠在一起,倍数就出来了。
解法上,我们的思路是尽可能把这些动作前置,在信息进模型之前就把“形态”处理好。但这里有个现实矛盾:压缩太狠会丢细节,直接喂全文成本又压不住。
这也是我们做Chunks(片段提取)的原因——从原始内容里提取与当前问题最相关的片段并重新组织,而不是整篇塞进去。比如做投资研究时,Agent需要分析一家公司,如果直接读20篇全文,每篇约1000字,总输入大概2万字;通过Chunks提取关键片段重组之后,输入可以降到原来的约70%,关键细节仍然保留,Token成本降低约30%,同时信息覆盖率能维持在95%。
回到你的问题,解耦到底能省多少?很难给一个统一的数字,不同业务链路差异很大。但如果原来是“模型内直接接搜索 + 大量结果反复进长上下文”这种架构,做完解耦加前置结构化处理之后,成本、延迟、稳定性通常都会有明显改善。
真正省下来的,不只是某一次调用的钱,而是整条Agent链路里大量原本不必要发生的Token消耗。
问:怎么做会使用算力的聪明人?如果一个Agent团队想把Token成本降下来,你建议他们先优化搜索环节还是先优化模型选择?哪个环节的省钱空间更大?
杜知恒:如果只能给一个建议,我会说:先别急着换模型,先把输入和链路看清楚。
原因很直接。从我们接触的大多数团队来看,真正最容易被忽略、但也最容易放大成本的,往往不是模型本身,而是搜索和上下文的组织方式。
逻辑很简单:如果搜索结果本身就是长的、重复的、不结构化的,或者同一份材料在链路里被反复拼接、反复摘要、反复送进模型,那你后面不管换哪个模型,本质上都还是在为无效Token付钱。
所以很多时候,第一刀应该先落在前面这一层:搜索结果是不是过长?有没有重复内容?有没有把网页正文、摘要、历史上下文一起无差别塞进去?哪些信息根本没必要进入模型?哪些内容可以复用,哪些又在每次都重新计算?
把这些问题理顺之后,模型选择优化的价值才能更稳定地体现出来。因为这时候你是在一个更干净、更克制的输入基础上去分配能力,而不是在一堆已经失控的上下文上做局部修补,那种状态下换模型,大概率只是换了个贵一点或便宜一点的方式继续烧冤枉钱。
所以如果一定要排个顺序:短期内最容易看到明显降本效果的,往往是搜索和上下文治理;中长期最稳定、最体系化的优化,是前面的信息治理和后面的推理能力分配一起做。前者解决的是“不该喂给模型的东西太多”,后者解决的是“不该高配的地方太多”。
这两件事叠加起来,才是真正意义上的Token效率优化。
5月20日,阿里云在峰会上宣布完成“芯片-云-模型-推理”全栈Agent化升级,同步推出全新AI产品“千问云”、搭载自研AI芯片真武M890的超节点服务器,以及最新旗舰模型Qwen3.7-Max。
5月20日,阿里云发布消息,宣布其全栈产品已为Agentic时代做好准备,并重磅推出了覆盖“芯-云-模型-推理”的系列升级。这被视为行业内首次围绕智能体(Agent)进行的系统性全栈产品发布。 在相关峰会上,阿里云资深副总裁刘伟光指出,智能体一旦突破发展的临界点,将能够实现24小时不间断工作,其对人
北京商报讯(记者 陶凤 王天逸) 人工智能领域又传来一条振奋人心的消息。4月8日,摩尔线程正式宣布,其旗舰级AI训推一体全功能GPU——MTT S5000,已经成功完成了对智谱新一代旗舰模型GLM-5.1的Day-0极速适配。这意味着,推理部署与训练复现的全部流程,现在都能在这条国产算力路径上获得支
强化学习(RL)结合真实搜索引擎可以显著提升大模型的检索和推理能力。然而,这一方法面临两大挑战:搜索引擎返回的文档质量不稳定,导致训练过程中的噪音和不稳定性;RL训练需要频繁部署,产生大量API开销,限制了可扩展性。针对这些问题,阿里通义实验室推出了开源解决方案ZeroSearch,这是一个无需与真实搜索引擎交互的强化学习框架。实验表明,ZeroSearch只需使用3B参数的LLM作为检索模块,就能有效提升搜索能力,并大幅节省API成本。ZeroSearch让LLM实现自给自足
OpenAI用o1开启推理算力ScalingLaw,能走多远?数学证明来了:没有上限。斯隆奖得主马腾宇以及GoogleBrain推理团队创建者DennyZhou联手证明,只要思维链足够长,Transformer就可以解决任何问题!通过数学方法,他们证明了Transformer有能力模拟任意多项式大小的数字电路,论文已入选ICLR2024。用网友的话来说,CoT的集成缩小了Transformer与图灵机之间的差距,为Transformer实现图灵完备提供了可能。这意味着,神经网络理论上可以高效解决复杂问题。
自动推理绝对算是自然语言处理领域的一大难题,模型需要根据给定的前提和知识推导出有效且正确的结论。尽管近年来NLP领域借着大规模预训练语言模型在各种「自然语言理解」如阅读理解和问答等任务中取得了极高的性能,但这些模型在逻辑推理方面的性能仍然十分滞后。去年5月「思维链」(ChainofThought,CoT)横空出世,有研究人员发现,只需要在prompt中加入「Let'sthinkstepbystep」就能让GPT-3的推理性能大幅提升,比如在MultiArith中就将推理准确率从之前的17.

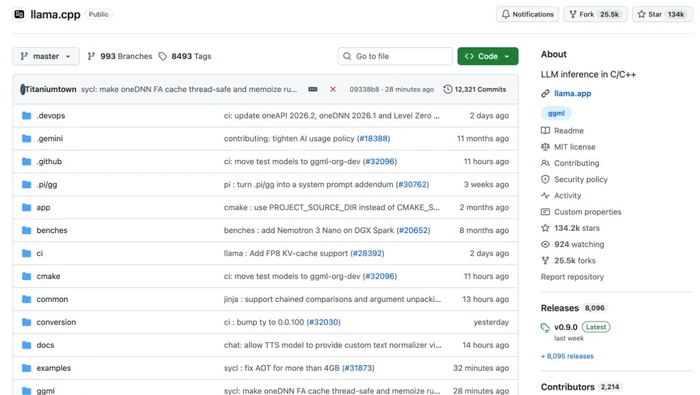
llama.cpp b12489、b12490、b12491、b12492、b12493、b12494、b12496、b12497、b12498 均为预发布构建,分别涉及服务器、语音模型及特定后端;适用范围须按模型、硬件和请求条件区分。
MiniMax-H3-Image新增DiffSynth-Studio文档推荐后,配置选择应围绕具体推理配方和独立训练流程展开。文档中的24GB GPU方案分别配合32GB或8GB主机RAM,所用量化、CPU或磁盘卸载方式不同;新增文档入口本身没有发布模型新权重或标注一个新的框架版本。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



