

AMD将于2026年推EXPO 1.2,新增ULL低延迟
AMD这边放出了个消息,2026年6月1日,他们那个专为AM5平台设计的内存超频技术EXPO,就要迎来1.2版本更新了。简单来说,EXPO这东西,对标的就是主流平台的内存调优标准,让DDR5内存能一键跑上更高频率、更优时序。这么多年用下来,玩家们应该不陌生。这次更新的重头戏在哪儿?答案是引入了EXP
AMD这边放出了个消息,2026年6月1日,他们那个专为AM5平台设计的内存超频技术EXPO,就要迎来1.2版本更新了。简单来说,EXPO这东西,对标的就是主流平台的内存调优标准,让DDR5内存能一键跑上更高频率、更优时序。这么多年用下来,玩家们应该不陌生。
这次更新的重头戏在哪儿?答案是引入了EXPO Ultra Low Latency技术,简称EXPO ULL。说白了,就是兼容的内存插上之后,系统能自动激活一个专属的低延迟运行模式,既能提频率,又能自动把时序调得更紧——省去了玩家自己捣鼓参数的那一步。
拿一套DDR5-6000的内存举例,开启EXPO ULL之后,延迟能直接降低5到7纳秒。实测数据也挺直观:跟JEDEC标准比,三十多款主流游戏的平均帧率提升了13%,最低帧率更是拉高了15%;就算跟基础的EXPO配置比,平均帧率和最低帧率也各自涨了4%。这提升幅度,对于不想折腾的玩家来说,算是“开箱即用”了。
当然,门槛也很清晰。EXPO ULL技术目前只认AM5平台和DDR5内存。好消息是,适配的品牌已经不少了:芝奇、金士顿Fury、科赋、雷克沙、Origin Code、十铨、全何,还有威刚XPG。什么时候能在市场上买到这些模组,就得看各家产品的上市节奏了。
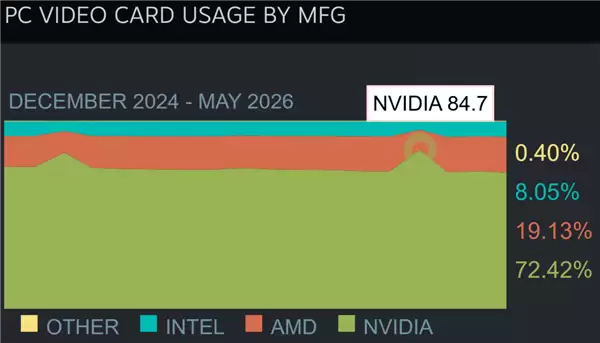
据Steam硬件调查,2026年6月AMD显卡市占率达19.13%创下历史最高纪录,NVIDIA以72.42%位居榜首。RDNA4架构新品RX9070XT与RX9060XT首次进入榜单。AMD处理器在Windows游戏环境占有率达到44.97%,三个平台合计46.06%,与英特尔差距进一步收窄,预计7月持平。Windows11占比69.78%成为主流操作系统
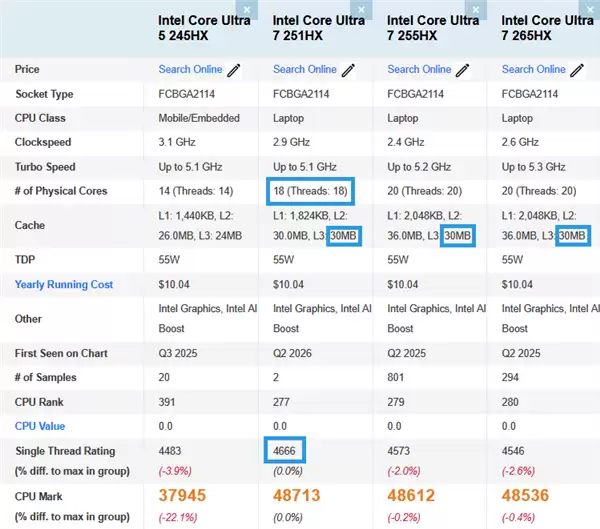
英特尔酷睿Ultra7251HX处理器采用18核(6性能+12能效)设计,集成30MB缓存,基础功耗55瓦,最高睿频功耗160瓦,加速频率达5.1GHz。单核性能得分4666,多核性能得分48713,领先竞品约百分之二至三。已确认将搭载于联想Legion5i2026和微星Raider16HX等游戏本,性能出色。
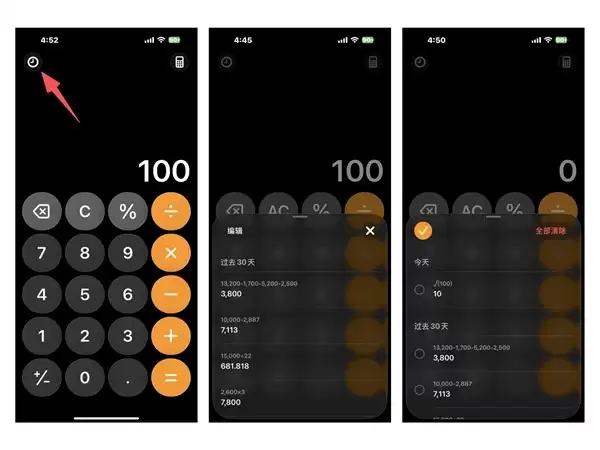
iPhone计算器内置三大隐藏功能:左上角可查看历史运算记录并复制或删除;右上角开启科学模式,支持开方、幂运算、三角函数等;转换模块提供货币、长度、体积等多单位换算,覆盖日常需求。
受2纳米芯片及内存价格飙升影响,2026年下半年各品牌旗舰手机集体涨价。基础版起售价升至5000元左右,Pro系列逼近6000元。内存成本持续上行,部分国产直板旗舰年底或突破万元,高位运行预计持续至2027年底。
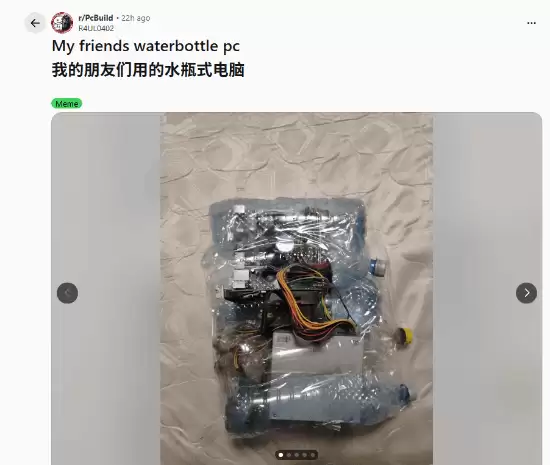
海外硬件圈热议矿泉水瓶DIY主机:用捆扎带将矿泉水瓶拼成框架,裸露安装主板、显卡等硬件。配置入门级,无防尘散热结构,性能有限。安检风险高,易被误判为可疑物品。制作者证实为创意实验,适合短期展示,不适宜长期运行。
绿联于2026年6月14日发布DXP6800Ultra与DXP8800Ultra两款高端NAS,均采用全金属机身、250W电源、8GBDDR5内存、128GB系统盘,配备双万兆网口、双雷电4、PCIe及HDMI2.1接口。DXP6800Ultra搭载酷睿5,售价7599元;DXP8800Ultra搭载酷睿7,售价10999元。
此次SteamDeck用户因新生儿弄脏原装收纳包,联系官方客服询问购买替换包,结果对方免费寄送全新收纳包。快速且周到的服务迅速引发网络热议,网友纷纷称赞,认为此举体现了品牌对用户的真诚态度。
铠侠推出极至瞬速系列第三代固态硬盘四太字节版本,搭载第八代三维闪存,顺序读取每秒一万兆字节,写入每秒九千六百兆字节,支持第五代高速接口,专为人工智能应用与次世代游戏优化,提供海量存储空间,计划于2026年6月底上市。
迈从G98V3机械键盘采用98%配列100键布局,配备可旋转滚轮旋钮及计算器快捷键。搭载自研星斗无线技术,延迟低至0.125毫秒。Gasket悬浮结构配合五层填充,手感一致性佳。10000毫安时电池支持2900小时续航,PBT键帽清晰耐久。冰蓝轴版299.15元,快金轴V3版349.3元。
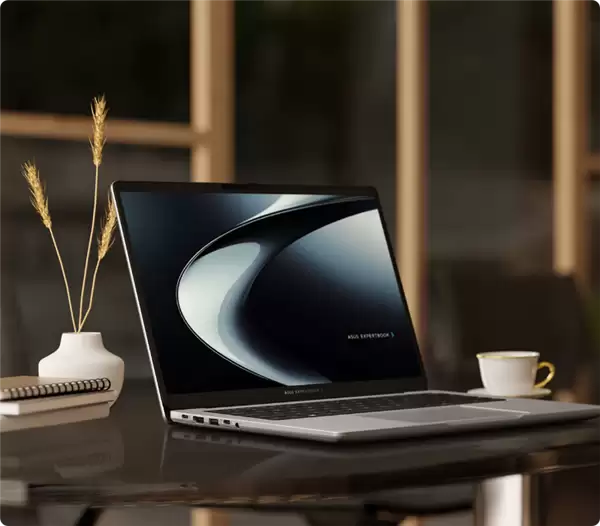
华硕破晓7S锐龙版于2026年6月17日上市,定价2999元。其搭载锐龙AI5330处理器、16GB内存与1TB固态硬盘,配备70瓦时大容量电池及65瓦快充。采用2.5K分辨率144Hz刷新率IPS屏幕,支持180度开合,1.5毫米键程防泼溅键盘,接口齐全,支持指纹识别、Wi-Fi7与蓝牙5.4。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



