

“大模型很能干,但没智能?”两位学者在沪激辩:AI这条路会不会走偏了?
两位学者在沪激辩智能本质:王培认为智能核心是适应性与资源约束,而非模仿人类;徐英瑾指出大模型缺乏内在动机和自知之明。纳思系统具备非公理推理能力,与大模型形成对比。哲学批判并非反对AI,而是另一种拥抱方式。
上周末,一场关于“智能”的深度对话在上海展开。这场名为《智能论》的新书分享会,请来了两位重量级人物:美国天普大学的王培教授,和复旦大学哲学学院的徐英瑾教授。主持人则是上海市科学学研究所的李辉研究员。三个人围绕“什么是智能”“当前AI走到哪一步了”“纳思系统和大模型到底哪里不一样”这些硬核问题,来了一场计算机科学与哲学之间的跨学科碰撞。
我们先从智能的本质说起——这其实是个几十年都没吵明白的问题。
智能的本质:不是像“人”,而是能“适应”
“我们讨论了那么多年智能,连个定义都没统一。”王培教授的开场白很直接。作为《智能论》的作者,以及纳思系统(NARS,Non-Axiomatic Reasoning System)的创立者,他在这本书里提出了一个跟主流完全不同的智能定义——智能的核心,是适应性。
他解释说,就像“仁者见仁,智者见智”,那个“智”,指的就是智能。不同的人看到的智能,本来就不一样。目前业界对智能的定义,大致可以分成两派:一派看行为,比如图灵测试,看机器能不能“骗过”人;另一派看解决问题的能力,比如下棋、考试。但在他看来,这两种定义都有硬伤:“能解决问题和有智能不是一回事,计算器比人心算强得多,但没人说计算器有智能。完全跟人一样,也不是智能的充分条件,图灵自己都说过这一点,只不过大家没注意。”
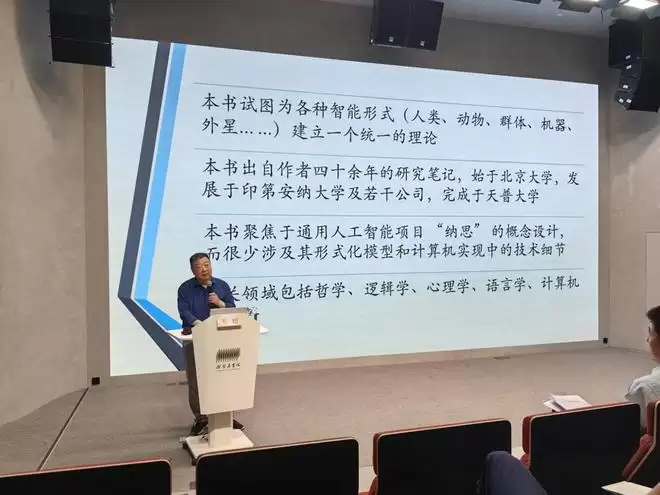
那王培定义的智能,关键在哪?两个词:适应性和资源约束。一个真正的智能系统,必须能根据自己的经验来决定行为,而且是在知识和资源永远不够用的条件下尝试。“我不是要造一个跟人一样的东西,而是要提炼出思维规律,用计算机去实现。实现了这种规律的系统,行为不必跟人一样,因为它的经验本来就和人不一样。”
徐英瑾教授从哲学角度做了补充。他强调王培说的“适应性”,并不仅仅是生物学层面的适应性,目标可以是内生的,也可以是外生的。“现在的GPT、DeepSeek,目标全是外生的——用户问什么它答什么。它不可能产生人意义上的‘反叛’,因为它没有自己的目标。机器坏了不叫反叛,电视机坏了你不会说它反叛了。”
他还用历史故事来说明“手段和目标是会互换的”:隋炀帝修大运河,本来是为了军事目的,结果军事行动烂尾了,运河本身反倒成了目标;《西游记》里的取经,重点根本不在经文,而在经历本身——取经的“经”不是经文的“经”,是经历的“经”。最精彩的,是他拿李后主和刘阿斗做了个对比:“同样是亡国之君,刘阿斗装傻活了很长时间,李后主写了《虞美人》却被杀。但有些人说,李后主在文学史上有地位,刘阿斗什么都没有。人可以为了超越生物性的目标牺牲生物性利益,这是个自由选择的问题,而这是AI目前做不到的。”
当前大模型:聪明的“工具”,但不是“智能”
聊到大模型,两位嘉宾的态度出奇一致——承认它好用,但质疑它离智能还差得远。
王培很坦诚:“大语言模型我现在也在用,虽然我不认为它有智能,但它可以解决好多问题,确实很好用。”他强调,纳思系统和大模型不是竞争关系,“我不认为纳思可以取代大语言模型,它能干的活我干不了;但我能干的活它也干不了。”
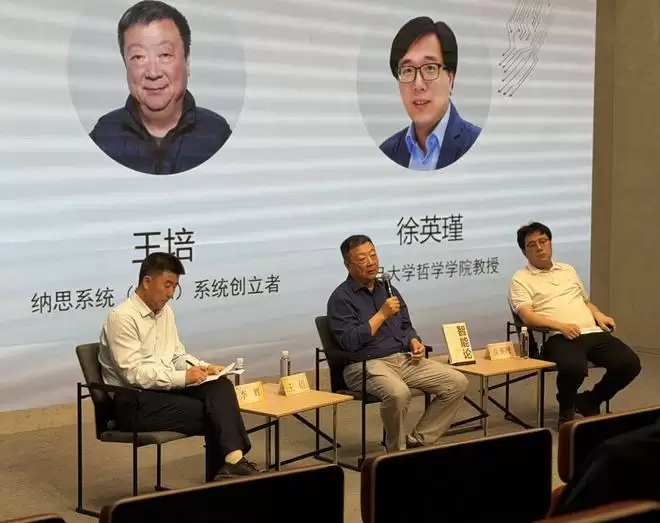
徐英瑾的批评更加犀利。他先承认大模型是“有用的工具”——自己用DeepSeek翻译学术论文效果还不错。但问题在于,这类大模型没有内在的动机结构,也缺乏自知之明。他当场举了个例子:当他问DeepSeek,马斯克的SpaceX是不是已经上市了,DeepSeek坚称“没有IPO”;即使他贴出了BBC新闻的截图,DeepSeek还是说“我深刻反省”,但就是不改。一句话,大模型不知道自己不知道。
徐英瑾还调侃道:“现在AI领域热闹得有点过头了。谷歌买核电站搞算力中心,英伟达相互投资循环,金价暴跌都挡不住AI的吸金效应。但我们连智能运作的基本原理都还没搞清楚,就往里面砸这么多钱,这很危险。”不过他也给了一个务实的判断:大模型能不能用好,关键还是看人。“它确实在倒逼你的批判性思维——如果你连它胡说八道都看不出来,那问题不在AI,在你自己。”
纳思系统:一条少有人走的路
纳思系统是王培坚持了40多年的研究方向。它的核心特征是非公理推理——不承认任何绝对真理,所有前提和结论都可能是错的,但错有程度之分、可信度之别。
王培说:“在纳思系统中,我说的‘对’的意思是:根据以往的经验,它是对的。但我承认,这有局限性,所有结论都可能被未来经验修改。真假是一个量化的度量,不是0和1。”
徐英瑾用了一个非常形象的对比:“纳思像一个犹犹豫豫的人——它会说这个史料少,下面说的不靠谱,你自己要多查查;而大模型则有点像一个信口开河的人——说完就忘,前后矛盾也不在乎。就这点来说,纳思有自知之明,大模型没有。”
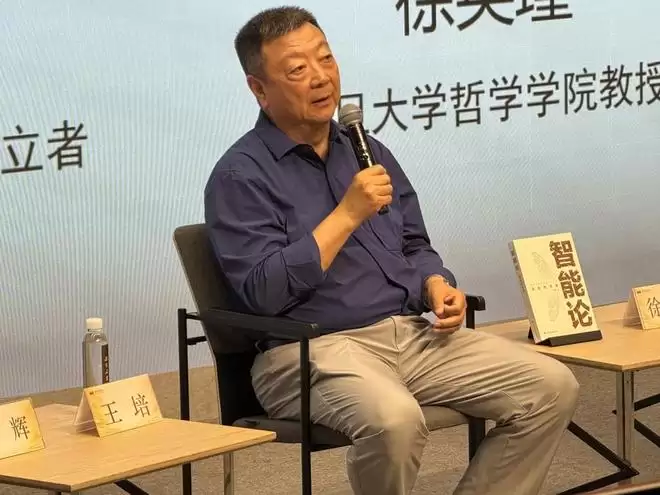
当然,现实很骨感。王培坦言:“托大语言模型的福,绝大部分的科研经费都跑那边去了。”他透露,自己的团队目前也在做工程尝试,将纳思与深度学习、大语言模型结合起来,“两条腿走路”。
活动尾声,主持人李辉的一段话,或许很适合作为总结:“今天的讨论有一个焦点——对AI,我们是拥抱还是批判?我想说,人工智能是我们发展的重点,这毫无疑问,但哲学批判本身就是哲学的基本精神,批判不是反对,恰恰是拥抱人工智能的另一种方式。”
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
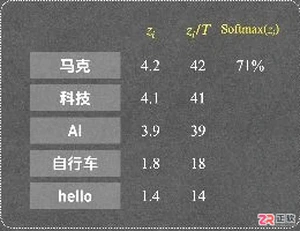
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
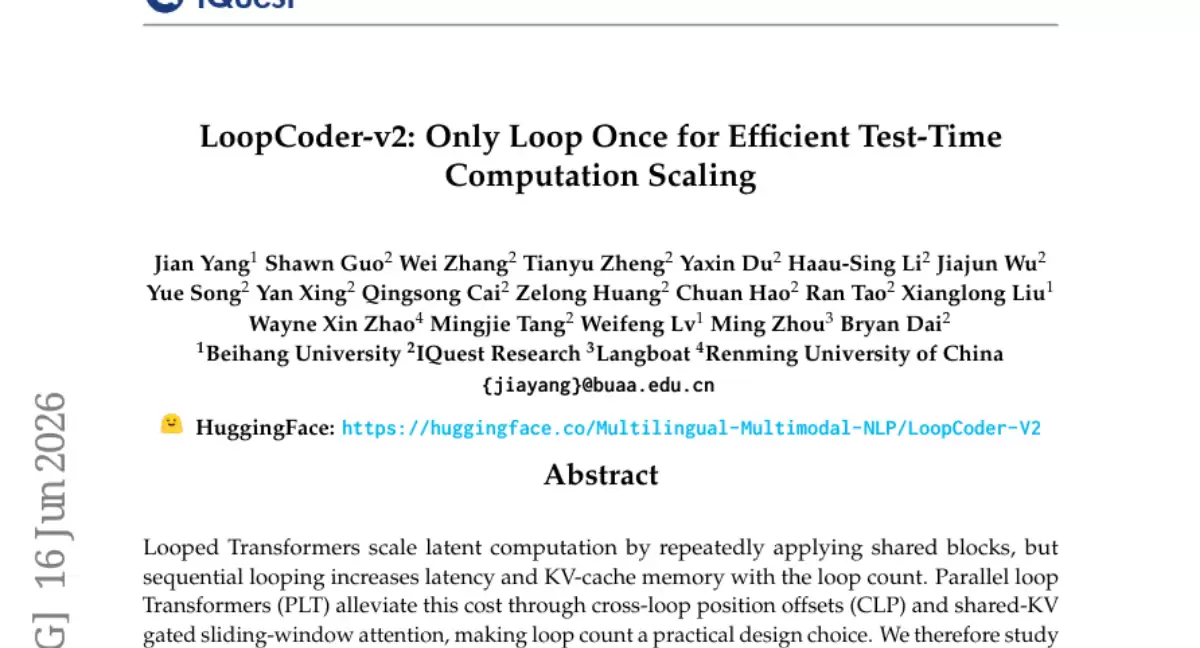
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
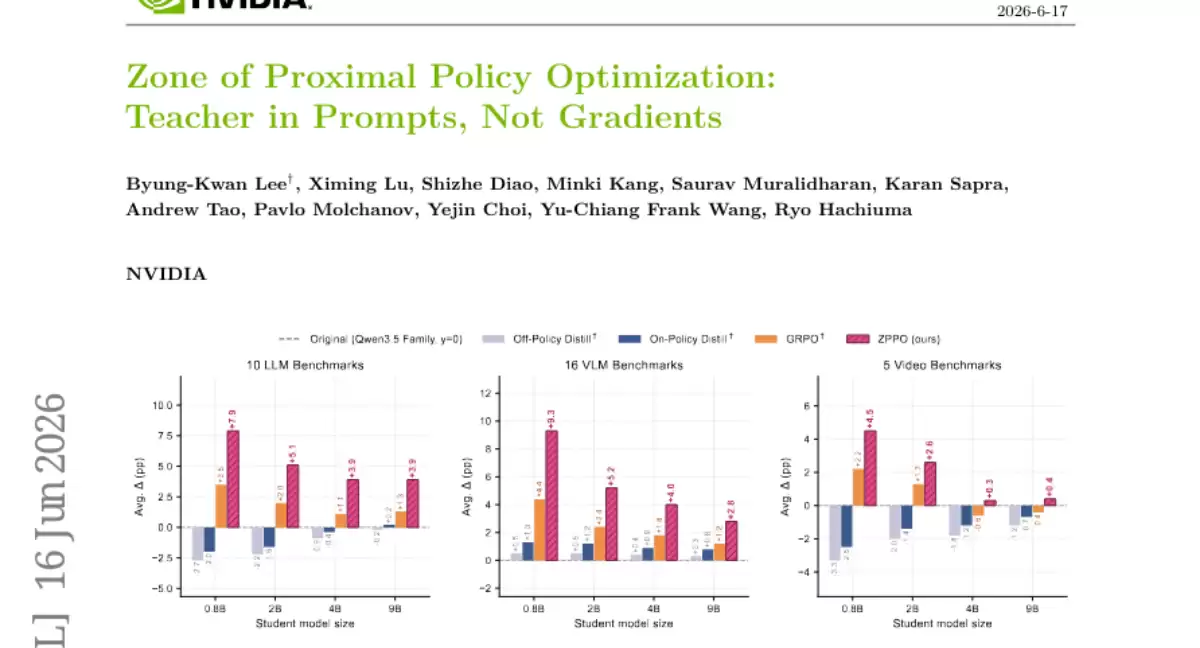
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
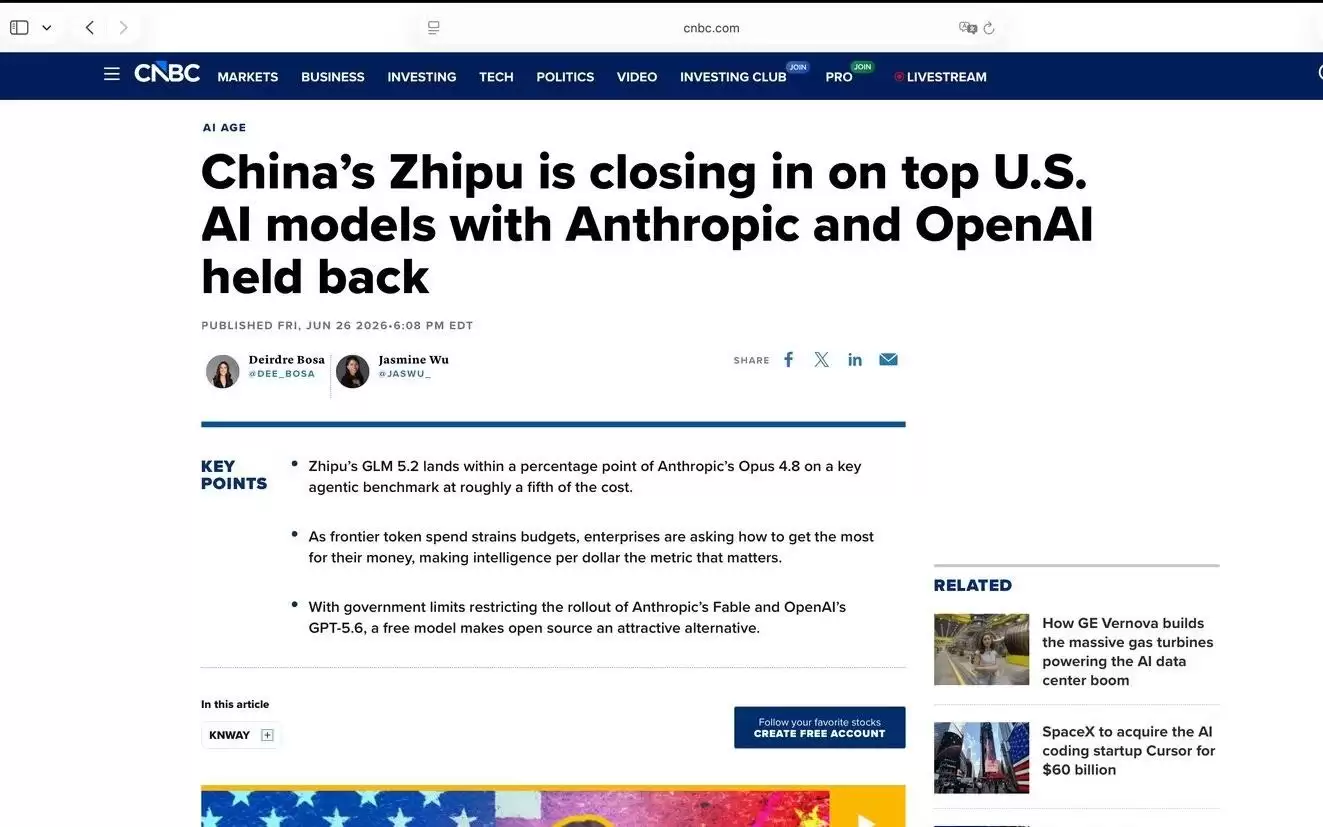
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
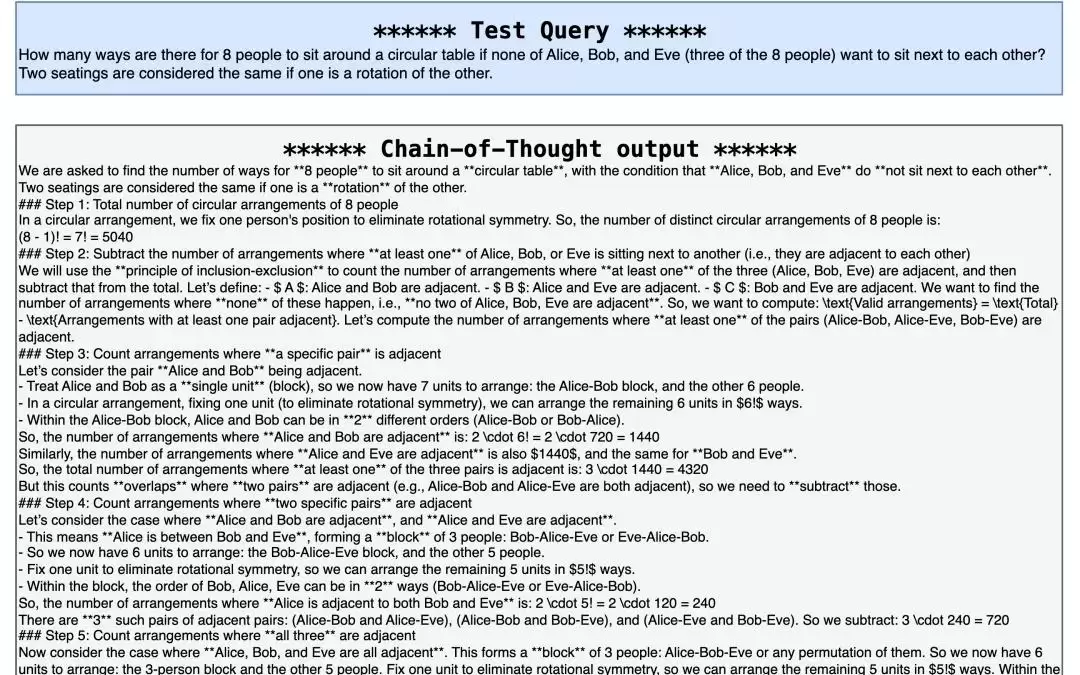
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
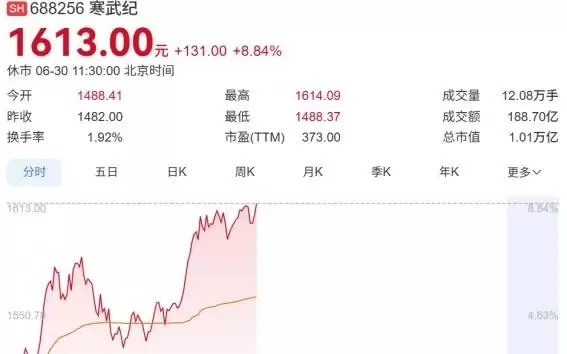
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



