

Token去哪了?大量用户质疑智谱GLM:存在词元泄露和缓存计费问题
用户质疑智谱GLM模型在长上下文高并发场景下出现词元泄露与缓存计费异常,表现为输出混杂无关代码、缓存命中率异常高且计费不透明。官方承认曾因KVCache竞态条件导致输出故障,但未确认数据泄露。争议仍在发酵。
先说几个关键点:最近大量用户集中反馈,说GLM系列模型在长上下文、高并发调用场景下,出现了异常缓存命中、上下文混杂,甚至计费不透明等问题。更有人直接怀疑,系统内部可能存在词元(Token)串扰——说白了,就是某个用户的上下文,被错误混进了另一个用户的推理过程。
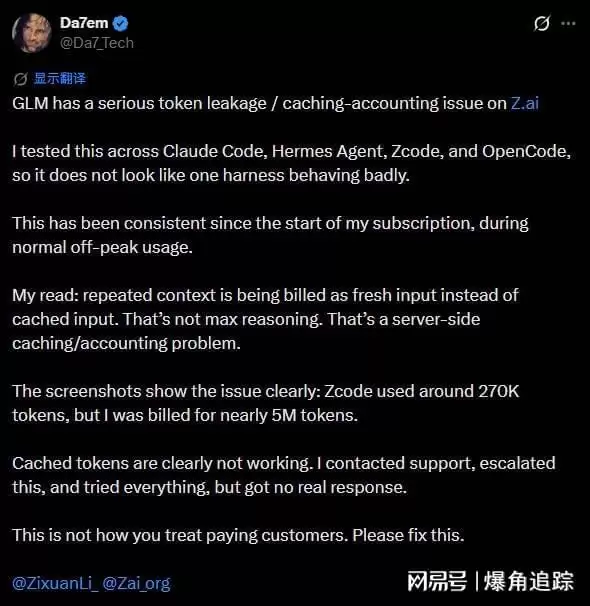
这场争议的起点,其实不在账单上。
今年早些时候,就有开发者发现,在用GLM-5写代码时,模型偶尔会蹦出一堆无意义字符、重复内容,甚至突然插入与当前任务八竿子打不着的代码片段和思维链内容。上下文一长,比如超过几万个Token之后,这种现象就更频繁了。
讨论越闹越大,不少人开始怀疑,这根本不是模型“幻觉”那么简单,更像是推理系统底层的缓存机制出了幺蛾子。有用户说,自己在模型输出里,明明白白看到了别的项目的代码片段、文件路径、函数名,甚至完全无关的技术讨论内容——这让人很难不怀疑,不同用户的数据是不是在推理过程中搅到了一起。
相关话题迅速引爆。原因很简单:现代大模型为了省算力,普遍会用KV Cache(键值缓存)技术。用大白话说就是,用户输入大量上下文后,系统把算过的结果缓存下来,下次再推理时就不用重复计算,能大幅降低GPU负载、减少响应时间。
与此同时,很多AI平台也顺势推出了“缓存计费”机制。只要新请求和之前缓存的内容高度一致,就按远低于正常输入Token的价格收费。这对开发者来说,意味着API成本能砍掉一大截。
问题偏偏就出在这儿。
有开发者反映,自己明明没反复提交大量内容,账单上却出现了异常高的缓存命中率;还有人发现,同样的请求,不同时间调用时,缓存Token数量起伏不定,根本说不清计算逻辑。于是大家开始质疑:这个缓存统计到底准不准?用户真的享受到了宣传中的缓存优惠吗?
更进一步,有人猜测:如果缓存系统在高并发场景下出错,影响的可不只是模型输出,计费结果也可能跟着跑偏。换句话说,系统如果错误地把某些内容判定为缓存命中,用户最终付的钱和实际消耗之间,就可能出现偏差。
不过话说回来,这些目前还都是开发者社区里的讨论,并没有公开证据能证明Z.AI存在系统性的错误收费行为。
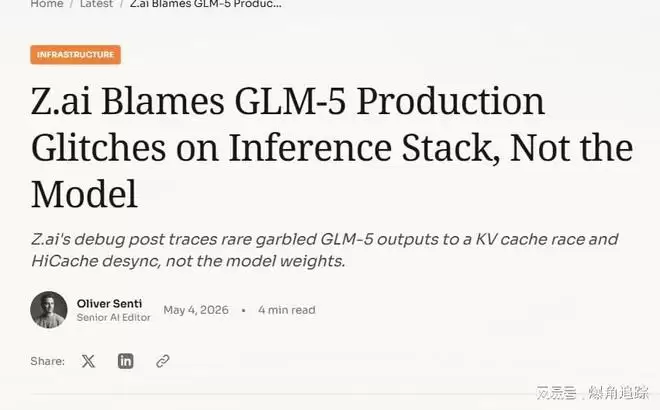
值得注意的是,今年4月,Z.AI发过一份技术复盘,承认GLM-5在高并发生产环境中确实出现过异常输出。根据当时披露的信息,问题最终定位在推理系统的KV Cache竞态条件和缓存同步错误,并非模型训练本身的问题。官方表示,在极端负载下,缓存数据可能出现读取顺序异常,导致乱码、重复输出、错误内容等,相关问题已经完成修复。
这份说明虽然没有直接承认用户数据泄露,但至少从侧面印证了一点:缓存系统确实出过影响模型输出的底层故障。
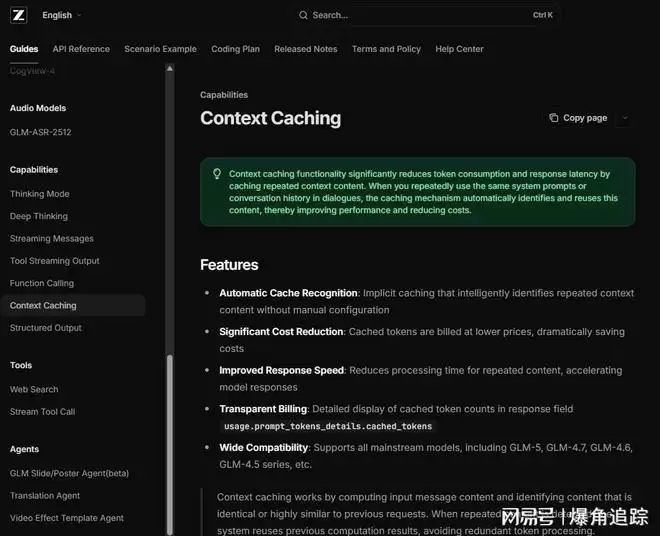
与此同时,Z.AI最新文档里对缓存机制的描述也相当谨慎。文档显示,缓存功能目前仍处于开放测试阶段,具体的命中规则、缓存保留时间、触发条件都没完全公开。官方只说了:如果请求命中缓存,费用按正常价格的五分之一算。
正因为底层机制不透明,开发者很难独立验证每一次缓存命中是否准确,这个争议才会持续发酵到今天。
说到底,“数据泄露”和“缓存故障”本质上是两码事。如果只是缓存同步错误导致模型输出乱码或上下文混杂,那属于推理基础设施层面的问题;如果能证明一个用户的私有内容被完整暴露给了另一个用户,那就上升到了数据安全事件的高度。就目前公开的讨论来看,后者还没有拿到确凿证据。
随着大模型上下文越做越长,缓存优化越来越复杂,推理系统已经成了决定产品稳定性的关键一环。很多人只盯着模型参数规模、排行榜成绩、推理能力这些指标,却容易忽略底层缓存、调度系统和计费系统同样可能成为风险来源。
到这会儿,关于“词元泄露”和“缓存计费异常”的争议还在持续发酵,社区里的讨论远没到收场的时候。
对于智谱来说,光是修好技术问题恐怕还不够。怎么提高缓存机制的透明度、给出更详细的计费解释、重新建立开发者的信任,才是这场风波真正需要解决的核心问题。
Anthropic的Fable5模型为换取解禁新增安全分类器,导致编程等核心能力被降级至旧模型处理,用户仅约50%额度可用。开发者批评该版本能力已被“阉割”,并非完整回归。此举反映美国AI监管转向能力可用但需动态管控的模式。
GPT-5.6全量上线,分Sol、Terra、Luna三档,覆盖复杂推理、日常办公和高频低价场景。Fable5因安全隐患暂停后恢复,与GPT-5.6Sol能力各有胜负,但后者价格更低。OpenAI通过分层定价和产品整合,意图缓解巨额亏损并抢占市场。
Agnes发布新一代文本模型Agnes-2.5Flash及桌面端产品AgnesCode,聚焦编程场景,针对代码理解、多文件修改、复杂推理等优化。模型在多项基准测试中提升显著,旨在通过更强能力与更低成本,让AI成为日常工作中的协作伙伴,而非简单问答工具。
7月24日,AnySearch 在北京搞了一场开发者沙龙,创始人兼CEO薛冠群在活动现场正式对外发布了“AnySearch 学生与开发者成长计划”(AnySearch Student & Developer Program)。这个计划面向全球的学生和开发者开放,目的很明确:通过开放AI搜索基础设施,
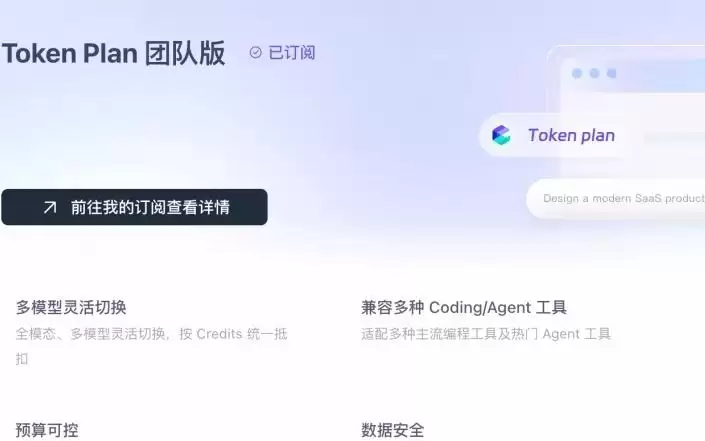
5月11日,阿里云正式推出了团队版Token Plan服务。这项服务集成了包括Qwen3.6、Kimi-K2.6、GLM-5.1、Wan2.7在内的十多款多模态大模型,其核心目标在于解决企业规模化使用AI订阅服务的难题。通过支持多坐席分配与管理,并提供标准、高级、尊享三档灵活套餐,企业可以根据自身需
迅策发布全球首款TokenOS操作系统TokenONE,旨在将企业非标准化数据转化为AI可用的标准化Token,驱动业务决策。该系统通过标准化流程大幅缩短AI落地周期,并构建多维定价体系,使Token价值与业务收益深度绑定。迅策商业模式转向“Token付费+价值分成”,目标是与行业龙头共建垂直领域“Token工厂”,推动AI在关键领域的工业化落地。
智通财经APP获悉,AI行业正式从“补贴烧钱”跨入“商业化定价时代”。被市场称为“Token第一股”的迅策(03317)迎来利好!叠加近日国泰君安国际已将目标价大幅上调至245港元/股。迅策有望成为AI“千亿俱乐部”的新成员。 中国AI弯道超车:价格优势构筑竞争力 风向正在转变。日前,人工智能公司A
从“动口”到“动手”:OpenClaw如何将AI推入“执行时代”? 文|洞见新研社 3月的最后一周,OpenClaw的GitHub社区上演了一出反转剧。往日里忙着报错的开发者们这次成了观众,主角换成了来自蚂蚁、天融信、360等机构的安全研究员,他们密集披露了数十个涉及远程接管、信息泄露的高风险漏洞。
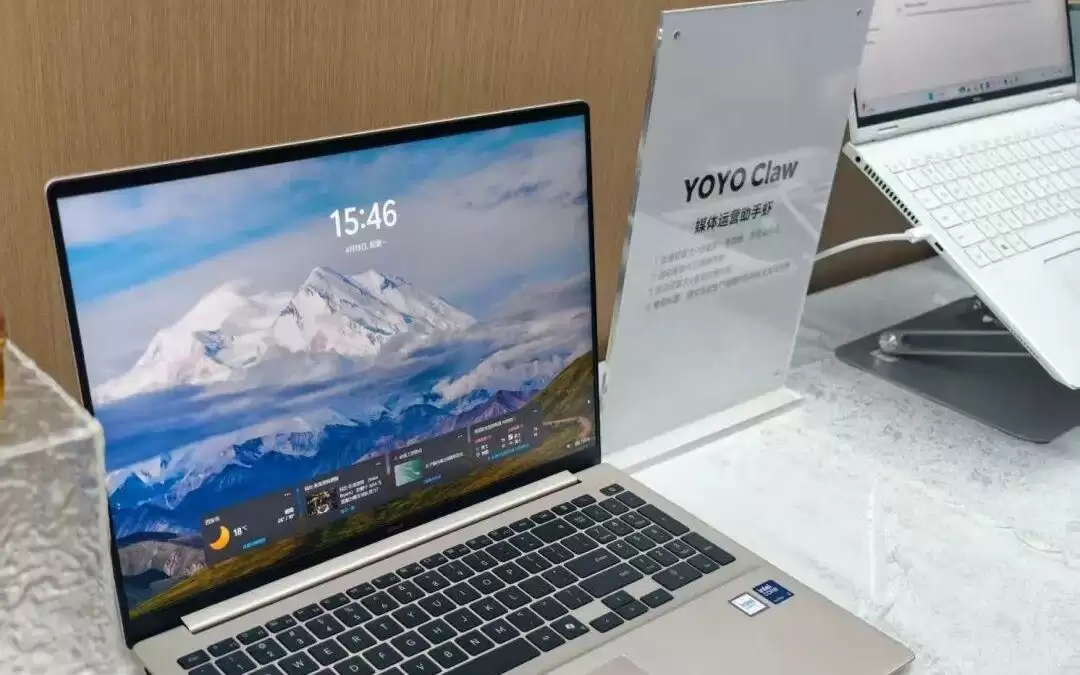
2026.04.14 先说一个核心判断:未来的竞争,本质上是对用户注意力的争夺。谁能更高效地连接信息与需求,谁就能在市场中占据先机。 这张图揭示的,正是这种连接效率的底层逻辑。它清晰地展示了从数据源到价值呈现的完整链路,每一个环节都环环相扣。你猜怎么着?其中任何一个节点出现迟滞或偏差,最终输出的效果
fork()是linux和其他unix-like系统中非常重要的一个系统调用,它用于创建一个新的进程,这个新的进程是当前进程的副本,称为子进程。子进程会获得父进程代码、数据、堆、栈等内容的副本,但两个进程拥有不同的进程id和一些其他资源,比如打开的文件描述符。下面是fork()函数的基本用法和注意事项:函数原型c#includepid_tfork(void);登录后复制返回值如果fork()在父进程中调用成功,则返回新创建的子进程的进程ID。如果fork()在子进程中调用成功,则返回0。如果fork()调





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



