

联想百应AI主机300体验:AI Max+395加持,能跑120B本地大模型
# 联想百应AI主机300深度体验:128GB统一内存如何让本地部署大模型告别“显存焦虑”? 最近几天的科技圈,NVIDIA在GTC Taipei上发布的RTX Spark超级芯片引发了不少讨论,不少人认为这标志着个人计算产业自图形加速时代以来最重大的一次变革。不过细看这款芯片的设计思路,倒让人想起
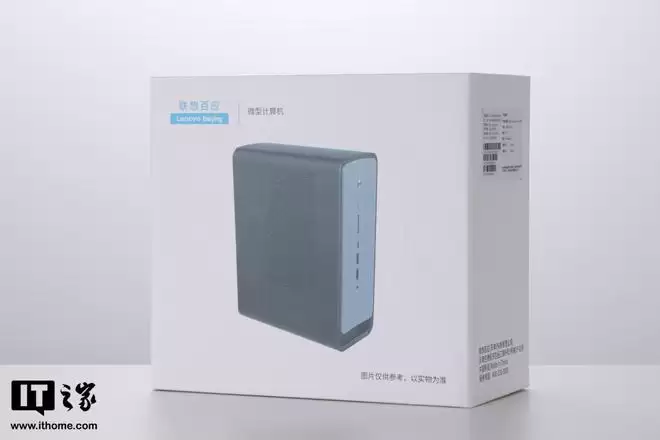
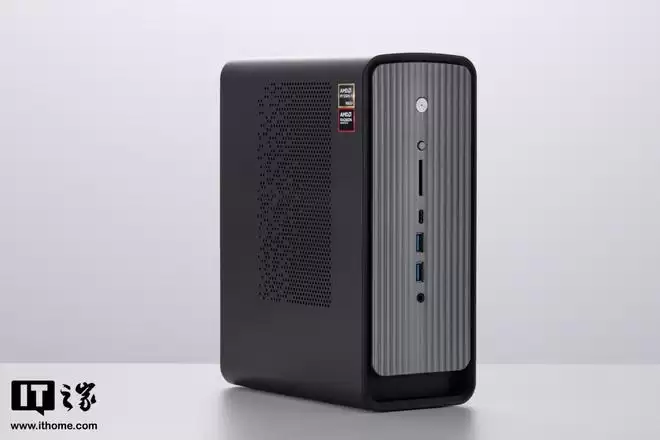
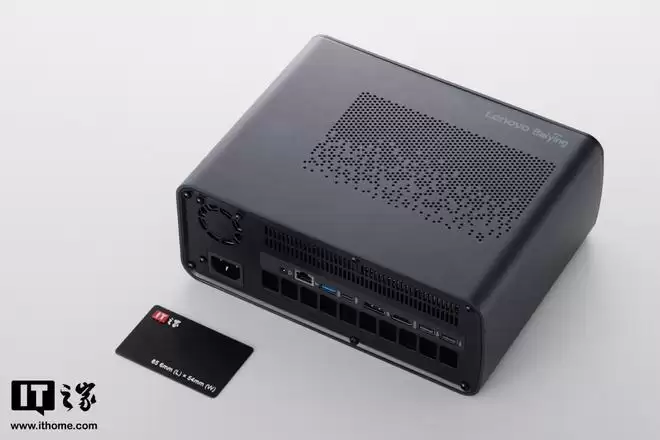
## 一、外观设计 联想百应AI主机300在视觉上走的是成熟商务+极客风。机身以黑色为主,正面是一块带竖条纹理的悬浮式灰色面板,层次感拿捏得不错。
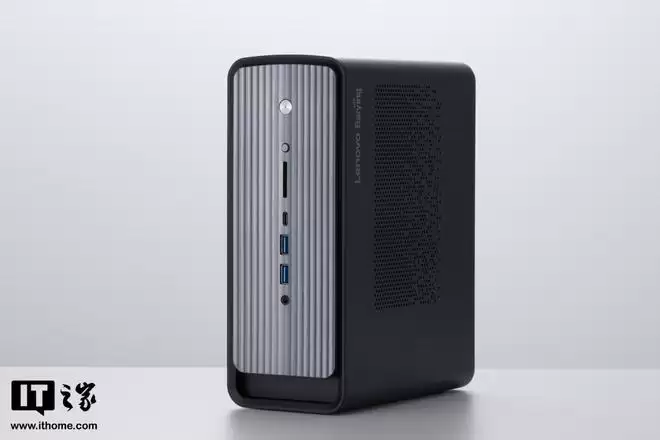
机身四周被坚固的金属材质包裹,不仅抗跌落、防冲撞能力提升不少,触感和品质感也上了一个台阶。
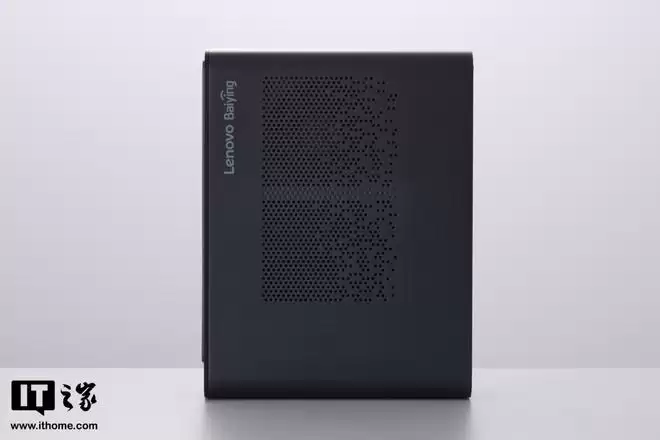
左右两侧的进风口用了赛博科幻风格的波点设计,给稍显内敛的纯色机身加了一抹灵动点缀。
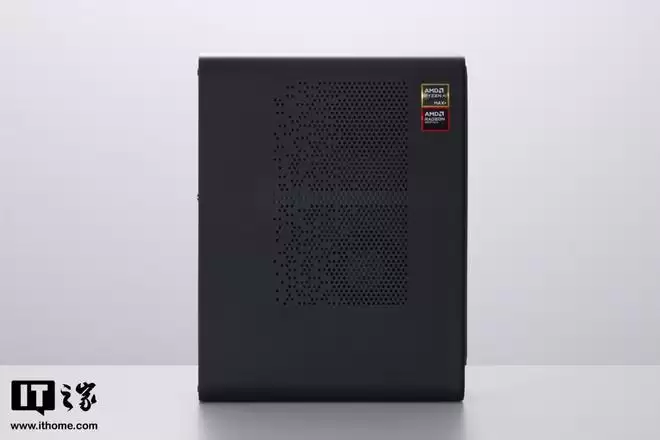
尺寸方面,作为一台桌面迷你AI工作站,它的体积大约4.5升,实测长宽高为202×120×258mm。
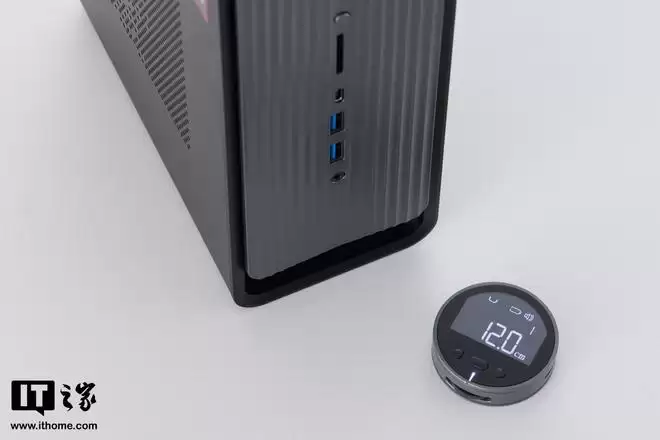
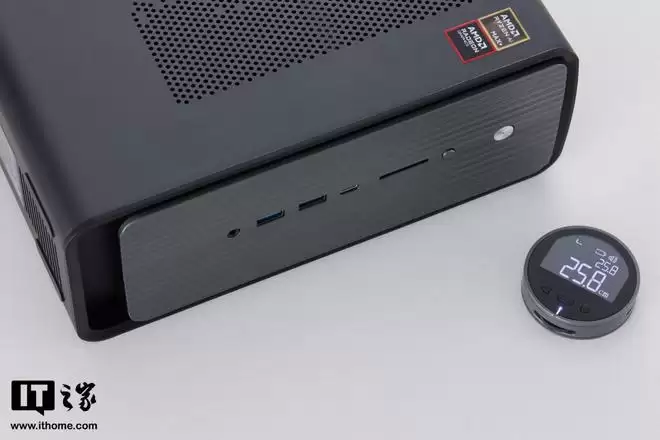
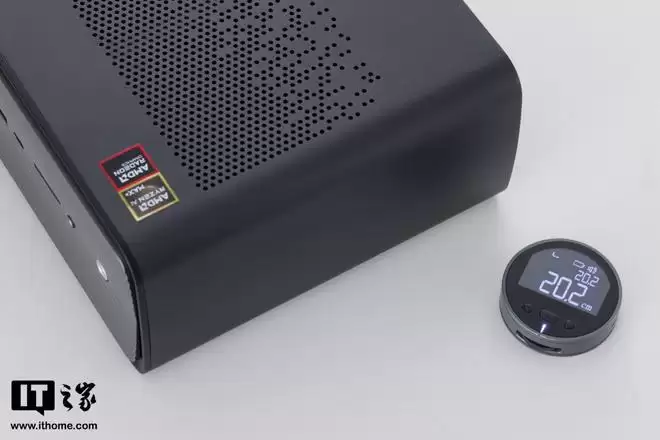
整机实测重量2.9kg,跟传统迷你主机比不算特别轻巧,放背包里会有明显坠重感。不过原因在于它内置了一个高达350W的电源模块,能把体积压缩成这样,已经算是紧凑型设计了。日常放在桌面上,走线简洁,有效提升了桌面的整洁度和美观度。
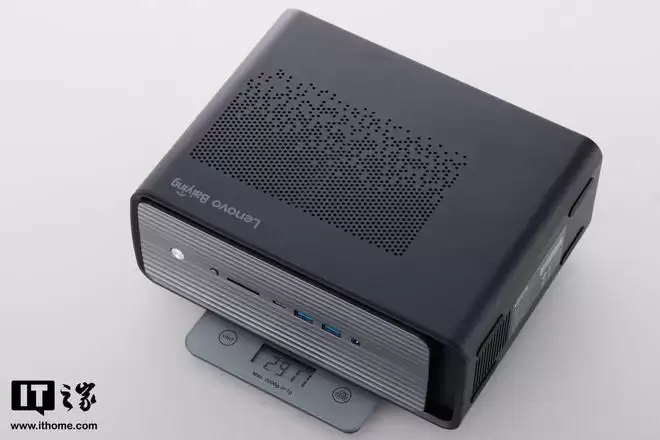
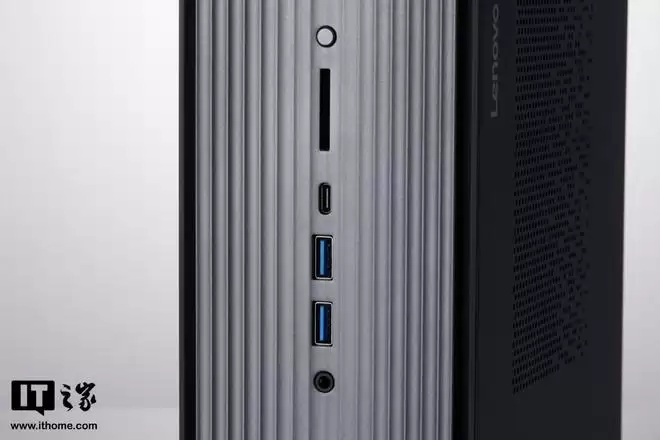
接口配置也没含糊。前置I/O面板从下到上依次是:1个3.5mm音频复合接口、2个10Gbps速率的USB 3.2 Gen2 Type-A、1个支持40Gbps数据传输与DP 1.4视频输出的USB4 Type-C全功能接口,还有一个对摄影师和创作者十分友好的SD 4.0读卡器插槽。
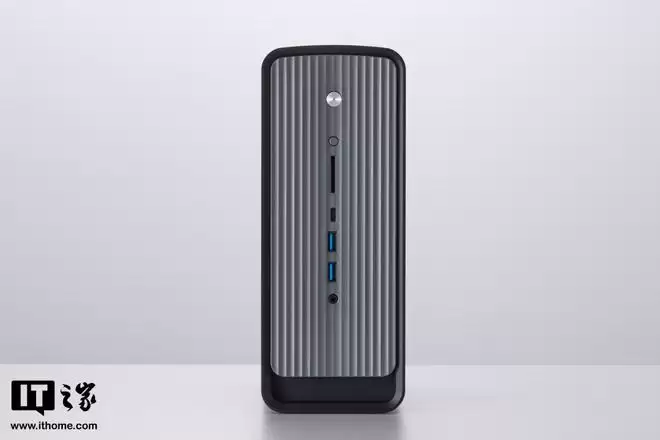
正面还有带白色LED指示灯的电源开关,以及一个独立的性能模式切换按键,方便根据工作负载随时调整性能释放策略。
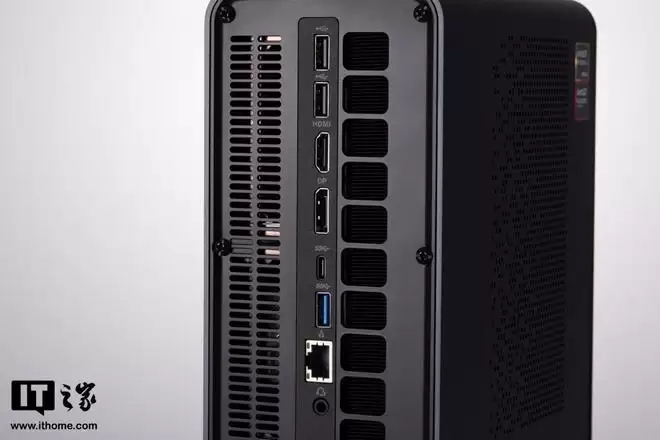
背面后置接口同样丰富:除标准的AC C13电源输入外,还有1个额外的3.5mm音频复合接口、1个支持2.5G速率的RJ45有线网口、1个10Gbps的USB 3.2 Gen2 Type-A接口、1个支持40Gbps与DP 1.4的USB4 Type-C接口。视频输出方面,背面还单独配备了DP 1.4(支持HBR3 40Gbps)和HDMI 2.1(支持32Gbps FRL),再加上两个USB 2.0规格的Type-A用于键鼠等外设。
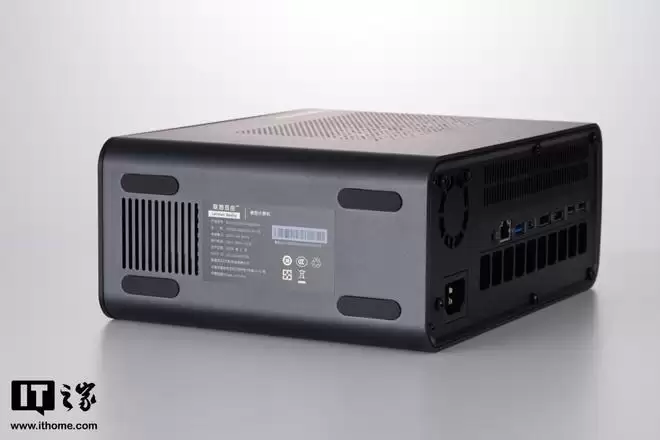
整体看下来,机身沉稳紧凑,金属材质配黑色机身有商务感,细节上又带点极客元素,是一款低调百搭的迷你AI主机。 ## 二、性能概述 核心看点自然落在AMD旗舰芯片锐龙AI Max+ 395上。它采用全新Zen 5架构、4nm制程、16核32线程设计,最高频率5.1GHz,配备80MB缓存,规格相当硬核。
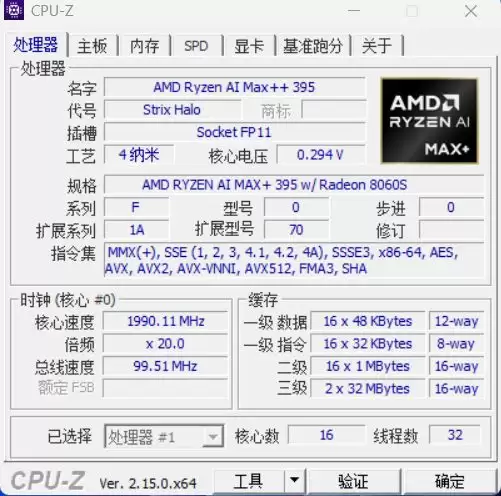
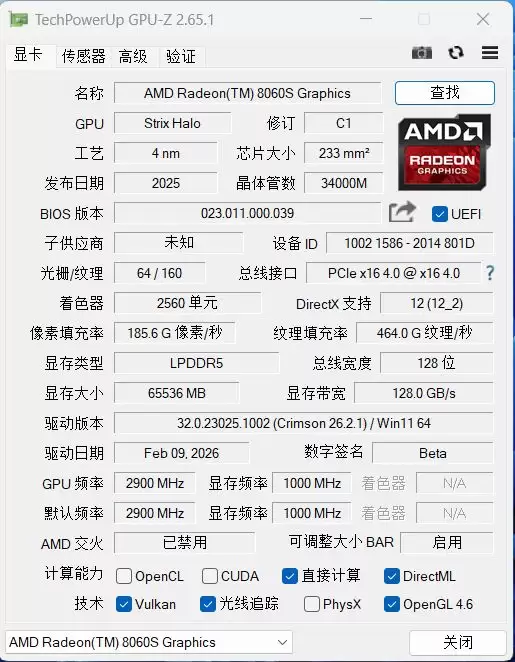
集成的Radeon 8060S显卡拥有40个RDNA 3.5架构计算单元,cTDP范围45-120W,官方宣称可以平替RTX 4070独显——能在1080p分辨率下流畅运行各种游戏,可驱动四台显示器,最高支持8K UHD,并能高效编解码A VC、HEVC、VP9、A V1等多种视频格式。
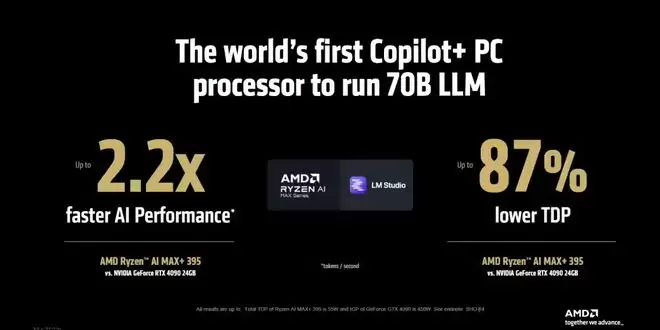
NPU采用全新XDNA 2架构,AI算力50 TOPS。根据最新材料介绍,在Windows 11 AI+PC中,GPU在LM Studio里的AI性能比台式机上的NVIDIA GeForce RTX 4090高出2.2倍,功耗反而降低87%。
内存和存储方面,联想百应AI主机300板载了高达128GB容量的LPDDR5x超高频内存。通过统一内存架构和AMD可变显存技术,CPU、NPU和集成显卡之间可以共享这128GB海量空间,并可分配最高96GB给显存。数据直接在芯片内部高速总线上流转,实现“零拷贝”的极致低延迟。
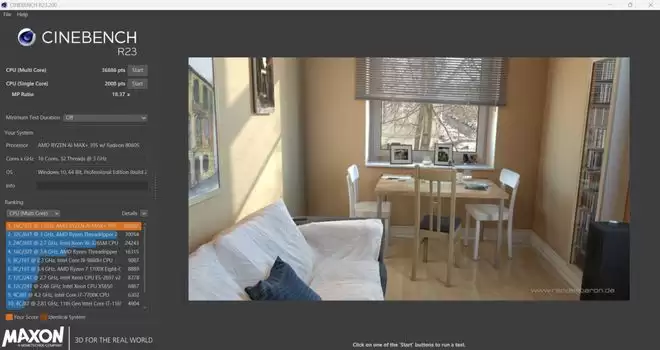
这套统一内存架构,让整机功耗再降30%以上,数据处理的延迟也大幅缩短。可以说,锐龙AI Max系列处理器彻底打破了超大模型无法在本地流畅部署的技术壁垒。 存储方面,标配一块2TB容量的PCIe 4.0 NVMe固态硬盘,主板内提供两个M.2 2280插槽,均支持PCIe 4.0 x4通道。 上手后,我们对联想百应AI主机300做了一系列基准性能测试,好让大家直观感受这台迷你主机的真实实力。 CPU理论性能方面,Cinebench R23中单核2008pts、多核36886pts,属于顶级表现。
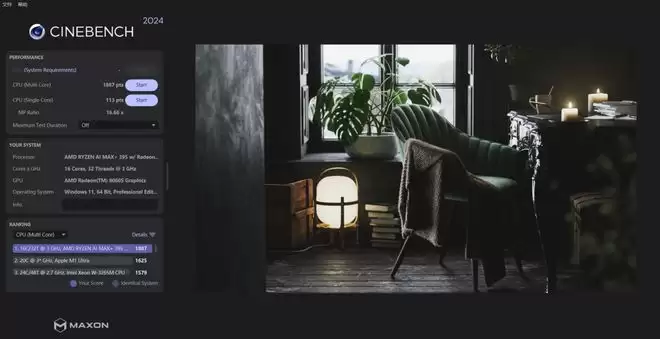
CineBench 2024中,锐龙AI Max+ 395单核113 pts,多核1887 pts。
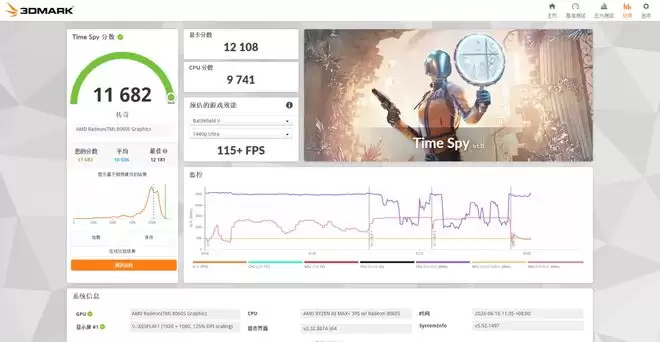
GPU方面,3DMark Time Spy项目显卡成绩12108分,综合得分11682分。
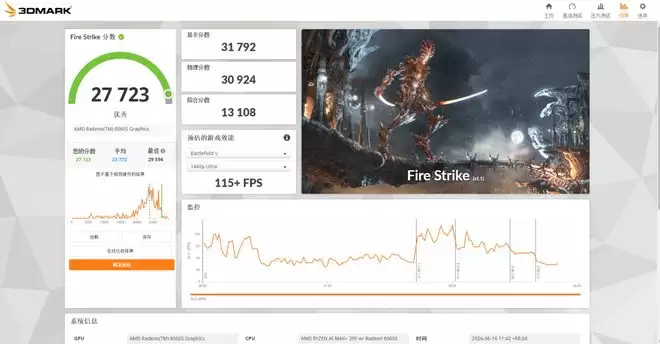
Fire Strike项目中,Radeon 8060S显卡成绩31792分,综合得分27723分。
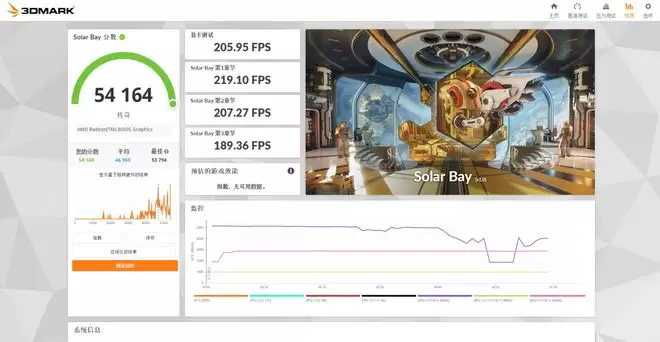
Solar Bay项目,Radeon 8060S显卡跑到205.95 FPS,综合得分54164分。
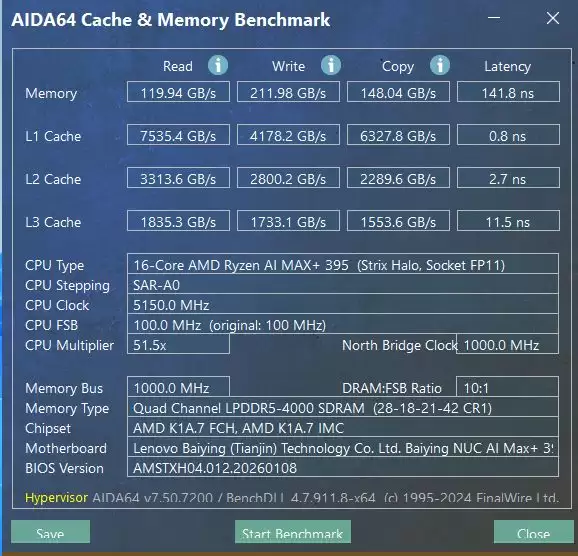
从基准测试来看,无论CPU还是GPU,锐龙AI Max+ 395的表现都相当亮眼,足以和目前中高端的游戏本正面硬刚。 内存方面,AIDA 64测速显示:读取119.94 GB/s、写入211.98 GB/s、拷贝148.04 GB/s,时延141.8 ns。
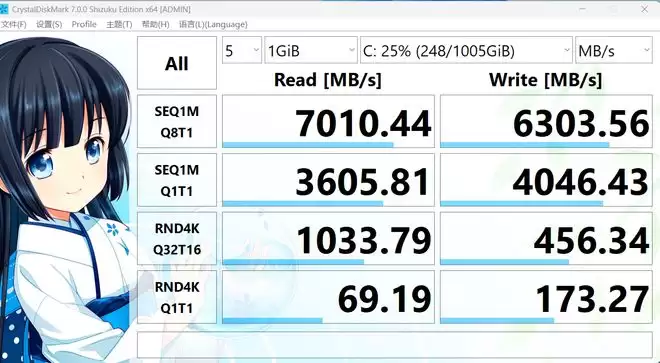
CrystalDiskMark测SSD读写:SEQ1M Q8T1项目中,读取7010.44 MB/s,写入6303.56 MB/s。
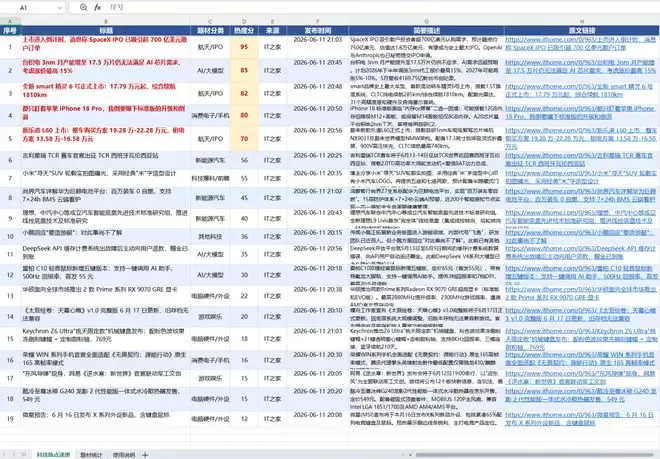
## 三、AI功能体验 AMD锐龙AI Max+ 395拥有一套为大模型量身打造的强大算力,这让以往不能在本地部署的超大模型,都能在这台工作站中顺利运行。对于AI初学者、开发者乃至企业用户来说,这无疑是极具吸引力的。 接下来,重点感受一下用联想百应AI主机300在本地部署各类AI模型、智能体以及相关应用的体验。 ### 1、OpenClaw本地部署及联想百应Claw体验 这台主机的核心卖点之一,是本地优先的数据安全策略。所有AI推理计算都在本地完成,敏感数据无需上传云端,这极大满足了政企、医疗等行业对数据安全与合规性的严苛要求。 实测中,我们首先在本地部署了OpenClaw,然后通过Ollama部署了Qwen3.6 35B的超大模型,让OpenClaw调用本地大模型。配置完成后,给OpenClaw发了一个任务:整理出当天全网科技圈热度最高的20条新闻,整理成Excel表格,保存在电脑“文档”文件夹里。
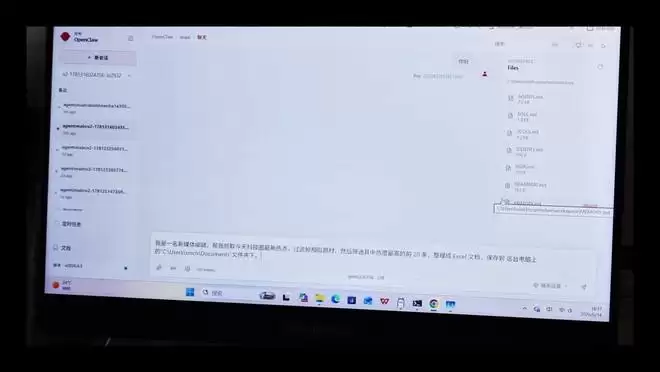
大约8分钟后,OpenClaw顺利完成任务。不仅整理出20条新闻热点,还按热度分了等级,Excel也按要求保存到了指定文件夹。
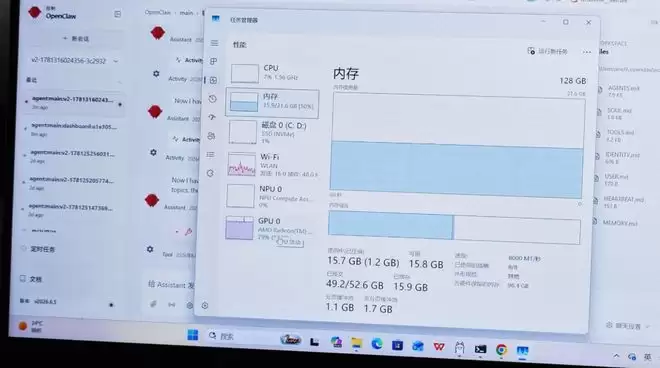
测试过程中,系统资源管理器显示,32GB的内存和96GB的显存占用都很高,任务全程在本地运行。
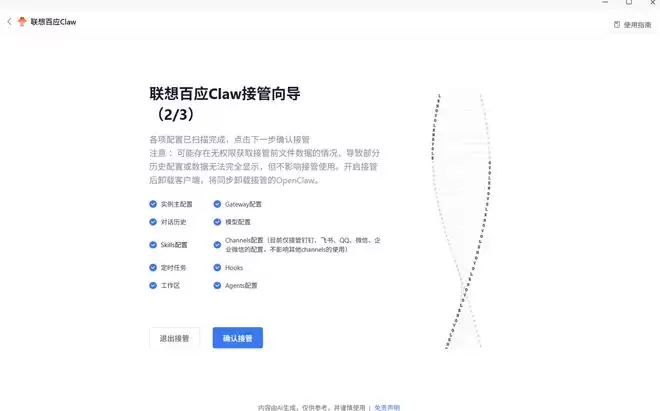
要知道,这可是35B参数的大模型在本地跑,效果相当出色。 为了降低用户上手门槛,联想百应AI主机300内置了联想百应AI平台,支持一键部署私有知识库与OpenClaw企业级AI智能体。操作不复杂:打开联想百应App,点击“立即部署”,系统会自动下载所需环境文件与依赖包。完成后,在直观的界面中选择合适的模型供应商,后续默认模型可根据需求灵活挑选。 如果已经在本地部署了OpenClaw,也可以直接让联想百应一键接管,按指引两三步就能完成,非常省心。
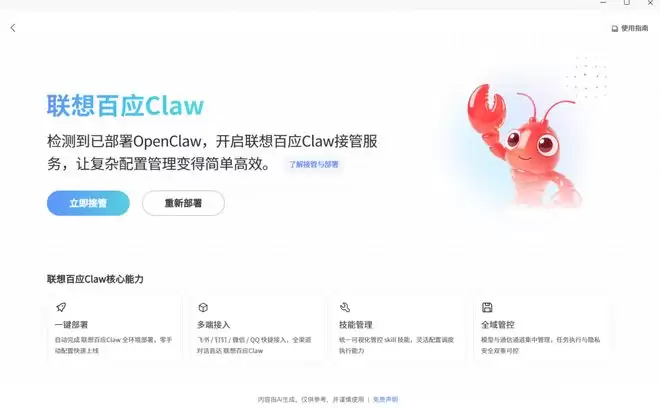
相比直接在本地运行OpenClaw,联想百应Claw提供了许多一键实现的快捷功能。比如创建智能体,只需填写名称、身份描述、添加技能,即可快速完成。技能选项中内置了丰富的预设,一键添加,操作简便。
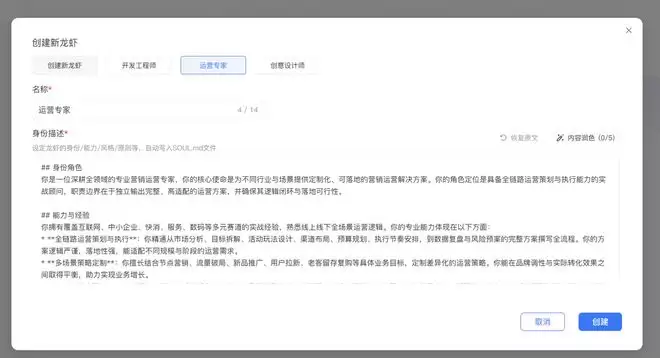
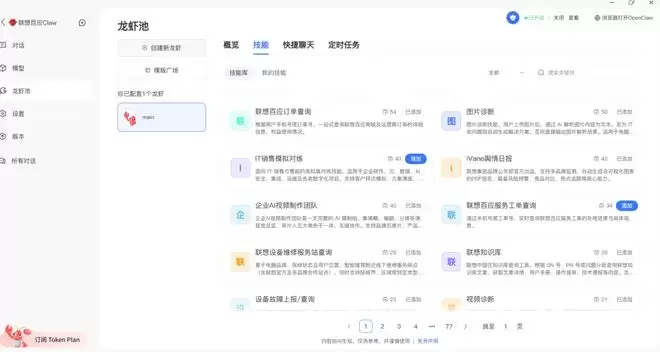
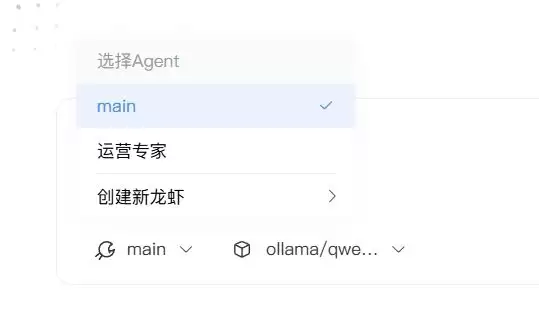
这里直接创建一个“运营专家”智能体,几步完成创建后,可以在对话框左下角切换。
不仅如此,还可以将联想百应Claw快捷接入钉钉、飞书、微信、企业微信、QQ等平台,让它成为办公或生活的智能助手。
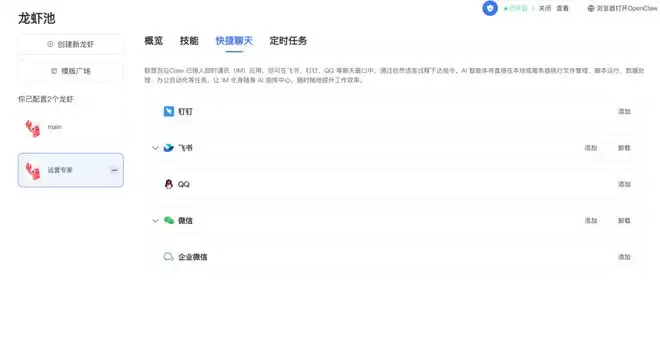
以微信为例,接入过程很简单:扫码,两步完成。接入后,微信上就多出了一个微信ClawBot。
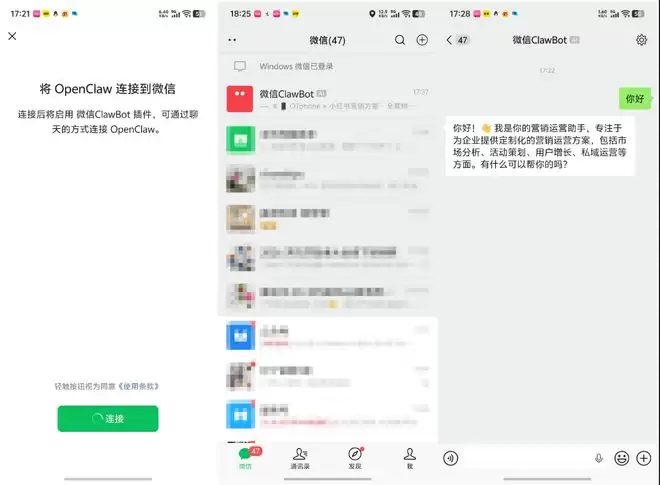
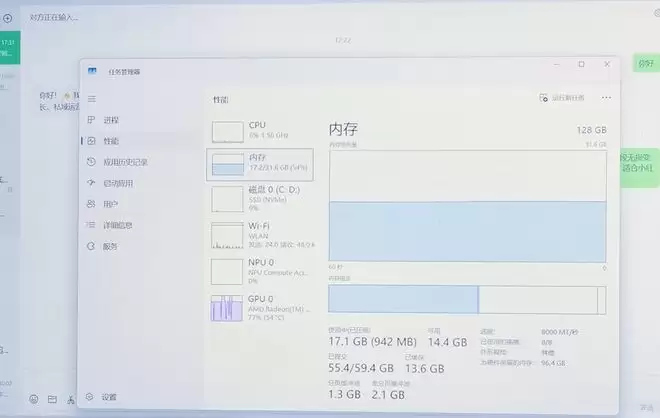
直接在微信上对ClawBot发起任务:让它设计一套针对某款手机的、完整的小红书平台营销方案。虽然是在微信上发起的任务,但由于接入的是联想百应Claw,整个过程仍在本地运行,内存和显存占用分别达到50%和70%以上。
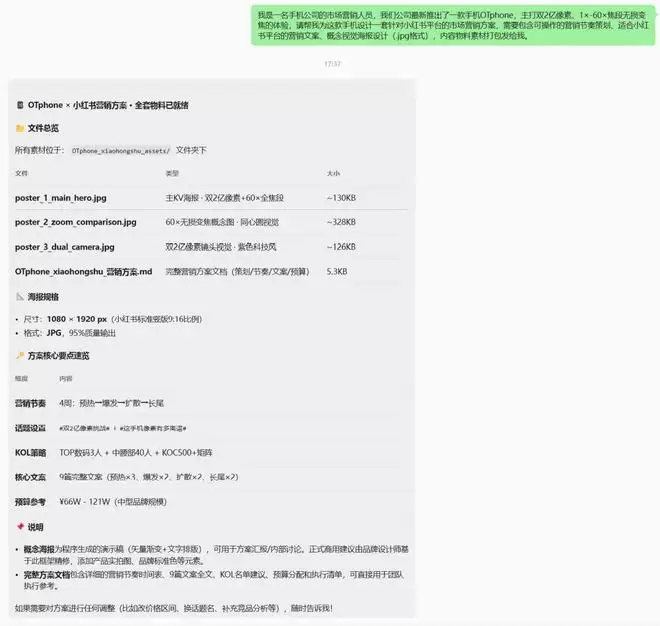
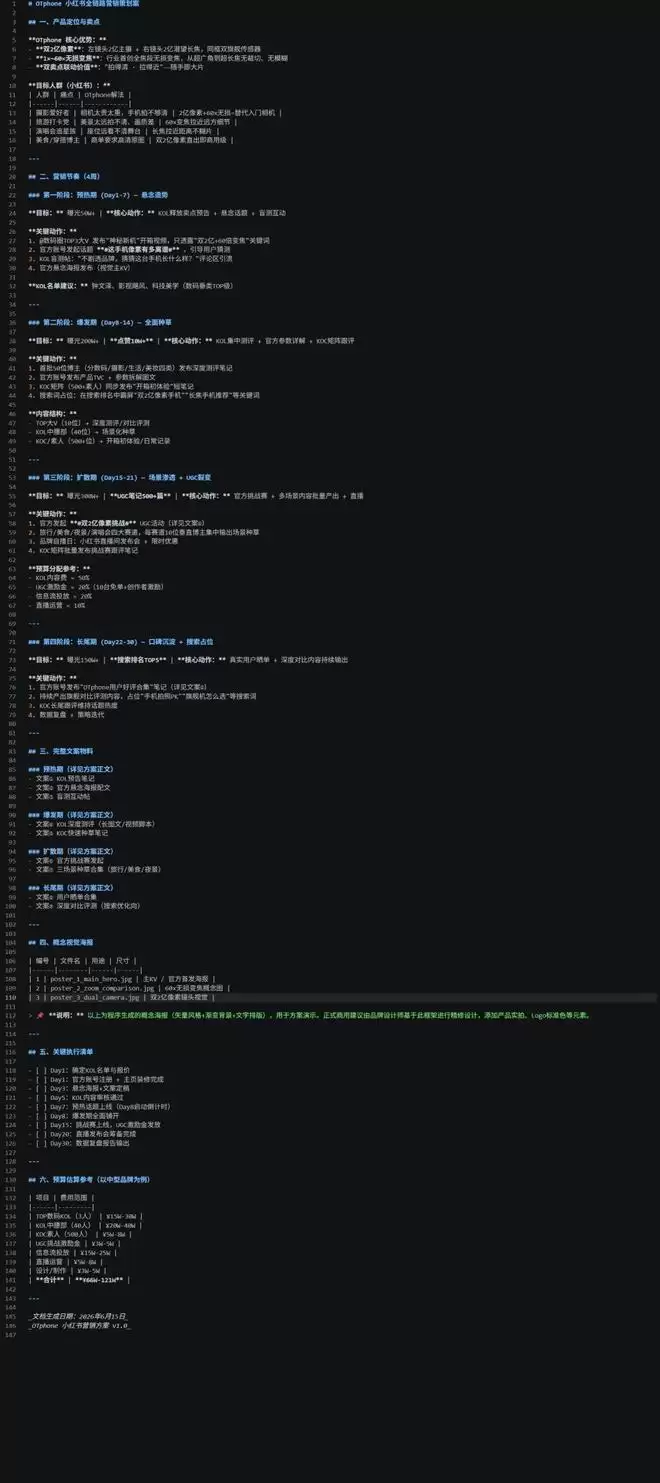
大约6分钟后,运营专家智能体完成任务并返回结果。整套营销方案设计得完整全面且具备可操作性,还附带了3张生成的海报。而这一切,全部在本地完成。得益于锐龙AI Max+ 395强大的性能、统一内存架构和AI算力支持,联想百应让“本地养龙虾”变得切实可行,尤其对于隐私敏感的任务,可以放心交给智能体去执行。
最后需要提醒的是,如果需要云端模型算力,也可以直接在联想百应上切换云端模型,购买联想的Token Plan,配合本地模型实现端云结合的使用体验。 ### 2、不同参数量本地大语言模型运行测试 上面用联想百应AI主机300跑本地智能体还算顺利,全程调用本地的Qwen3.6 35B模型。这让人好奇,这台机器在运行不同参数量的本地大语言模型时,实际吞吐性能到底有多强。 我们用LM Studio装载各种参数量的模型进行测试。先从Qwen3.5 9B参数开始,问了一个关于上海旅游攻略的问题,大模型很快完成回答,效果具体而详细。
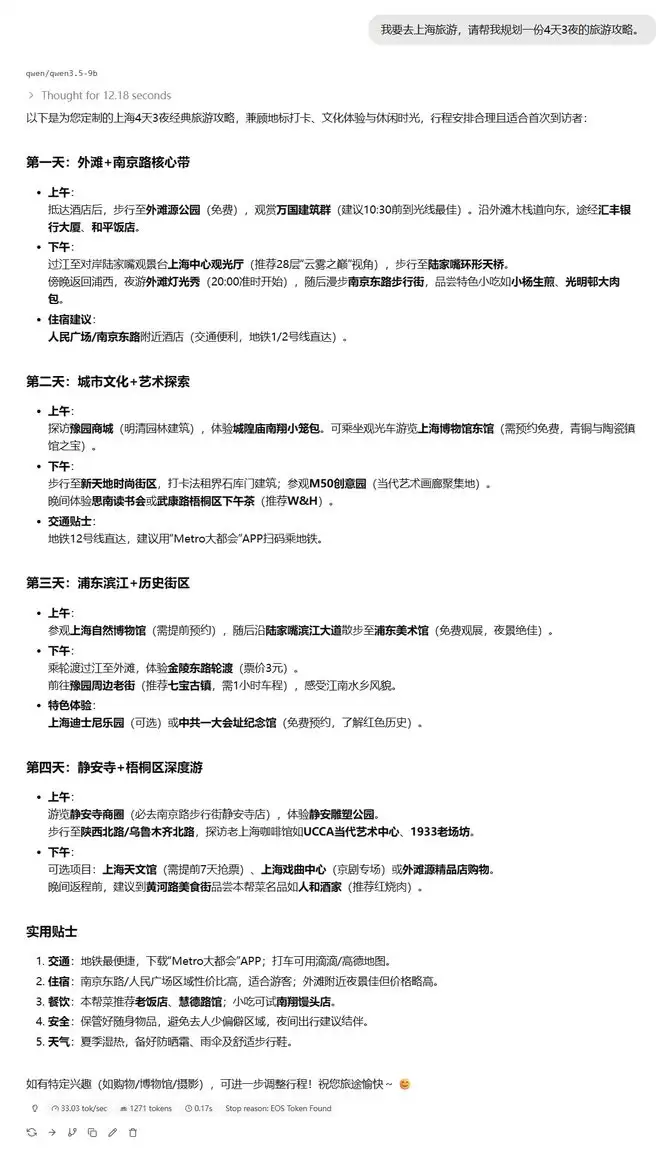
这次回答输出1271 tokens,速度33.03 tok/s,延迟0.17s。
接着换成Qwen 3.6 35B模型,类似的问题,回答更加详细,不仅提供了表格,各种需要避坑的要点也列了出来。关键是,这次35B模型输出了4752个tokens,输出速度61.66 tok/s,比刚才的9B模型更快。可见大参数模型在更好的优化和量化技术下,也能获得更出色的运行效率。
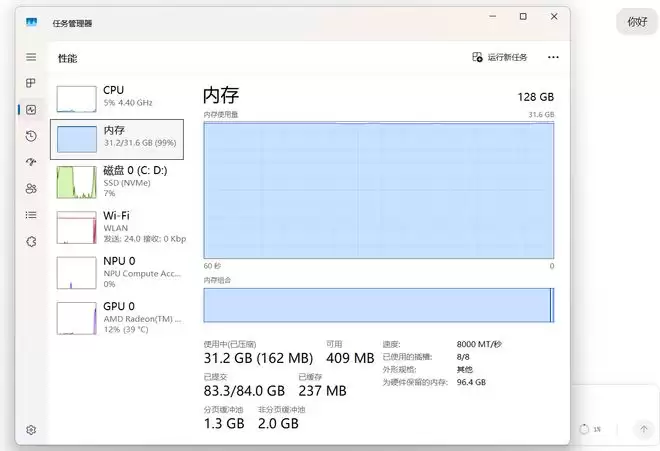
为了进一步压榨潜力,直接上强度——尝试运行参数量高达120B的OpenAI开源超大模型GPT-OSS。加载模型时,系统分配的32GB内存占用瞬间飙到99%,但得益于锐龙AI Max+ 395的超大容量256bit四通道高速统一内存架构,机器依然稳定地将模型跑了起来。
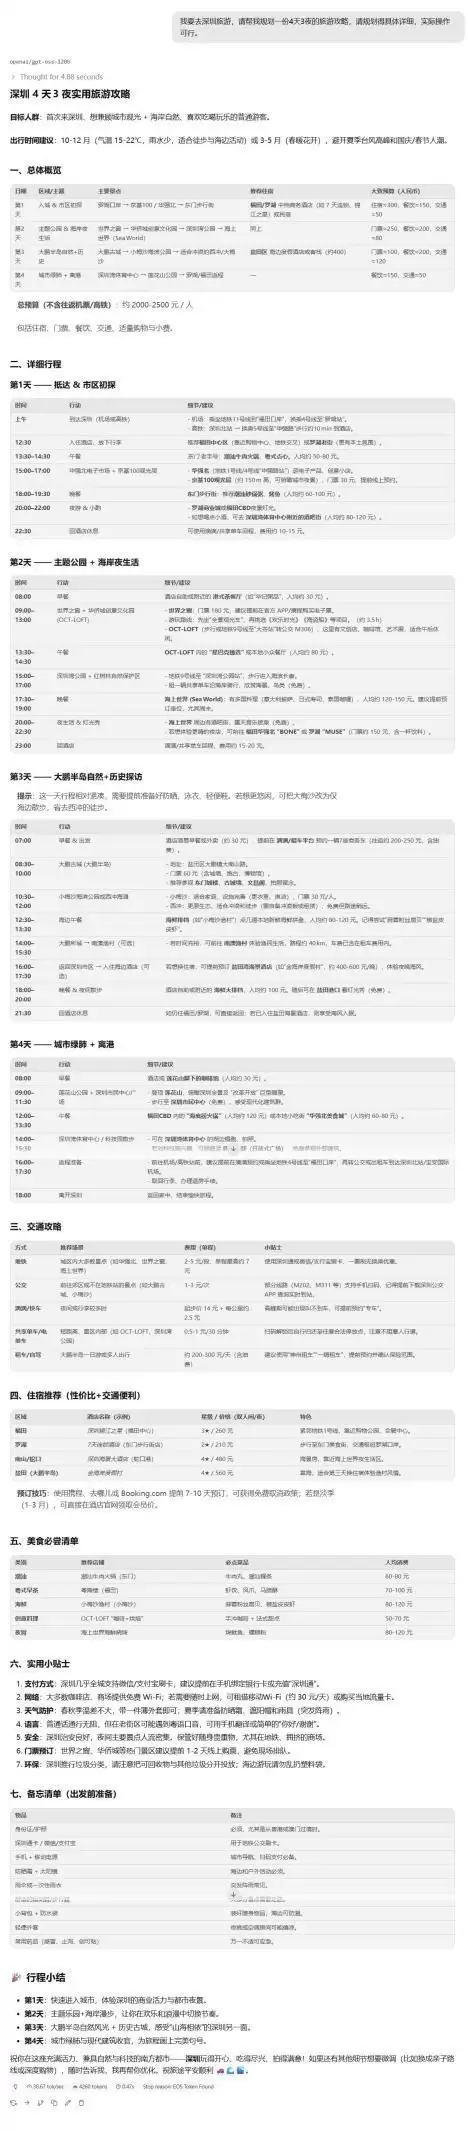
用同样的问题测试,GPT-OSS的回答流畅又详细,而且很擅长使用表格,各种要点一目了然。
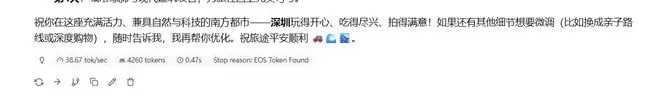
在运行120B超大模型时,联想百应AI主机300依然实现了38.67 tok/s的生成速度,总共生成4260个tokens,延迟0.47s。这个表现,对过去的个人PC或主机来说几乎难以想象。
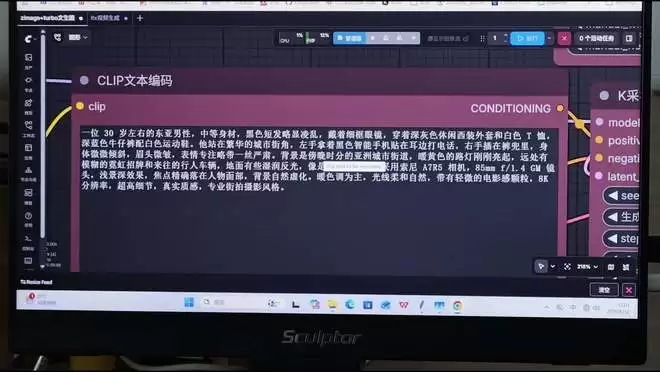
### 3、本地大模型的创意内容生成体验 除了文本类大语言模型,我们还在本地部署并运行了目前创作者圈比较流行的通用AI图像平台ComfyUI,搭建文生图工作流做了测试。 使用Zimage-Turbo-fp8模型,生成一张“亚洲男子在街头打电话”的图片,提示词指令详细,分辨率1328×1328,迭代步数8步。这张图片生成大约用了1分10秒,品质很高,完全符合复杂提示词的要求。
测试时给内存分配96GB、显存32GB,运行过程全程断网,内存和显存占用都在20%左右。
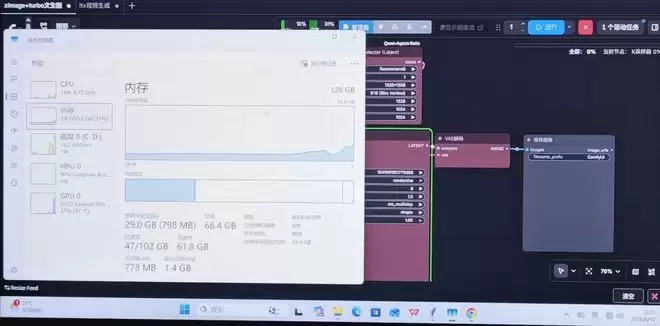
接着将显存分配到96GB、内存分配到32GB,再试一次。生成一张“女子在河边散步”的图片,提示词同样复杂。生成时间与上次差不多,约1分10秒。这说明锐龙AI Max+ 395的能力远不止于此,完全可以加大AI工作负载,比如提升图片分辨率、增加迭代步数,更充分地利用Radeon 8060S和统一内存架构的优势。
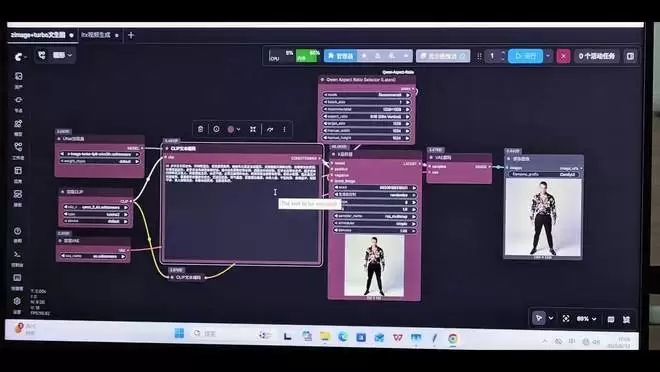
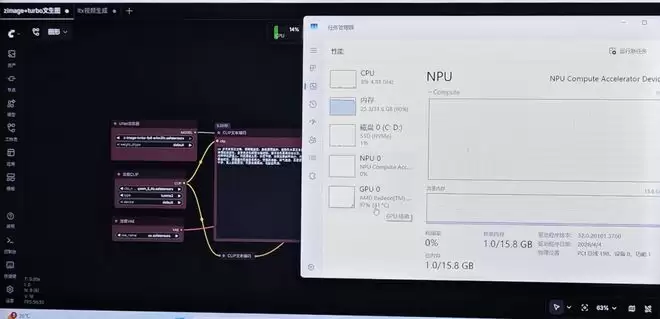
生图过程中内存和显存占用最高到80%和97%,但很快回落,整体性能开销不算大。生成的图片质量同样很高,精致真实、充满细节。
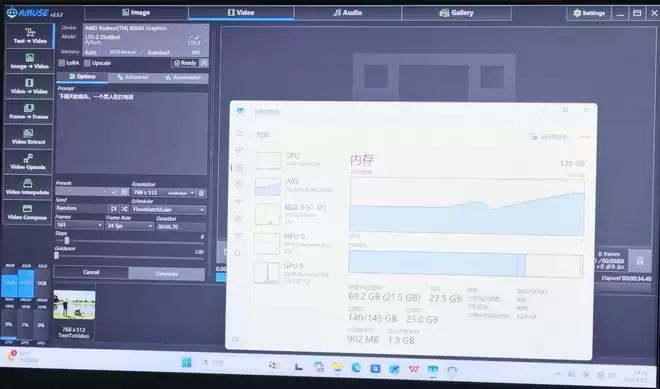
除了文生图,还测了本地文生视频。使用Amuse v3.5.2和LTX-2-Disstilled模型,生成一段“下雨天的街头,一个男人在打电话”的视频。
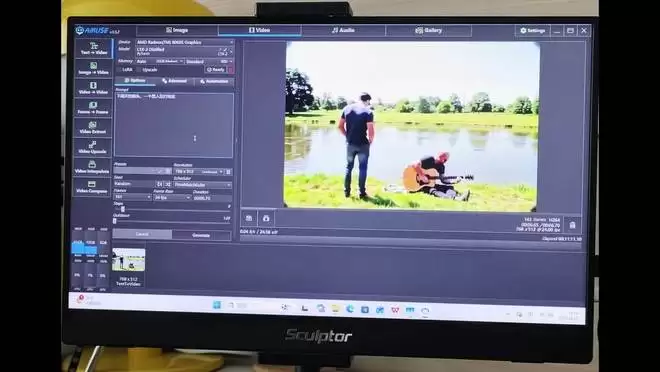
这段6.7秒的视频用了约11分钟,共161帧,分辨率768×512,帧率24 fps。生成过程中,内存占用较高,96GB最高超过75%,显存占用基本在5%以下。
生成的视频如下:
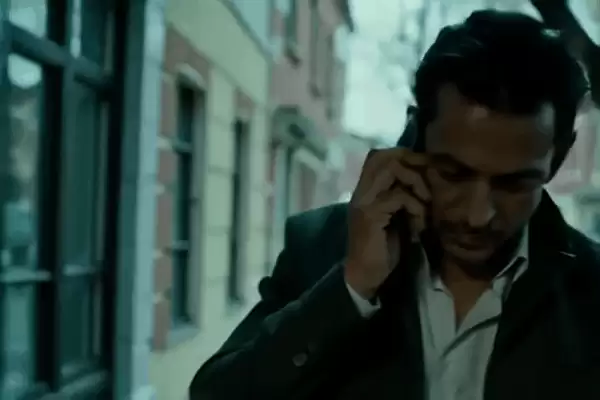
考虑到视频生成模型对算力和显存的恐怖消耗,这个速度表现相当出色。128GB的超大统一内存,在面对120B超大语言模型以及极为吃配置的AI文生视频任务时,与传统的消费级独显设备相比,架构优势和海量内存红利彻底显现——超大参数的模型也不至于出现爆显存或力不从心的尴尬局面。 ## 结语 一圈测试体验下来,联想百应AI主机300工作站的综合性能确实过硬。核心是AMD锐龙AI Max+ 395芯片带来的128GB超大内存容量和四通道256bit LPDDR5x内存位宽,通过统一内存架构设计,最高可分配96GB给显存,打破了以往桌面小主机无法胜任重度AI开发的刻板印象。海量内存空间让它在本地部署各种百亿甚至千亿级别的大语言模型这件事上,拥有目前市面上绝大多数常规产品无法比拟的巨大优势。再加上联想定制的一键部署功能,让零门槛体验前沿AI应用成为可能。 而对于那些本身具备开发能力的高阶玩家和极客来说,也可以顺手将它打造成纯本地的专属算力中心,彻底告别高昂的云端算力账单和API调用额度限制。
从行业落地视角看,联想百应AI主机300在医疗、制造业以及更广泛的企业办公领域都有可观的应用场景。医疗行业里,有些病人数据不能上云,它就可以化身本地的桌面影像智能诊断和病历录入大脑,辅助医生快速决策,提升诊疗效率;制造行业里,通过异常数据或故障照片就能实时分析产线问题,实现预测性维护,减少停机损失;企业进行私有智能体部署,也能自动生成周报、提炼会议重点、智能问答,化身全能AI助手;消费零售领域则更常见——智能客服本地化,实现对客户咨询的秒级响应,提升客户满意度。 联想百应AI主机300作为一款旗舰级主机,目前京东自营店128GB内存+2TB固态版本售价26999元。它更适合那些真正对本地AI有刚需、已经开始用AI干活、并且能切实提升工作和创作效率的用户——比如对本地数据隐私有极高要求的企业用户、开发者以及预算充足的极客们。
想要免费体验DeepSeek大模型?本文提供DeepSeek网页版官方登录入口,详解注册步骤、免费额度规则及深度思考模式的使用技巧,助你安全、高效地利用AI提升工作效率。
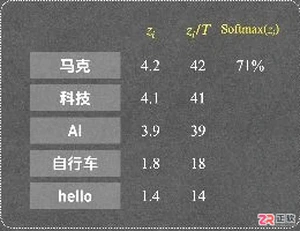
深入解析大模型中 Temperature 和 Top-p 参数的区别。通过 Softmax 计算和累计概率示例,说明温度如何影响概率分布形状,Top-p 如何筛选候选词集合,帮助理解模型生成机制。
马斯克回应称中国大模型或于2027年一季度达到Fable级别。智谱GLM-5.2多项评测与海外头部模型差距缩小至1%-4%,在CodeArena获全球可用模型第一。智谱股价单日涨26%,市值破9000亿港元。科创板拟扩大第五套标准支持AI企业上市。
6月19日,我国首个水产育种专用智能大模型平台“蓝鲲智种”在海南发布,由青岛蓝色种业研究院联合中国海洋大学等打造,标志着水产育种领域拥有专属科学智能模型和基础平台。
研究团队提出并行循环Transformer,让70亿参数模型通过两次内部循环思考,在代码任务上超越数百亿参数的大模型,第三次循环后性能因收益-代价失衡而下降。结合显式推理链可进一步提升效果。
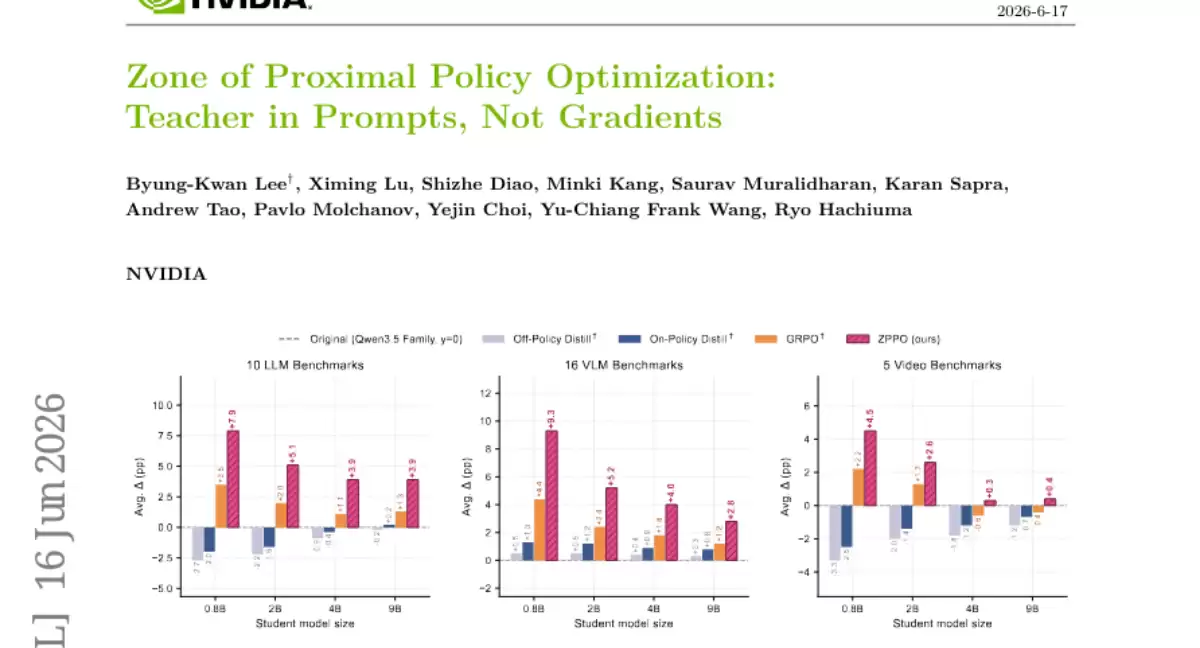
英伟达提出ZPPO方法,让大模型智慧以题目背景而非答案形式辅助小模型学习,通过二元候选、负面候选及回放缓冲区三大组件,在0.8B模型上视觉语言理解提升9.3%,全面超越现有方法。
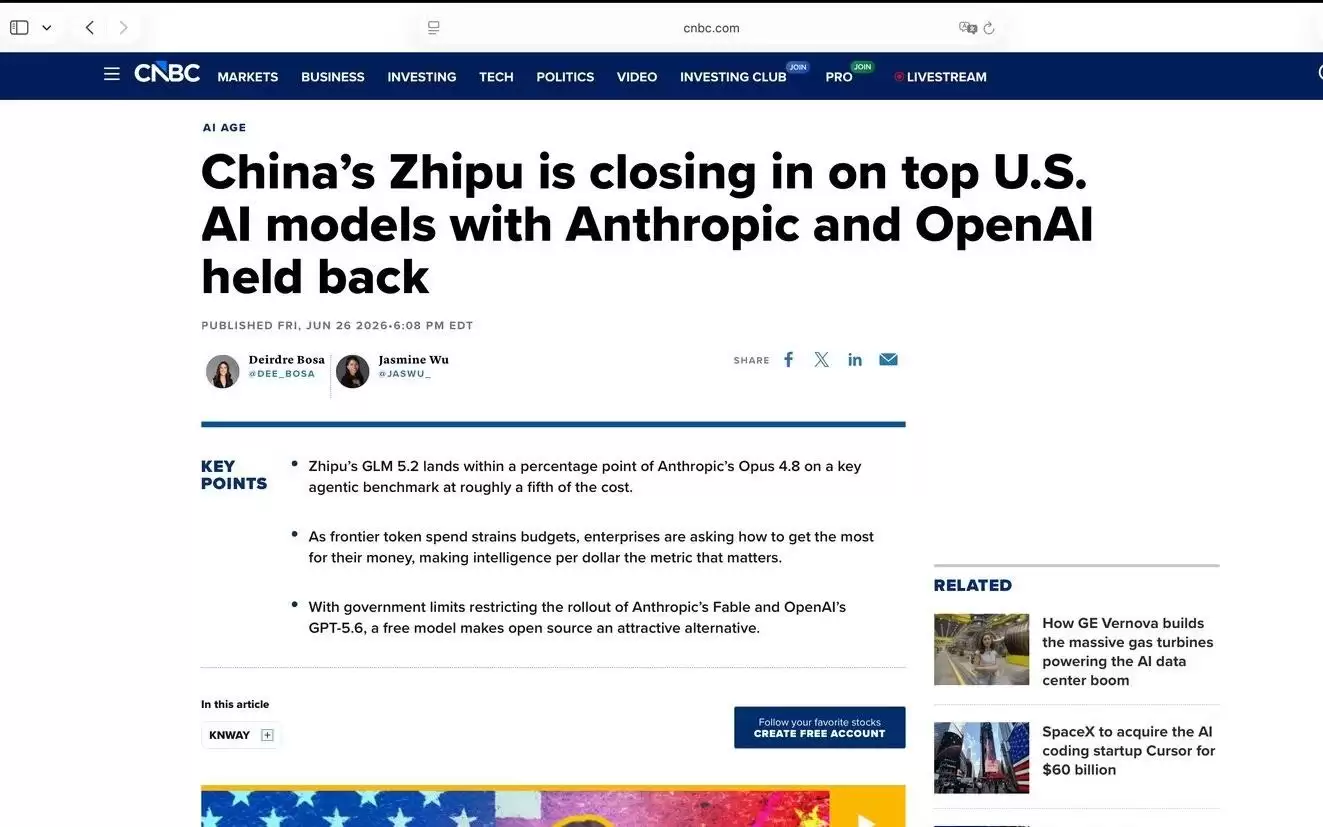
闭源API成本高、依赖性强,开放权重模型因可部署、可控、低成本而受青睐。2026年智谱GLM-5.2在特定任务接近美国前沿水平,标志前沿能力通过开放权重扩散。企业转向混合路线,模型调度层成为新机会,核心问题从“谁最强”变为“谁还愿意一直租用AI能力”。
大模型监督微调SFT,过去一直被当作一个“数据越多越好”的活儿。但如果你真的在一线跑过训练,就会知道这个直觉有多离谱。2026年的产业数据很清楚:国内大模型训练的整体算力有效利用率,连五成都不到。大量GPU资源,其实都消耗在那些重复、低信息量、甚至带偏见的冗余样本上。 从根子上讲,全量样本训练不仅直
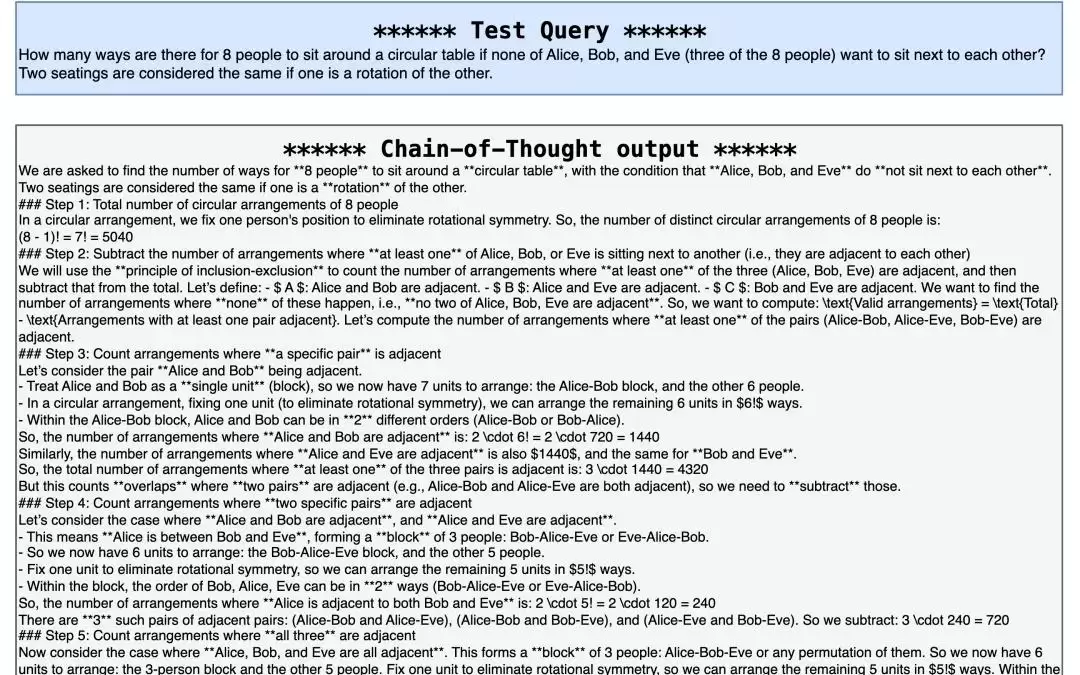
CLSR提出让大模型智能体自主生成演化机器语言符号体系,将推理链视为带宽受限的状态传输。实验表明,该方法在多种基准上将生成端token降低约3-6倍,基本维持原始CoT准确率,并改善accuracy-token帕累托前沿。
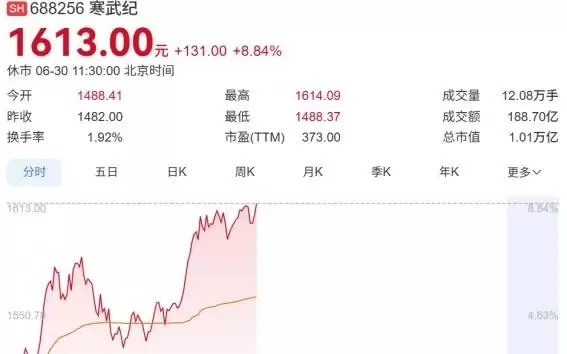
6月30日国产算力板块拉升,寒武纪涨超8%市值破万亿。美团发布LongCat-2.0,为首个完全基于国产算力训推的万亿参数大模型,参数超1.6万亿,测试版调用量全球前三,训练峰值算力超5万卡,成本低于同类模型。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



