

Java Stream API并行流(Parallel Stream)的底层实现原理
并行流基于Fork/Join框架,利用Spliterator递归拆分任务,通过Work-Stealing实现负载均衡并安全合并结果。适用于计算密集型大数据量场景;小数据或I/O操作因拆分和线程切换开销反而降低性能。
你可能会觉得Ja va Stream API的并行流(parallelStream())无非就是“开多线程跑一下”,但事实远没那么简单。它背后是一套相当精巧的分治调度机制——自动拆任务、均衡分配、安全合并,全程对开发者透明。下面就来拆解一下它的底层逻辑。
并行流基于Fork/Join框架实现分治调度,通过Spliterator拆分任务、Work-Stealing均衡负载、combiner/merger安全合并结果。但注意,它只适用于计算密集型的大数据量场景。
基于 Fork/Join 框架构建分治流水线
并行流的底层完全依托于Ja va的Fork/Join框架——这是专门为递归分治型任务设计的并发框架。当你调用parallelStream()时,整个处理流程会拆成三个阶段:
- Fork(拆分):数据源(比如ArrayList、HashMap等)通过
Spliterator接口递归切分成更小的独立块。切分策略因数据结构而异——ArrayList支持随机访问,切分效率很高;HashSet则只能按哈希桶粗粒度划分。 - 并行执行:每个子块作为独立任务提交到默认的
ForkJoinPool.commonPool()。JVM会根据可用CPU核心数动态设定并行度,通常是Runtime.getRuntime().a vailableProcessors() - 1。 - Join(合并):各线程完成局部计算后,中间结果按操作语义(比如
reduce的combiner、collect的merger)逐层合并,最终生成统一结果。
Spliterator 是并行能力的源头
串行流靠Iterator顺序遍历,而并行流依赖Spliterator——它不仅可遍历,更关键的是能split(拆分)。一个Spliterator会不断调用trySplit()方法,把自己一分为二,直到子任务小到一定程度(比如元素数≤1024或已不可再分)。这个过程决定了三件事:
- 是否支持并行——
characteristics()返回SIZED | SUBSIZED | IMMUTABLE等特征 - 切分是否均衡——比如
ArrayListSpliterator能精确按索引中分,而LinkedHashSetSpliterator只能近似 - 是否保留encounter order——这会影响
findFirst、forEachOrdered等有序操作的正确性
工作窃取(Work-Stealing)保障负载均衡
任务并不是静态绑定到线程的。ForkJoinPool里每个线程维护自己的双端队列(deque),新任务压入队尾,执行时从队首取;当某个线程的队列空了,它会去其他线程队列的尾部“窃取”一个任务。这种设计带来两个好处:
- 避免空闲线程等待,提升CPU利用率
- 窃取尾部任务能减少数据竞争——因为原线程刚压入的任务还没开始执行,状态更“新鲜”
这样一来,即便某些子任务耗时差异很大,整体吞吐依然比较稳定。
结果合并需谨慎:不是所有操作都线程安全
并行流本身不保证中间操作线程安全,终端操作才是关键分水岭:
- ✅ 安全操作:
map、filter、reduce(提供combiner)、collect(使用线程安全的Collector,比如Collectors.toList()) - ❌ 危险操作:
forEach直接修改共享变量(如list.add())、peek打印日志但没做同步、自定义无状态但非幂等的函数
举个典型反例:.forEach(result::addAll)——addAll不是原子操作,多个线程并发调用会导致数据丢失甚至ConcurrentModificationException。正确的做法是改用collect(Collectors.toList())或者forEachOrdered(牺牲部分并行性来保序)。
最后说一个经常被忽略的点:并行流提速是有前提的——任务要足够计算密集,且数据量足够大。小集合或者I/O绑定操作反而会因为调度开销而变慢。这个坑,不少人在实际项目中踩过。
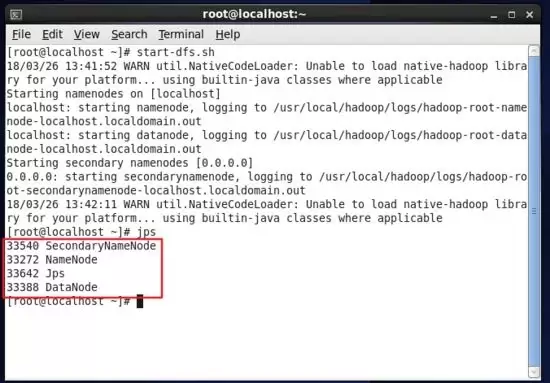
本教程指导大数据分析师在Linux环境中安装Hadoop,通过配置环境变量、验证版本及启动服务,确保Java和Hadoop命令可用。最终利用jps命令检查NameNode等核心进程状态,为后续学习HDFS和Spark打下基础。
麦富迪与达索系统联合举办技术公开日,展示数智化研发系统。通过WarmData大数据中心采集犬猫天性数据,结合达索系统仿真能力,实现配方模拟优化,缩短研发周期,推动宠物食品行业从经验驱动转向数据驱动。
总体原则匹配负载:以工作负载为锚点分配内存。轻量服务(如 Nginx、小型数据库)起步可给1–2 GB;桌面环境或中等负载建议2–4 GB;重负载(多服务/大数据/容器编排)在此基础上按峰值再加余量。始终以“应用需求 + 系统基线”为准,而非拍脑袋给大值。留有余量:宿主机需为自身与后台进程预留充足内
Debian 下 PostgreSQL 数据库迁移方案一、方案总览与选型方案适用场景停机窗口版本/平台要求关键工具主要优点主要限制逻辑导出导入(pg_dump/pg_restore、pg_dumpall)跨版本、跨平台、只迁部分库/表、云上/云下迁移一般为分钟级(取决于数据量)基本无限制,适合升级或
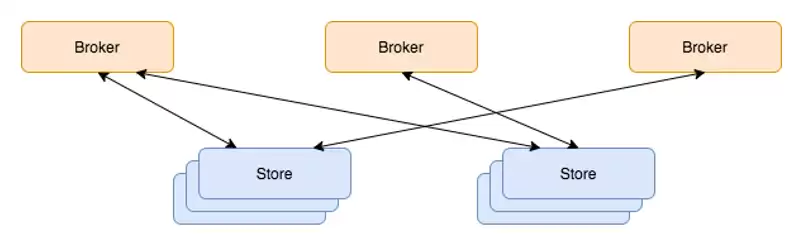
云妹导读:随着互联网的不断发展,大数据高并发不再遥远,是大部分项目都必须具备的能力。其中,消息队列几乎是必备技能。成熟的消息队列工具有很多,本篇文章就来介绍一款京东智联云自研消息队列工具——JCQ。JCQ全名JD Cloud Message Queue,是京东智联云自研,具有CloudNative特
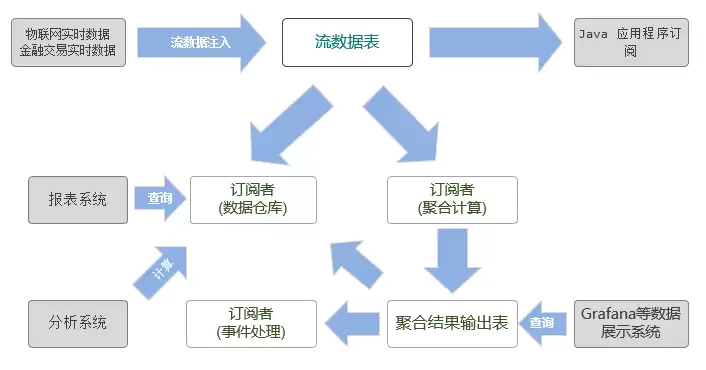
实时流处理一般是将业务系统产生的数据进行实时收集,交由流处理框架进行数据清洗,统计,入库,并可以通过可视化的方式对统计结果进行实时的展示。传统的面向静态数据表的计算引擎无法胜任流数据领域的分析和计算任务。在金融交易、物联网、互联网/移动互联网等应用场景中,复杂的业务需求对大数据处理的实时性提出了更高
导读:为了解决大数据、AI 等数据密集型应用在云原生场景下,面临的异构数据源访问复杂、存算分离 I/O 速度慢、场景感知弱调度低效等痛点问题,南京大学PASALab、阿里巴巴、Alluxio 在 2020 年 6 月份联合发起了开源项目 Fluid。Fluid 是云原生环境下数据密集型应用的高效支撑
什么是FluidFluid是一个开源的 Kubernetes 原生的分布式数据集编排和加速引擎,主要服务于云原生场景下的数据密集型应用,例如大数据应用、AI 应用等。通过 Kubernetes 服务提供的数据层抽象,可以让数据像流体一样在诸如 HDFS、OSS、Ceph 等存储源和 Kubernet
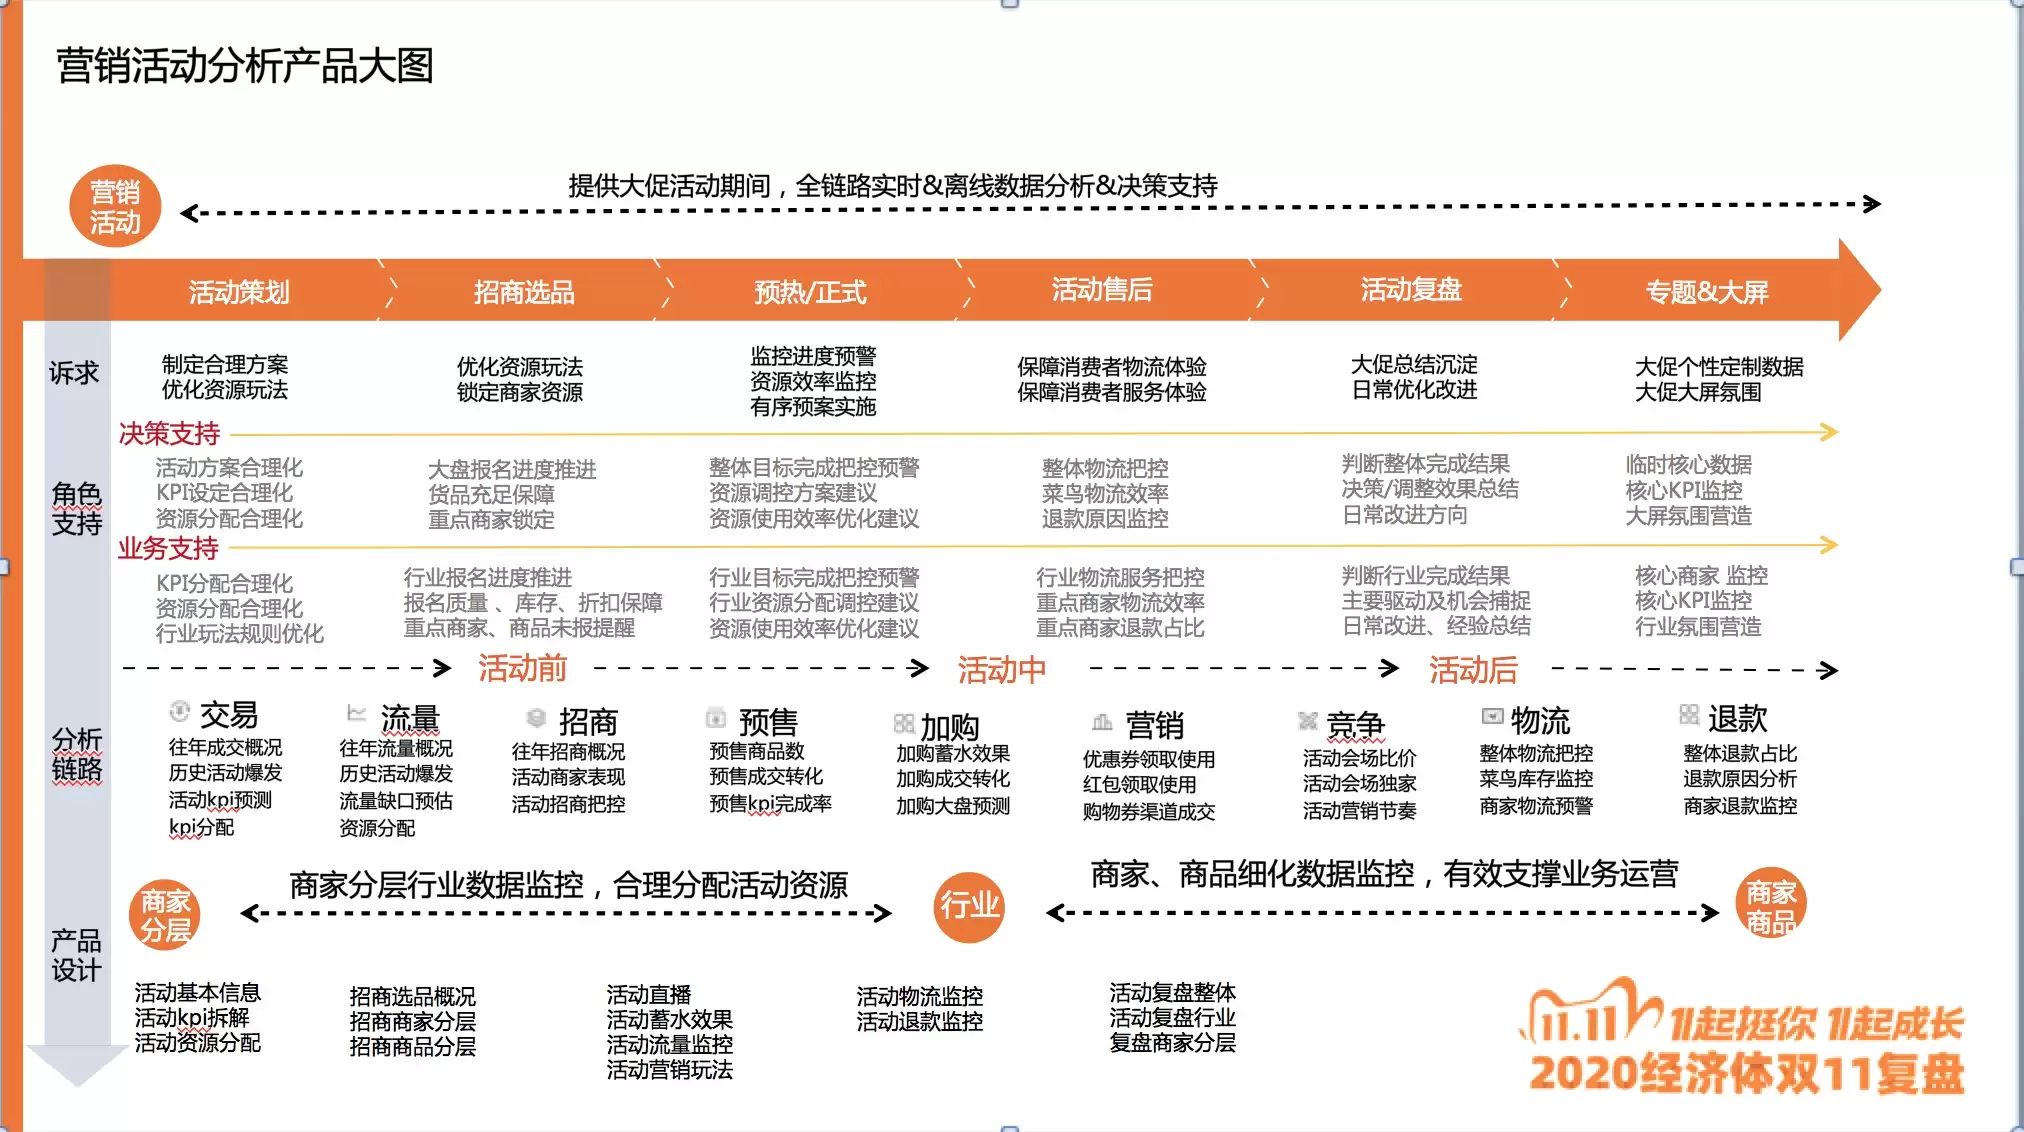
简介: 本篇将重点介绍Hologres在阿里巴巴淘宝营销活动分析场景的最佳实践,揭秘Flink+Hologres流批一体首次落地阿里双11营销分析大屏背后的技术考验。 概要:刚刚结束的2020天猫双11中,MaxCompute交互式分析(下称Hologres)+实时计算Flink搭建的云原生实时数仓
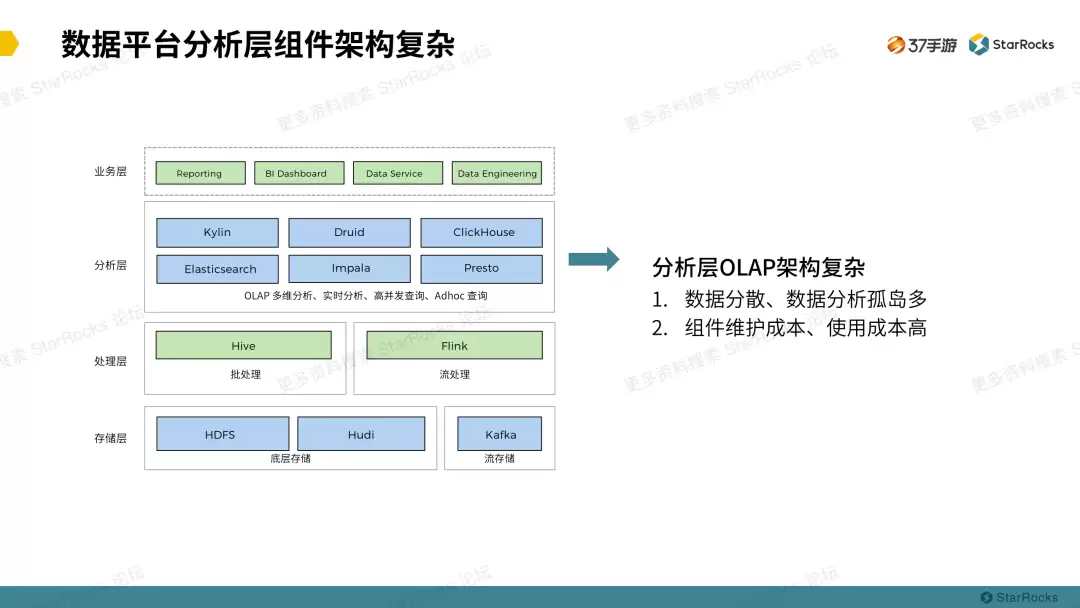
作者:向伟靖,37 手游大数据开发工程师37 手游使用 StarRocks 已有半年多,在此期间非常感谢 StarRocks 团队的积极协助,感受到了服务速度和产品速度一样快,辅导我们解决了产品使用上的一些问题。首先介绍下 37 手游的背景。37 手游主要专注于移动端游戏发行和游戏运营,成功发行运营





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



