

JavaScript数组与对象过滤方法的完全指南
JavaScript数组过滤方法有filter(返回新数组)、find(首个匹配元素)、findIndex(索引)、every(全满足)、some(有满足)。对象过滤可利用解构与Object.entries筛选键值。高级技巧支持递归清理、多条件组合、模糊搜索(正则)、去重、分页等灵活用法。
数据处理是前端开发中的日常操作,而过滤——无论是数组还是对象——几乎每天都在用。很多人习惯用 filter() 一把梭,但在实际项目中,面对不同场景,方法的选择直接决定了代码的可读性和性能。下面就把这些常用的过滤方法梳理一遍,从基础到进阶,顺便聊聊那些容易踩的坑。
一、数组过滤方法
1. filter() — 最常用过滤方法
创建一个新数组,包含通过测试的所有元素。

const numbers = [1, 2, 3, 4, 5, 6];

// 基础用法:过滤偶数
const evens = numbers.filter(num => num % 2 === 0);
// 结果: [2, 4, 6]

// 复杂条件:过滤大于3且是偶数的数
const result = numbers.filter(num => num > 3 && num % 2 === 0);
// 结果: [4, 6]

// 对象数组过滤
const users = [
  { name: '张三', age: 25, active: true },
  { name: '李四', age: 30, active: false },
  { name: '王五', age: 28, active: true }
];
const activeUsers = users.filter(user => user.active);
// 结果: [{ name: '张三', age: 25... }, { name: '王五', age: 28... }]
const adults = users.filter(user => user.age >= 28);
// 结果: [{ name: '李四', age: 30... }, { name: '王五', age: 28... }]
参数说明:
array.filter((element, index, array) => {
  // 返回 true 保留元素,false 则过滤掉
});
| 参数 | 说明 |
|---|---|
element | 当前处理的元素(必需) |
index | 当前元素的索引(可选) |
array | 调用 filter 的数组本身(可选) |
2. find() — 查找单个元素
返回第一个满足条件的元素,找不到返回 undefined。
const users = [
  { id: 1, name: '张三' },
  { id: 2, name: '李四' },
  { id: 3, name: '王五' }
];
// 查找特定ID的用户
const user = users.find(u => u.id === 2);
// 结果: { id: 2, name: '李四' }

// 查找不存在的返回 undefined
const notFound = users.find(u => u.id === 999);
// 结果: undefined
3. findIndex() — 查找索引
返回第一个满足条件的元素的索引,找不到返回 -1。
const numbers = [10, 20, 30, 40];
const index = numbers.findIndex(num => num > 25);
// 结果: 2 (即30的索引)

// 常用于删除特定元素
const users = [{ id: 1 }, { id: 2 }, { id: 3 }];
const idx = users.findIndex(u => u.id === 2);
if (idx !== -1) users.splice(idx, 1);
4. every() — 全部满足
测试是否所有元素都通过测试,返回布尔值。
const scores = [85, 90, 88, 92];
// 是否全部及格(>=60)
const allPassed = scores.every(score => score >= 60);
// 结果: true
const allExcellent = scores.every(score => score >= 90);
// 结果: false
5. some() — 部分满足
测试是否有至少一个元素通过测试,返回布尔值。
const users = [
  { name: '张三', role: 'admin' },
  { name: '李四', role: 'user' }
];
// 是否存在管理员
const hasAdmin = users.some(u => u.role === 'admin');
// 结果: true

// 是否有未成年人
const ages = [25, 30, 16, 28];
const hasMinor = ages.some(age => age < 18);
// 结果: true
二、对象过滤方法
1. 根据键值过滤对象属性
const user = {
  id: 1,
  name: '张三',
  password: 'secret123',
  email: 'zhangsan@example.com',
  createdAt: '2024-01-01',
  token: 'abc123'
};

// 方法1:解构 + 剩余参数(排除特定字段)
const { password, token, ...safeUser } = user;
console.log(safeUser);
// { id: 1, name: '张三', email: '...', createdAt: '...' }

// 方法2:动态过滤(保留指定字段)
const pick = (obj, keys) =>
  Object.fromEntries(
    Object.entries(obj).filter(([key]) => keys.includes(key))
  );
const publicFields = pick(user, ['id', 'name', 'email']);
// { id: 1, name: '张三', email: '...' }

// 方法3:动态过滤(排除指定字段)
const omit = (obj, keys) =>
  Object.fromEntries(
    Object.entries(obj).filter(([key]) => !keys.includes(key))
  );
const safeData = omit(user, ['password', 'token']);
// { id: 1, name: '张三', email: '...', createdAt: '...' }
2. 深度过滤对象(递归)
// 递归移除所有 null/undefined/空字符串
const cleanObject = (obj) => {
  if (Array.isArray(obj)) {
    return obj.map(cleanObject).filter(item => item != null);
  }
  if (typeof obj === 'object' && obj !== null) {
    return Object.fromEntries(
      Object.entries(obj)
        .filter(([_, v]) => v != null && v !== '')
        .map(([k, v]) => [k, cleanObject(v)])
    );
  }
  return obj;
};

const dirty = {
  a: 1,
  b: null,
  c: '',
  d: { e: 2, f: undefined, g: { h: '', i: 3 } }
};
cleanObject(dirty);
// { a: 1, d: { e: 2, g: { i: 3 } } }
3. 根据值的条件过滤对象
const products = {
  apple: { price: 5, stock: 100 },
  banana: { price: 3, stock: 0 },
  orange: { price: 4, stock: 50 }
};
// 过滤出有库存的商品
const inStock = Object.fromEntries(
  Object.entries(products).filter(([_, product]) => product.stock > 0)
);
// { apple: { price: 5, stock: 100 }, orange: { price: 4, stock: 50 } }

// 过滤出价格低于5的商品
const affordable = Object.fromEntries(
  Object.entries(products).filter(([_, p]) => p.price < 5)
);
// { banana: { price: 3, stock: 0 }, orange: { price: 4, stock: 50 } }
三、高级过滤技巧
1. 多条件组合过滤
const products = [
  { name: 'iPhone', category: '手机', price: 5999, brand: 'Apple' },
  { name: 'iPad', category: '平板', price: 3999, brand: 'Apple' },
  { name: 'Mate60', category: '手机', price: 6999, brand: 'Huawei' },
  { name: 'MatePad', category: '平板', price: 2999, brand: 'Huawei' }
];

// 链式过滤:先按类别,再按品牌,最后按价格
const result = products
  .filter(p => p.category === '手机')
  .filter(p => p.brand === 'Apple')
  .filter(p => p.price < 7000);
// 结果: [{ name: 'iPhone', ... }]

// 或使用单一复杂条件(性能更好)
const result2 = products.filter(p =>
  p.category === '手机' &&
  p.brand === 'Apple' &&
  p.price < 7000
);
2. 模糊搜索/文本过滤
const users = [
  { name: '张三', email: 'zhangsan@test.com' },
  { name: '张三丰', email: 'zhangsanfeng@test.com' },
  { name: '李四', email: 'lisi@test.com' }
];
const searchTerm = 'zhang';

// 不区分大小写的多字段搜索
const filtered = users.filter(user =>
  Object.values(user).some(value =>
    String(value).toLowerCase().includes(searchTerm.toLowerCase())
  )
);
// 结果: 张三 和 张三丰
3. 去重过滤
const numbers = [1, 2, 2, 3, 3, 3, 4];
// 方法1:使用 Set(最简单)
const unique1 = [...new Set(numbers)]; // [1, 2, 3, 4]

// 方法2:根据对象属性去重
const users = [
  { id: 1, name: '张三' },
  { id: 2, name: '李四' },
  { id: 1, name: '张三(重复)' }
];
const uniqueById = users.filter((user, index, self) =>
  index === self.findIndex(u => u.id === user.id)
);
// 结果: [{ id: 1, name: '张三' }, { id: 2, name: '李四' }]
4. 分页过滤
const allData = Array.from({ length: 100 }, (_, i) => ({ id: i + 1 }));
const paginate = (data, page, pageSize) => {
  const start = (page - 1) * pageSize;
  return data.slice(start, start + pageSize);
};
const page1 = paginate(allData, 1, 10); // 第1页,每页10条
const page2 = paginate(allData, 2, 10); // 第2页
5. 链式过滤 vs 管道函数
// 创建可复用的过滤管道
const pipe = (...filters) => {
  return (data) => filters.reduce((acc, filter) => acc.filter(filter), data);
};

// 定义过滤函数
const isActive = user => user.active;
const isAdult = user => user.age >= 18;
const isFromCity = city => user => user.city === city;

const users = [
  { name: '张三', age: 25, city: '北京', active: true },
  { name: '李四', age: 30, city: '上海', active: false },
  { name: '王五', age: 17, city: '北京', active: true },
  { name: '赵六', age: 28, city: '北京', active: true }
];

// 组合过滤条件
const activeAdultsInBeijing = pipe(isActive, isAdult, isFromCity('北京'));
const result = activeAdultsInBeijing(users);
// 结果: [{ name: '张三', ... }, { name: '赵六', ... }]
四、性能优化建议
| 场景 | 推荐方法 | 时间复杂度 | 说明 |
|---|---|---|---|
| 简单过滤 | filter() | O(n) | 代码清晰,性能良好 |
| 大数据量(>10万) | for 循环 | O(n) | 比 filter() 快 20-30% |
| 提前终止 | find() / some() | O(k) | 找到即停,k ≤ n |
| 多次过滤 | 单一复杂条件 | O(n) | 减少遍历次数 |
| 去重 | Set | O(n) | 最优方案 |
| 对象属性去重 | Map | O(n) | 优于 findIndex 的 O(n²) |
性能优化示例
// 大数据量优化示例
const bigArray = new Array(1000000).fill(0).map((_, i) => i);

// 较慢:filter 链
const slow = bigArray.filter(n => n > 100).filter(n => n % 2 === 0);

// 较快:单一 filter
const fast = bigArray.filter(n => n > 100 && n % 2 === 0);

// 最快:for 循环
const fastest = [];
for (let i = 0; i < bigArray.length; i++) {
  const n = bigArray[i];
  if (n > 100 && n % 2 === 0) fastest.push(n);
}
内存优化建议
// 避免在循环中创建不必要的中间数组
const users = [/* 大量数据 */];

// ❌ 不好:创建多个中间数组
const result = users
  .filter(u => u.active)
  .map(u => ({ ...u, fullName: `${u.firstName} ${u.lastName}` }))
  .filter(u => u.age >= 18);

// ✅ 更好:使用 reduce 一次完成
const result = users.reduce((acc, user) => {
  if (user.active && user.age >= 18) {
    acc.push({
      ...user,
      fullName: `${user.firstName} ${user.lastName}`
    });
  }
  return acc;
}, []);
五、常用工具函数封装
// 通用过滤工具库
const FilterUtils = {
  // 多条件过滤
  multiFilter: (data, conditions) =>
    data.filter(item => conditions.every(cond => cond(item))),

  // 模糊搜索
  fuzzySearch: (data, fields, keyword) =>
    data.filter(item =>
      fields.some(field =>
        String(item[field]).toLowerCase()
          .includes(keyword.toLowerCase())
      )
    ),

  // 范围过滤
  inRange: (data, field, min, max) =>
    data.filter(item => item[field] >= min && item[field] <= max),

  // 对象数组去重
  uniqueBy: (data, key) =>
    data.filter((item, index, self) =>
      index === self.findIndex(t => t[key] === item[key])
    ),

  // 清理空值
  compact: (data) =>
    data.filter(Boolean) // 移除 falsy 值
};

// 使用示例
const users = [
  { name: '张三', age: 25, city: '北京' },
  { name: '李四', age: 30, city: '上海' },
  { name: '王五', age: 28, city: '北京' }
];
// 多条件:北京的成年人
const result = FilterUtils.multiFilter(users, [
  u => u.city === '北京',
  u => u.age >= 18
]);
总结对比表
| 方法 | 返回类型 | 用途 | 是否改变原数组 | 短路特性 | 适用场景 |
|---|---|---|---|---|---|
filter() | 新数组 | 保留符合条件的元素 | ❌ | ❌ | 需要多个结果 |
find() | 元素/undefined | 查找第一个匹配项 | ❌ | ✅ | 查找单个元素 |
findIndex() | 数字索引 | 查找第一个匹配项的索引 | ❌ | ✅ | 需要索引进行操作 |
findLast() | 元素/undefined | 查找最后一个匹配项 | ❌ | ✅ | 从后向前查找 |
findLastIndex() | 数字索引 | 查找最后一个匹配项的索引 | ❌ | ✅ | 从后向前找索引 |
every() | Boolean | 是否全部满足 | ❌ | ✅ | 验证所有元素 |
some() | Boolean | 是否部分满足 | ❌ | ✅ | 验证存在性 |
map() | 新数组 | 转换每个元素 | ❌ | ❌ | 数据转换 |
reduce() | 任意值 | 聚合计算 | ❌ | ❌ | 累加、分组等 |
flatMap() | 新数组 | 映射后展平一层 | ❌ | ❌ | 一对多转换 |
ES2023 新增方法
// findLast 和 findLastIndex(从后向前查找)
const numbers = [5, 12, 8, 130, 44];
const lastLarge = numbers.findLast(n => n > 10);
// 结果: 44(从后向前第一个大于10的数)
const lastLargeIndex = numbers.findLastIndex(n => n > 10);
// 结果: 4(44的索引)

// toReversed、toSorted、toSpliced、with(不改变原数组的版本)
const original = [1, 2, 3];
const reversed = original.toReversed();
// original 仍然是 [1, 2, 3],reversed 是 [3, 2, 1]
常见问题与注意事项
1. 空值处理
// filter 会自动跳过空槽位(稀疏数组)
const sparse = [1, , , 4];
const filtered = sparse.filter(x => x > 0);
// 结果: [1, 4](空槽位被忽略)

// 但需要注意 undefined 和 null 的区别
const withUndefined = [1, undefined, null, 4];
const cleaned = withUndefined.filter(x => x != null);
// 结果: [1, 4](保留了数值,移除了 undefined 和 null)
2. 异步过滤
// 异步过滤需要配合 Promise.all 和 map
const asyncFilter = async (arr, predicate) => {
  const results = await Promise.all(arr.map(predicate));
  return arr.filter((_, index) => results[index]);
};

// 使用示例
const numbers = [1, 2, 3, 4, 5];
const isEvenAsync = async (num) => {
  await new Promise(resolve => setTimeout(resolve, 10));
  return num % 2 === 0;
};
const evens = await asyncFilter(numbers, isEvenAsync);
// 结果: [2, 4](异步版本)
3. 类型守卫与 TypeScript
// TypeScript 类型守卫示例
interface User {
  id: number;
  name: string;
  email?: string;
}

// 使用类型谓词进行类型收窄
function hasEmail(user: User): user is User & { email: string } {
  return user.email !== undefined;
}

const users: User[] = [
  { id: 1, name: '张三', email: 'zhang@test.com' },
  { id: 2, name: '李四' }
];

const usersWithEmail = users.filter(hasEmail);
// usersWithEmail 类型自动推断为 (User & { email: string })[]
通过以上方法,你可以在各种场景下高效、优雅地处理 Ja vaScript 中的数组和对象过滤需求。根据具体场景选择合适的方法,既能保证代码可读性,又能兼顾性能表现。
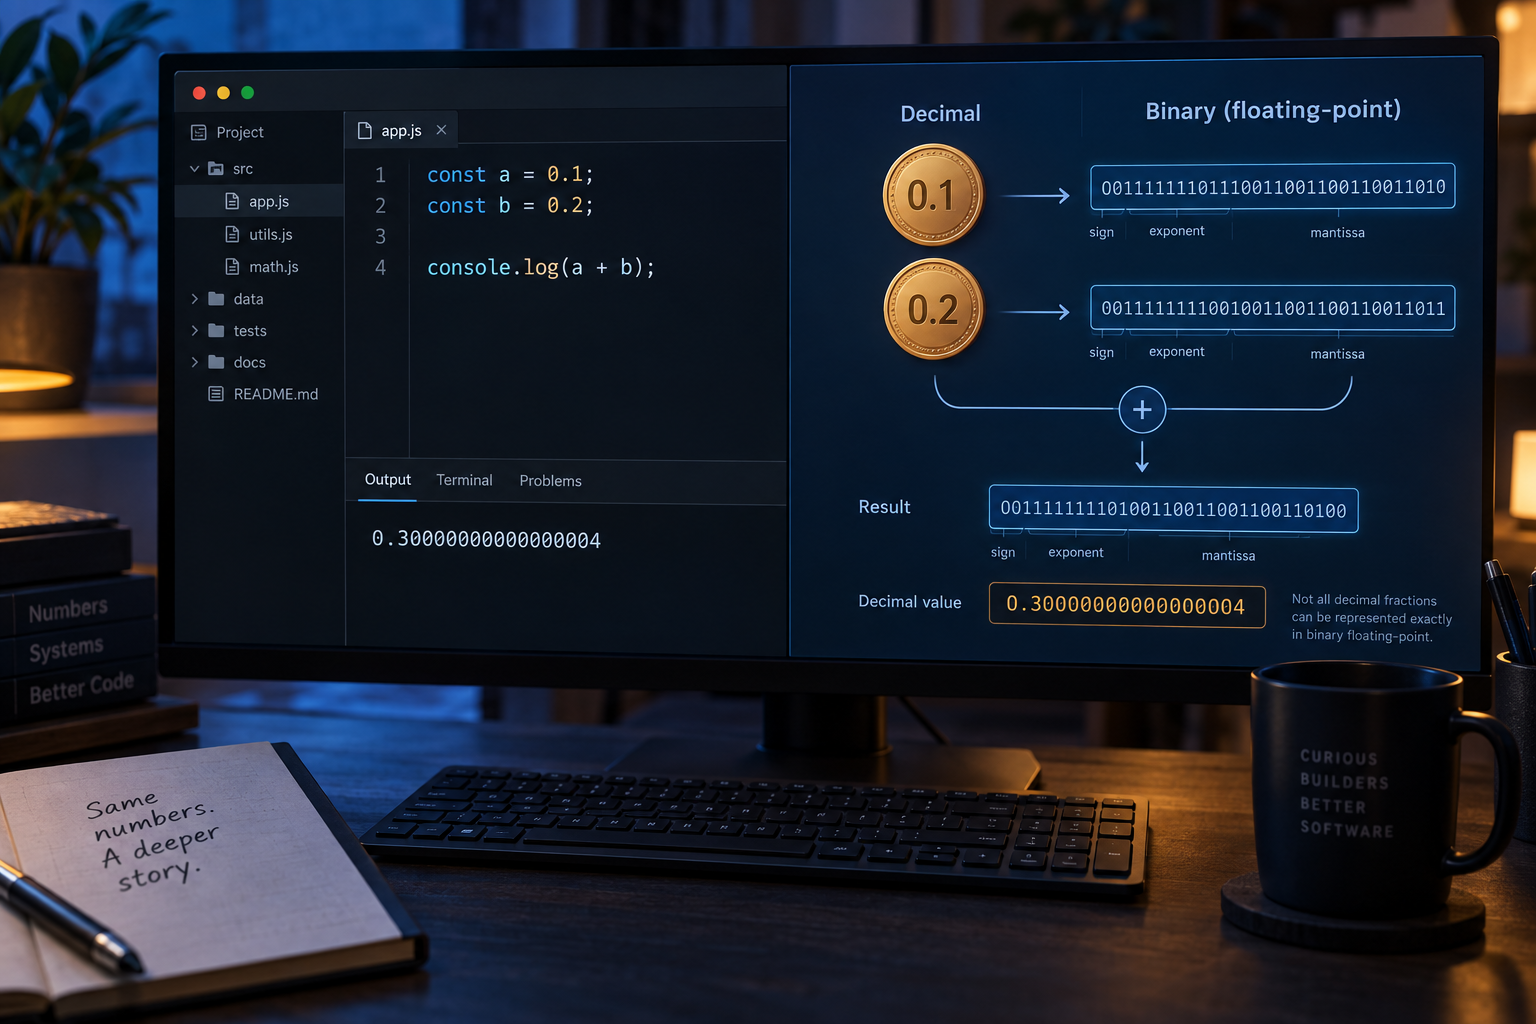
解决JavaScript中0.1+0.2!=0.3的精度问题。深入解析IEEE 754浮点数机制,对比展示用toFixed与结算用整数分计算的适用场景,提供decimal.js库的正确用法与验证方法,帮助开发者在电商与金融场景中实现精确的金额处理。
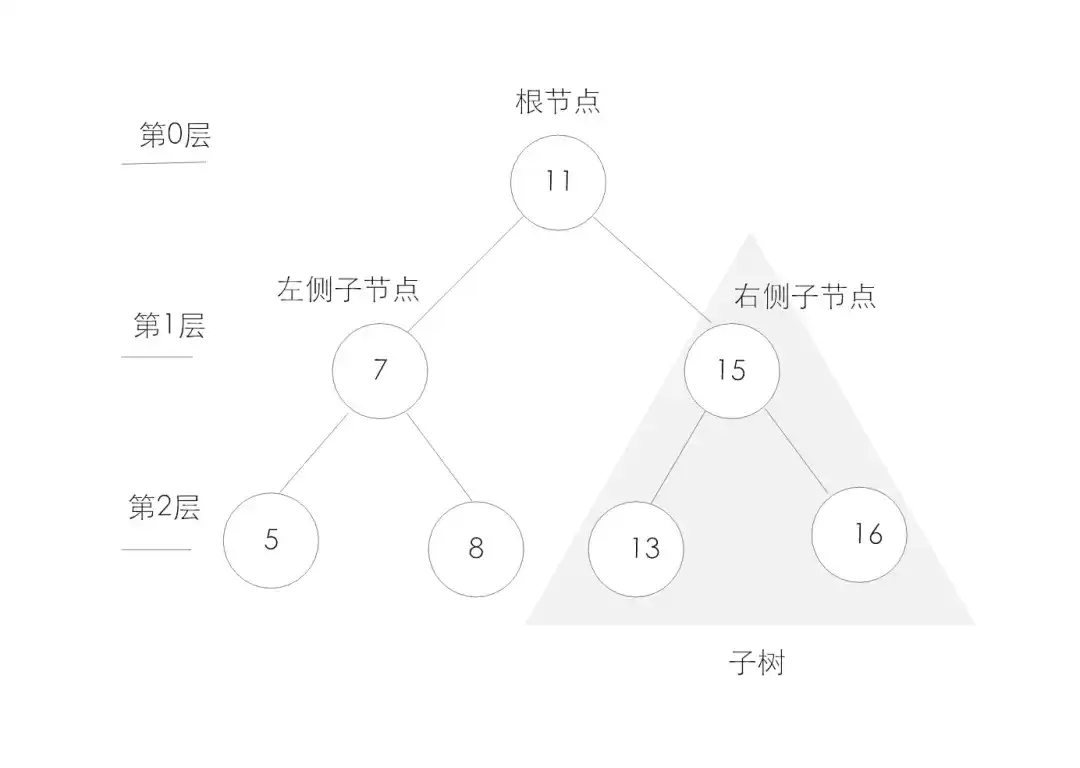
圣诞快乐接下来,咱们一起深入探讨一下js数据结构中的树。其实呀,这里的树和现实生活中的树很相似,都有树干、树枝。而在程序里,树可是一种非常重要的数据结构哦,对于存储那些需要快速查找的数据来说,它简直太有用啦!它是一种分层数据的抽象模型。一个树结构包含了一系列具有父子关系的节点。每个节点都有一个父节点

谷歌浏览器Mac版官方安装指南 谷歌浏览器Mac版官方安装入口是https://www.google.com/chrome/,需macOS 12+系统、500MB空间,下载.dmg后拖入应用程序安装,支持多设备同步、性能优化与隐私保护功能。 苹果电脑Chrome的安装入口究竟在哪里?这个问题最近可是

Chrome中JavaScript未执行需依次检查:一、移除站点级禁用并添加允许域名;二、开启全局JavaScript开关;三、禁用干扰扩展;四、在开发者工具中启用JavaScript;五、重置内容设置为默认。 有时在Chrome里打开网页,会发现交互按钮点了没反应,数据加载不出来,页面仿佛“静止”
IE浏览器怀旧版在线网址:一次精准的技术时光回溯 最近,不少老用户和怀旧爱好者在反复搜索一个问题:那个经典的Internet Explorer,如今还能在哪里原汁原味地体验到?答案指向一个特定的地址:https://ie.microsoft.com/legacy/。 这个网站远不止是一个简单的“皮肤

Chrome官方免验证入口为https://www.google.cn/chrome/,提供全平台安装包、免登录即用、本地化安全机制及引擎级性能优化。 到底该去哪里找正版、免费且无需繁琐验证的Chrome浏览器入口?这个问题困扰了不少网友。今天,我们就来直通核心,为大家详细拆解Chrome引擎的官方

命名空间的基本概念与常见引入问题在C++等编程语言中,命名空间(namespace)是一种将代码标识符(如变量、函数、类名)封装在特定名称下的机制,其主要目的是避免命名冲突,尤其是在大型项目或使用多个第三方库时。使用“using namespace”指令可以将指定命名空间中的所有名称引入当前作用域,

理解递归的基本原理在C语言中,递归是一种函数调用自身的编程技术。要掌握它,首先需要理解其核心思想:将一个复杂的大问题,分解为一个或几个与原问题相似但规模更小的子问题,直到子问题足够简单,可以直接求解。这个过程通常包含两个关键部分:递归出口和递归体。递归出口定义了问题何时不再继续分解,即最简单、可直接
递归函数的基本概念与适用场景在C语言编程中,递归是一种函数调用自身的编程技巧。它并非适用于所有问题,但在处理某些具有自相似结构的问题时,能提供极其清晰和优雅的解决方案。递归的核心思想是将一个大规模问题分解为一个或多个同类型但规模更小的子问题,直到子问题简单到可以直接求解。典型的适用场景包括树形结构的






Windows 10 是一款微软推出的经典操作系统,拥有硬件兼容性与多任务处理能力。它更偏向把系统状态查看和常用调节动作放在一起,适合需要持续观察和微调设备状态的场景。

极度公式是一款跨平台专业LaTeX公式识别编辑软件,支持OCR公式识别和多平台编辑。和使用说明,避免使用,享受完整功能与稳定支持。做扫描整理、文字提取和表格转换时,它能把识别后的处理步骤接得更顺,资料录入这类场景会省下不少时间。
