

Java无锁队列Disruptor的原理深度解析
Disruptor是基于环形缓冲区的无锁队列,通过预分配数组消除GC,使用CAS与内存屏障实现无锁并发,借助缓存行填充解决伪共享,支持批量事件处理与无锁依赖关系协调,将线程间数据交换延迟降至极低。
在高并发场景下摸爬滚打久了,你会发现一个尴尬的事实:很多看起来“够用”的队列,一旦遇到真正的性能高压,很快就会露出破绽。传统的ArrayBlockingQueue或LinkedBlockingQueue,在每秒几十万甚至上百万次请求的洪流面前,常常成为系统的短板。说到底,主要还是这几个问题:
- 锁竞争——生产者和消费者共用一把锁,线程频繁挂起、唤醒,上下文切换的开销大到吓人。
- 伪共享——逻辑上不相干的变量,物理上挤在同一个CPU缓存行里,一个线程写一下,另一个线程的缓存行直接失效,性能瞬间跳水。
- 内存分配开销——链表结构的队列,每次入队出队都涉及节点创建和垃圾回收。在高吞吐下,GC压力会像滚雪球一样越滚越大。
- 批量操作效率低——传统队列的“头出尾入”设计,天生就不擅长批量遍历。
那Disruptor是怎么解决这些问题的?它给出的答案是:用一套极致的、面向硬件的设计,把线程间数据交换的延迟压到几乎不可感知的程度。
一、核心设计思想——不只是“队列”,是“环形缓冲区”
Disruptor并不是一个传统的FIFO队列,它的本质是一个基于数组的环形缓冲区(Ring Buffer)。这套设计的核心思路,可以拆成几条来看。
1. 环形数组,预分配,零GC
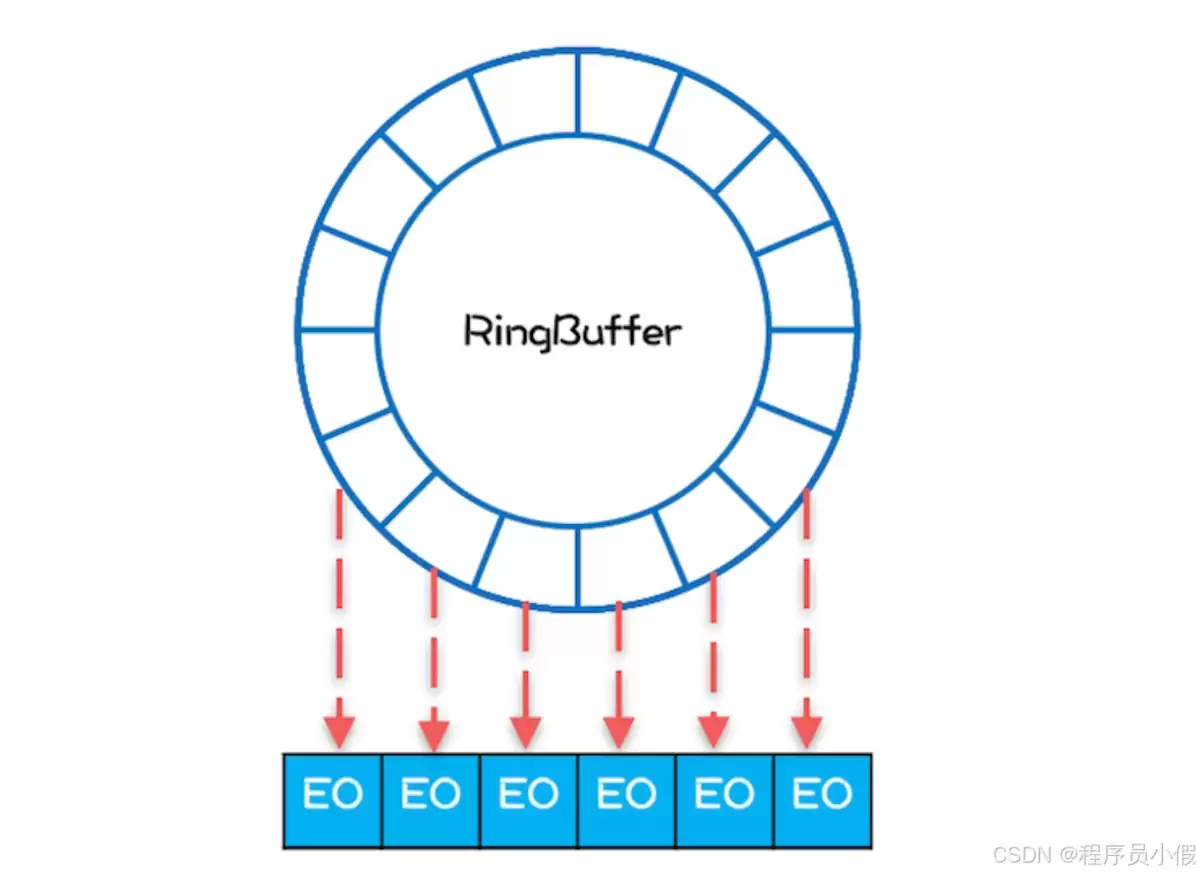
- 用一个固定大小的数组,一次性把所有内存都分好。数组元素(Event)在初始化时就全部创建,重复使用。
- 这意味着——运行时几乎没有动态内存分配,GC压力几乎为零。
- 通过取模运算定位槽位——因为数组大小必须是2的幂次,所以可以用
sequence & (size - 1)这种位运算来高效完成。指针无限递增,永不回收。
2. 无锁设计
- 核心操作完全无锁(Lock-Free),靠的是内存屏障(Memory Barrier)和CAS(Compare-And-Swap)来保证线程安全。
- 生产者之间通过CAS竞争下一个可写的槽位。
- 生产者和消费者之间,通过序列(Sequence)来协调,消费者通过等待策略(Wait Strategy)来感知新数据。
3. 消除伪共享
- 识别出那些会被多个线程频繁写入的关键变量——比如生产者的
cursor,各个消费者的Sequence——然后在这些变量前后填充无意义的字节(padding),确保每个核心变量独占一个完整的CPU缓存行(通常是64字节)。 - 这样一来,一个线程的写入就不会让另一个线程的整个缓存行失效。代价是内存占用更大,但换来的是极致的性能稳定性。
4. 批量处理与依赖关系
- 支持批量处理事件,一次拉取多个,吞吐量提升明显。
- 可以显式地构建消费者之间的依赖关系图——比如“C1和C2都完成了,C3才能开始”,完全无锁,靠序列比较就搞定了。
二、核心组件与原理——拆开来看
1. 环形缓冲区(Ring Buffer)
这是Disruptor的物理存储核心。一个固定大小的Object[]数组,每个位置叫一个“槽”(slot)。关键属性只有两个:
size:必须是2的幂次,比如1024。cursor:生产者的发布序列号,代表最后成功发布的事件位置。这是一个Sequence对象。
有意思的是,缓冲区本身不维护“头”和“尾”指针——头和尾的概念,是由生产者和消费者的Sequence共同决定的。
2. 序列(Sequence)
这是Disruptor的灵魂。一个用padding封装的长整型(long)值。
- 所有需要追踪进度的组件,都有自己的
Sequence:- Ring Buffer的
cursor(本身就是一个Sequence)。 - 每个
EventProcessor(消费者)的Sequence,代表自己已处理到的位置。 - 每个
Producer(如果是多生产者)也有自己的Sequence。
- Ring Buffer的
- Sequence的值单调递增。通过比较不同Sequence的值,就能知道生产和消费的进度关系。简单,但极其有效。
3. 序列屏障(Sequence Barrier)
消费者用来协调工作、控制进度的核心工具。
- 它持有两个东西:生产者(或上游消费者)的
cursor引用,以及所有它所依赖的消费者的Sequence引用(用于构建依赖图)。 - 当一个消费者想要消费事件时,它会问它的
SequenceBarrier:“我可以安全消费的下一个事件是什么?” SequenceBarrier的逻辑很简单:返回min(生产者cursor, 所有依赖的消费者的Sequence)。这就确保了消费者不会超越其依赖者——无锁,但有序。
4. 等待策略(Wait Strategy)
定义了消费者如何等待新事件到来。这是影响延迟和CPU占用的关键选择项。
BlockingWaitStrategy:用锁和条件变量。最省CPU,但延迟最高。适合异步日志等对延迟不敏感的场景。SleepingWaitStrategy:先自旋,后Thread.yield(),最后用LockSupport.parkNanos(1)。平衡延迟和CPU消耗。YieldingWaitStrategy:先自旋100次,然后调用Thread.yield()。延迟低,但CPU占用高。适用于线程数少于CPU核心数的场景。BusySpinWaitStrategy:纯自旋。延迟最低,但CPU会被吃满。必须在绑定核心、线程数少于物理核心数的场景下使用。
5. 事件处理器(EventProcessor)
消费者的执行体。通常指BatchEventProcessor。它是一个线程,内部是一个无限循环:
- 通过
SequenceBarrier.waitFor(nextSequence)等待自己可用的最大nextSequence。 - 拿到
a vailableSequence后,从自己的当前sequence到a vailableSequence批量处理事件。 - 调用
EventHandler.onEvent()处理每个事件。 - 处理完毕,更新自己的消费者
Sequence值。
注意这个“批量”处理——一次等待,处理多个事件,摊薄了每次事件处理的开销。
6. 生产者(Producer)
负责向Ring Buffer发布事件。分为单生产者(Single Producer)和多生产者(Multi Producer)两种模式。
发布过程是一个典型的两阶段提交:
- 申请空间(Claim):
- 单生产者:直接
nextSequence = cursor + 1,无竞争,连CAS都不需要。 - 多生产者:通过CAS操作竞争递增一个
nextSequence。
- 单生产者:直接
- 发布(Publish):
- 生产者把数据写入
nextSequence对应的slot。 - 写完之后,必须调用
RingBuffer.publish(sequence)。 publish方法会先添加内存屏障(store-store barrier,确保数据写入先于cursor更新),然后才把cursor更新到sequence。cursor的更新会通知所有在SequenceBarrier上等待的消费者。
- 生产者把数据写入
三、工作流程示例(单生产者 → 单消费者)
- 初始化:
- Ring Buffer大小为8,
cursor = -1。 - 消费者
Sequence = -1。
- Ring Buffer大小为8,
- 生产者发布事件A:
- 生产者申请下一个位置:
next = cursor + 1 = 0。 - 把事件A的数据写入
RingBuffer[0 & 7],即RingBuffer[0]。 - 写入完成,调用
publish(0),更新cursor = 0。
- 生产者申请下一个位置:
- 消费者消费事件A:
- 消费者线程(
BatchEventProcessor)在循环中调用SequenceBarrier.waitFor(0)。 SequenceBarrier发现cursor (0) >= 0,且没有依赖者,于是返回a vailableSequence = 0。- 消费者知道自己当前的
sequence (-1) < a vailableSequence (0),于是处理RingBuffer[0]的事件A。 - 处理完成,把自己的
Sequence更新为0。
- 消费者线程(
- 循环继续:生产者发布事件B到
slot 1,更新cursor=1。消费者等待并处理,如此往复。
四、多消费者与依赖关系——这才是Disruptor最强大的部分
假设我们有三个消费者:C1负责数据持久化,C2负责数据统计,C3负责发送消息——但C3必须在C1和C2都完成之后才能开始。
- 构建依赖图:
RingBuffer → C1
           → C2
           → C3 (依赖 C1 和 C2)
- C3的
SequenceBarrier会持有RingBuffer.cursor、C1.sequence和C2.sequence。 - 当C3调用
waitFor时,SequenceBarrier返回的是min(生产者cursor, C1.sequence, C2.sequence)。 - 这就意味着——即使生产者已经发布了事件10,但只要C1才处理到5,C3最多也只能拿到5。这样,C3永远不会跑到C1前面去。完全无锁地实现了依赖关系。
五、总结:Disruptor高性能的秘诀
- 预分配内存,消除GC——环形数组+对象复用,运行时没有分配,没有回收。
- 无锁并发——CAS+内存屏障,取代重量级锁。
- 消除伪共享——对关键序列进行缓存行填充。
- 批量处理——一次等待,处理多个事件,摊薄开销。
- 依赖关系感知——通过序列比较,实现无锁的消费者协调,避免了“线程间握手”的开销。
- 关注点分离——并发控制(Sequence、Barrier)、等待逻辑(WaitStrategy)、业务处理(EventHandler)被清晰地解耦。
说到底,Disruptor的本质其实是一种精心设计的内存队列:把共享变量的数量降到最低(核心就是那几个Sequence),并通过硬件友好的方式(缓存行填充、内存屏障)来操作它们,从而在软件层面最大限度地压榨出现代CPU和内存子系统的性能。金融交易、高频计算、事件溯源……那些对延迟和吞吐近乎苛刻的场景,正是它的用武之地。

解析六个GitHub AI开源项目的具体用途,包括软件静态分析、智能体回答检查、多语言配音、求职材料生成、本地代码检索及动态歌词展示,帮助开发者根据实际需求筛选工具并正确验证结果。

遇到OpenCode Skills无法加载或配置无效?本文手把手教你完成Skills的安装、环境变量设置及本地调试,避开常见坑点,让AI助手更懂你的代码习惯。

解决 Visual Studio 2022 编辑时不显示代码分析警告的问题。指南涵盖 .NET 项目实时分析设置、Roslyn 分析器范围调整及错误列表来源筛选,确保开发者能高效利用实时代码诊断功能。

详解 Visual Studio 2022 调试技巧:包括断点设置、监视窗口开启方法、变量添加步骤以及通过 F10 单步执行观察变量值变化的全过程。

针对 Visual Studio 2017 缺乏全局默认编码选项的情况,详解如何利用 .editorconfig 设定项目级 UTF-8 无 BOM 规则,以及手动转换现有文件并校验字节的方法。

解决 Visual Studio 2022 F5 调试报错问题,通过设置启动项目、检查解决方案属性及正确区分类库与应用项目,快速恢复调试功能。

解决Visual Studio 2022离线环境中NuGet包还原失败的难题,涵盖依赖链分析、本地源配置、包集收集及隔离验证步骤,帮助开发者构建稳定的离线开发环境。

解决Visual Studio 2017大型项目加载慢的实用指南。涵盖性能监测、扩展管理、文档恢复优化及版本兼容性检查,帮助开发者精准定位瓶颈并提升工作效率。

详解 Visual Studio 2022 多启动项目配置方法,包括启动动作选择、顺序调整及调试技巧,帮助开发者高效调试分布式或前后端分离应用。

深入解析在FastAPI框架中实现文件下载接口的完整方案,涵盖基于FileResponse的本地静态文件传输、基于StreamingResponse的分块流式传输、RFC 5987中文文件名编码规范、路径穿越安全防御及BackgroundTasks临时文件清理,并配备详细代码示例与架构解析图。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



