

JavaForkJoin框架全面解析:分而治之的并行编程艺术
JavaFork/Join框架基于分治法将大任务递归分解为子任务并行执行,再合并结果。其核心工作窃取算法实现自动负载均衡,空闲线程从繁忙线程队列尾部窃取任务。框架由ForkJoinPool、ForkJoinTask(RecursiveTask/RecursiveAction)组成,适用于数组求和等可分解的并行计算场景,是理解并行编程精髓的关键工具。
Ja va 中的 Fork/Join 框架,名字已经告诉了我们一切:先“Fork”(拆分),再“Join”(合并)。它是专门为“分而治之”这类并行计算场景量身定做的工具,最早在 Ja va 7 里亮相,到了 Ja va 8 又进一步完善。简单说,就是把你手头一个巨大的任务拆成若干小块,扔给多个线程同时去算,最后再把所有小块的结果拼回去。这种方式在处理大数组求和、海量文件遍历、复杂递归计算时,往往能带来肉眼可见的性能提升。
课程导言
适用对象
如果你已经掌握了 Ja va 多线程基础(比如 Thread、Runnable、synchronized),并且对 JUC 里的线程池、ConcurrentHashMap 这些工具有了初步了解,那么 Fork/Join 就是你下一步值得攻克的方向。它是 Ja va 并发编程里的高级话题,学会它,你才算真正理解了“分而治之”在并行计算中的精髓,也为后续理解 MapReduce 这类大数据处理框架铺好了路。
学习目标
通过这篇文章,你会收获以下几点:
- 理解 Fork/Join 的两大核心思想:分治法与工作窃取算法
- 掌握 ForkJoinPool、ForkJoinTask、RecursiveTask 和 RecursiveAction 的核心 API
- 熟练使用 Fork/Join 框架解决那些可以被分解的并行计算问题
- 学会 任务粒度的选取、性能调优的套路,以及常见的坑怎么绕
- 了解 Fork/Join 在现代 Ja va 并发生态中的地位,比如它在 Parallel Stream 中扮演的角色
为什么需要 ForkJoin?
在并发编程里,我们经常会遇到一类大任务:比如遍历一个超大数组求和、处理海量文件、计算复杂的递归函数(像斐波那契数列),或者做并行排序。这些任务天然适合“拆开来干”——拆成小任务并行执行,最后再把结果合并。如果能做到,性能会有质的飞跃。
传统的 ThreadPoolExecutor 虽然也能处理多任务,但它有一个很头疼的问题:当任务之间出现父子依赖关系时,怎么调度才高效? 举个例子,一个父任务需要拆成两个子任务,只有两个子任务都完成,父任务才能继续。用传统线程池,你得自己手动管理这些依赖关系,写出来的代码不仅复杂,而且容易出错。
Fork/Join 框架就是 JDK 为这种场景量身打造的专门解决方案。它由并发大师 Doug Lea 设计,从 JDK 7 开始引入,是 ja va.util.concurrent 包中最精巧、最高效的组件之一。
第一部分:核心思想——分治法 + 工作窃取
1.1 分治法:从大化小,逐个击破
分治法(Divide-and-Conquer)不是什么新鲜概念,核心就十二个字:分解、解决、合并。
- 分解(Fork):把一个大的任务递归地拆成若干个规模更小的子任务,直到子任务简单到可以直接计算(达到你设定的阈值)。
- 解决:把这些子任务并行执行。
- 合并(Join):等所有子任务都搞定后,按顺序把它们的结果合并起来,得到最终结果。
这种思路天然适合并行处理。常见的应用包括归并排序、快速排序、大数求和、矩阵运算等。
1.2 工作窃取:自动负载均衡的灵魂
工作窃取(Work-Stealing)算法是 Fork/Join 框架性能卓越的核心所在。它解决了传统线程池里线程负载不均的痛点。
为什么需要工作窃取?
想象一下:我们把一个大任务拆成了 10 个小任务,开了 5 个线程去干。但每个任务的实际执行时间是不一样的——有的线程很快搞完了,有的还在忙。如果那些空闲的线程只会傻等,CPU 资源就被白白浪费了。工作窃取的思路就是:空闲线程主动去“偷”繁忙线程的任务来干。
工作窃取的实现原理
- 每个线程有自己的双端队列:在 ForkJoinPool 里,每个工作线程(
ForkJoinWorkerThread)都维护着一个双端队列(Deque),用来存放分配给它的任务。 - 线程从队列头部取任务:当线程执行自己的任务时,按 **LIFO(后进先出)** 的顺序从队列头部取任务。为啥用 LIFO?因为最新推入的任务通常是最新拆分的子任务,它的相关数据很可能还在 CPU 缓存里,执行效率更高。
- 窃取线程从队列尾部偷任务:当一个线程的任务队列空了,它不会闲着,而是随机挑一个其他线程的队列,从那个队列的尾部偷一个任务来执行。偷的时候采用 **FIFO(先进先出)** 的顺序。
- 双端队列减少竞争:这种设计巧妙之处在于,被偷的线程(操作头部)和偷任务的线程(操作尾部)通常操作的是队列的不同端,只有在队列里只剩一个任务时才会发生竞争,但这种情况发生的概率很低。
工作窃取的优点:
- 自动负载均衡:空闲线程自动帮繁忙线程干活,CPU 所有核心都能充分利用。
- 减少竞争:双端队列的设计让大部分操作无锁化。
- 高效缓存利用:LIFO 的处理方式提高了缓存命中率。
缺点:在某些极端情况下(比如队列里只剩一个任务),仍然存在竞争;同时维护多个双端队列也会带来额外开销。
第二部分:ForkJoin 框架核心组件
Fork/Join 框架由三个核心组件构成:
2.1 ForkJoinPool —— 任务调度器
ForkJoinPool 是 Fork/Join 框架的线程池实现,它继承了 AbstractExecutorService,所以本质上也是一个 ExecutorService。但它和 ThreadPoolExecutor 最大的不同是:它内部没有一个全局共享的任务队列,而是维护了一个工作队列数组(WorkQueue[]),每个工作队列对应一个工作线程。
创建 ForkJoinPool
// 方式一:使用默认构造器(并行度 = CPU核心数)
ForkJoinPool pool1 = new ForkJoinPool();
// 方式二:指定并行度
ForkJoinPool pool2 = new ForkJoinPool(4); // 使用4个线程
// 方式三:使用公共池(推荐!)
ForkJoinPool commonPool = ForkJoinPool.commonPool();
关于公共池(commonPool):从 JDK 8 开始,ForkJoinPool 提供了一个静态的 commonPool() 方法,返回一个全局共享的线程池实例。官方强烈推荐大多数应用程序都使用这个公共池,因为它能节省资源,让多个 Fork/Join 任务共享同一个线程池,避免创建大量线程。公共池的线程在空闲时会被慢慢回收,需要时再重新创建。Parallel Stream 底层用的就是这个公共池。
核心方法
| 方法 | 描述 |
|---|---|
execute(ForkJoinTask) | 异步执行任务,无返回值 |
submit(ForkJoinTask) | 异步执行任务,返回 Future 对象 |
invoke(ForkJoinTask) | 同步执行任务,等待任务完成并返回结果 |
invokeAll(ForkJoinTask...) | 批量提交多个子任务,等待所有完成 |
2.2 ForkJoinTask —— 任务的抽象
ForkJoinTask 是提交给 ForkJoinPool 执行的任务的基类。它提供了 fork()、join() 等核心方法,并实现了 Future 接口。在实际开发中,我们几乎从不直接继承 ForkJoinTask,而是继承它的两个抽象子类:
RecursiveTask —— 有返回值的任务
适用于那些需要返回计算结果的任务,比如数组求和、斐波那契数列计算。
核心方法:protected abstract V compute(),你需要在这个方法里实现任务的分解和计算逻辑。
RecursiveAction —— 无返回值的任务
适用于只需要执行动作、不需要返回结果的任务,比如遍历目录、批量修改数组元素。
核心方法:protected abstract void compute()。
fork() 与 join() 的奥秘
- fork():异步执行当前任务。它并不是简单地启动一个新线程,而是把当前任务推入当前工作线程的工作队列(如果当前线程是
ForkJoinWorkerThread),或者推入ForkJoinPool的提交队列。fork() 方法会立即返回,不会阻塞。 - join():等待任务执行完成并获取结果。如果任务还没完成,join() 会阻塞当前线程,直到任务完成。有意思的是,在阻塞期间,如果当前线程是工作线程,它不会傻等着,而是会尝试窃取并执行其他任务,从而提高 CPU 利用率——这正是 Fork/Join 框架设计的精妙之处。
关键理解:fork() 和 join() 的配对使用,再加上工作窃取机制,使得 Fork/Join 框架能够用少量线程高效处理大量有依赖关系的任务。
2.3 ForkJoinWorkerThread —— 执行任务的工作线程
这是真正执行 ForkJoinTask 的线程。每个工作线程都关联着一个自己的双端队列,用来存放它 fork 出来的子任务。工作线程的生命周期由 ForkJoinPool 统一管理。
第三部分:实战案例——从入门到精通
理论说完了,现在通过三个由浅入深的实战案例,带你真正掌握 Fork/Join 的用法。
3.1 案例一:数组求和(RecursiveTask 入门)
这是 Fork/Join 最经典的入门案例。我们计算一个超大数组中所有元素的和。
代码实现
import ja va.util.concurrent.ForkJoinPool; import ja va.util.concurrent.RecursiveTask; /** * 使用Fork/Join计算数组求和 */ public class ArraySumCalculator extends RecursiveTask{ private final int[] array; private final int start; private final int end; private static final int THRESHOLD = 10000; // 阈值:当数组长度小于此值时,不再拆分 public ArraySumCalculator(int[] array) { this(array, 0, array.length); } private ArraySumCalculator(int[] array, int start, int end) { this.array = array; this.start = start; this.end = end; } @Override protected Long compute() { int length = end - start; // 1. 如果任务足够小,直接计算(不再分解) if (length <= THRESHOLD) { return computeDirectly(); } // 2. 任务拆分 int mid = start + length / 2; ArraySumCalculator leftTask = new ArraySumCalculator(array, start, mid); ArraySumCalculator rightTask = new ArraySumCalculator(array, mid, end); // 3. 异步执行左半部分任务(fork) leftTask.fork(); // 4. 当前线程继续执行右半部分(同步执行) Long rightResult = rightTask.compute(); // 5. 等待左半部分结果(join) Long leftResult = leftTask.join(); // 6. 合并结果 return leftResult + rightResult; } private long computeDirectly() { long sum = 0; for (int i = start; i < end; i++) { sum += array[i]; } return sum; } public static void main(String[] args) { // 创建测试数组:1到10000000 int[] array = new int[10_000_000]; for (int i = 0; i < array.length; i++) { array[i] = i + 1; } // 使用ForkJoin计算 ForkJoinPool pool = new ForkJoinPool(); ArraySumCalculator task = new ArraySumCalculator(array); long startTime = System.currentTimeMillis(); Long result = pool.invoke(task); long endTime = System.currentTimeMillis(); System.out.println("计算结果: " + result); System.out.println("耗时: " + (endTime - startTime) + "ms"); // 验证结果(数学公式:n(n+1)/2) long expected = (long) array.length * (array.length + 1) / 2; System.out.println("结果正确: " + result.equals(expected)); pool.shutdown(); } }
代码详解
- 阈值(THRESHOLD):决定什么时候停止拆分。设得太小会导致任务拆得太细,调度开销反而大于计算本身;设得太大又会导致并行度不足。实际使用需要根据场景反复调试。
- compute() 方法:核心逻辑。先判断任务够不够小,是就直接算;否则拆成左右两个子任务。
- fork() 与 compute() 的配合:这里我们
fork()了左任务,右任务由当前线程同步执行。这是一种常见的优化写法,比同时 fork 两个任务再 join 要高效得多。 - join():等待左任务完成并拿到结果,然后合并。
为什么不是先 fork 两个任务再 join?
错误的写法:
leftTask.fork();
rightTask.fork();  // 这样效率低下!
Long leftResult = leftTask.join();
Long rightResult = rightTask.join();
这种写法会先 fork 两个子任务,然后 join 等待。问题是:fork 之后,两个子任务都进了工作队列,等着被其他空闲线程偷走执行。如果此时有空闲线程,那没问题;但如果没有空闲线程,而当前线程又在 join 等待,那就浪费了一个线程资源。正确的做法是:fork 一个任务,然后当前线程同步执行另一个任务,这样就能确保当前线程在等待期间不会闲着。
3.2 案例二:斐波那契数列(递归任务)
斐波那契数列天然就是一个递归问题,很适合拿 Fork/Join 来演示 API。
import ja va.util.concurrent.ForkJoinPool; import ja va.util.concurrent.RecursiveTask; public class FibonacciTask extends RecursiveTask{ private final int n; public FibonacciTask(int n) { this.n = n; } @Override protected Integer compute() { if (n <= 1) { return n; } // 创建子任务:f(n-1) 和 f(n-2) FibonacciTask f1 = new FibonacciTask(n - 1); FibonacciTask f2 = new FibonacciTask(n - 2); // 异步执行f1 f1.fork(); // 同步执行f2 int result2 = f2.compute(); // 获取f1的结果 int result1 = f1.join(); return result1 + result2; } public static void main(String[] args) { ForkJoinPool pool = new ForkJoinPool(); int n = 10; // 计算第10个斐波那契数 int result = pool.invoke(new FibonacciTask(n)); System.out.println("Fibonacci(" + n + ") = " + result); // 输出55 } }
需要提醒的是:虽然这个例子展示了 Fork/Join 的用法,但斐波那契数列并不适合用 Fork/Join,因为它的计算量太小,任务拆分开销远大于计算本身,实际跑起来可能比普通递归还慢。这个案例纯粹是为了帮你理解 API。
3.3 案例三:遍历目录统计文件(RecursiveAction 实战)
这个案例更有实际价值:统计一个目录及其子目录下所有 .ja va 文件的数量。因为不需要返回值,我们用 RecursiveAction。
import ja va.io.File;
import ja va.util.ArrayList;
import ja va.util.List;
import ja va.util.concurrent.ForkJoinPool;
import ja va.util.concurrent.RecursiveAction;
public class FileCounter extends RecursiveAction {
    private final File directory;
    private final String extension;
    private int count = 0; // 统计结果
    public FileCounter(File directory, String extension) {
        this.directory = directory;
        this.extension = extension;
    }
    public int getCount() {
        return count;
    }
    @Override
    protected void compute() {
        File[] files = directory.listFiles();
        if (files == null) return;
        List subTasks = new ArrayList<>();
        for (File file : files) {
            if (file.isDirectory()) {
                // 创建子任务处理子目录
                FileCounter subTask = new FileCounter(file, extension);
                subTask.fork(); // 异步执行
                subTasks.add(subTask);
            } else if (file.getName().endsWith(extension)) {
                count++;
            }
        }
        // 等待所有子任务完成,并累加结果
        for (FileCounter subTask : subTasks) {
            subTask.join();
            count += subTask.getCount();
        }
    }
    public static void main(String[] args) {
        ForkJoinPool pool = new ForkJoinPool();
        FileCounter task = new FileCounter(new File("/path/to/your/project"), ".ja va");
        pool.invoke(task); // 同步等待
        System.out.println("找到 " + task.getCount() + " 个 .ja va 文件");
    }
}
第四部分:适用场景与注意事项
4.1 适用场景
Fork/Join 框架最适合解决以下类型的问题:
| 场景类型 | 示例 | 说明 |
|---|---|---|
| 计算密集型任务 | 大数组数学运算、矩阵乘法 | 任务需要大量 CPU 计算,分解后可以并行加速 |
| 可递归分解的任务 | 归并排序、快速排序、文件遍历 | 天然的分治结构 |
| 任务之间相互独立 | 图像处理(每个像素独立) | 无需同步,没有数据竞争 |
| 任务粒度适中 | 每个子任务计算量在数万到数百万次操作 | 太细则调度开销大,太粗则并行度不足 |
4.2 不适用场景
| 场景类型 | 原因 |
|---|---|
| I/O密集型任务 | 线程会在 I/O 操作时阻塞,浪费 CPU,且工作窃取无法发挥作用 |
| 需要频繁同步的任务 | 锁竞争会抵消并行带来的好处 |
| 任务粒度太细 | 创建任务、调度、合并的开销超过计算本身 |
| 无法分解的串行任务 | 分治思想的前提就是可以分解 |
对于 I/O 密集型任务,可以考虑配合 ManagedBlocker 使用,或者改用 CompletableFuture。
4.3 如何选择合适的阈值?
阈值的选择是 Fork/Join 调优的关键。没有固定的公式,一般遵循以下原则:
- 通过实验确定:编写测试代码,对不同阈值进行压测,找出性能最优值。
- 参考经验值:对于简单的数组遍历,阈值在 1000~10000 之间比较常见。
- 动态调整:高级用法中,可以通过
getSurplusQueuedTaskCount()方法判断当前线程的负载,动态决定是否继续拆分。
4.4 常见陷阱与注意事项
陷阱1:在任务中执行阻塞操作
如果在 compute() 方法里执行了 Thread.sleep()、等待 I/O 等阻塞操作,会导致工作线程被阻塞,没法再去执行其他任务,并行效率会严重下降。解决方案是使用 ForkJoinPool.ManagedBlocker 接口,或者把阻塞部分放到 CompletableFuture 中处理。
陷阱2:忘记合并结果
// 错误的做法:fork了子任务却没有join
leftTask.fork();
rightTask.fork();
// 这里应该join,但没有
陷阱3:任务拆分过深导致栈溢出
递归调用太深可能导致 StackOverflowError。可以适当增大阈值,或者采用非递归的实现方式。
陷阱4:错误使用 invokeAll
invokeAll() 方法是批量提交任务的便捷方式,它会等待所有任务完成。但要注意,invokeAll() 内部已经包含了 fork 操作,不需要再对子任务单独调用 fork。
// 正确用法
invokeAll(leftTask, rightTask);
// 然后通过leftTask.join()获取结果
陷阱5:忘记处理异常
ForkJoinTask 在执行过程中可能抛出异常,但异常不会直接传播给调用者。需要通过 isCompletedAbnormally() 和 getException() 方法检查异常。
if (task.isCompletedAbnormally()) {
    Throwable ex = task.getException();
    ex.printStackTrace();
}
陷阱6:死锁风险
虽然 Fork/Join 框架内部不会死锁,但如果你在任务中等待其他任务的结果时形成了循环依赖,仍然可能死锁。确保任务之间的依赖关系是树形的,而不是环形的。
4.5 性能优化策略
为了充分发挥 Fork/Join 的性能,可以采取以下优化措施:
- 合理设置并行度:默认等于 CPU 核心数。对于计算密集型任务,这个值通常是合适的。可以通过
-Dja va.util.concurrent.ForkJoinPool.common.parallelism=N调整公共池的并行度。 - 使用
compute()而不是fork().join():如前面案例所示,fork 一个任务,同步执行另一个,可以减少任务调度开销。 - 避免任务粒度过细:每个任务至少要有数千次操作,否则调度开销会超过计算本身。
- 优先使用公共池:除非有特殊需求,否则使用
ForkJoinPool.commonPool()。 - 监控和调优:通过
getPoolSize()、getActiveThreadCount()等方法监控线程池状态,分析性能瓶颈。
第五部分:ForkJoin 与现代 Ja va 并发生态
5.1 Parallel Stream(并行流)
从 JDK 8 开始,Stream API 引入了并行流(.parallelStream()),其底层正是基于 Fork/Join 框架的公共池实现的。
// 使用并行流计算数组和
long sum = Arrays.stream(array).parallel().sum();
并行流封装了 Fork/Join 的复杂性,让你可以用声明式的方式编写并行代码。但需要注意的是,并行流默认使用公共池,对于某些 I/O 操作或阻塞操作,可能不是最佳选择。
5.2 CompletableFuture
CompletableFuture 是 JDK 8 引入的异步编程工具,它内部使用了 ForkJoinPool.commonPool() 作为默认的异步执行器。你可以通过 thenApplyAsync()、thenComposeAsync() 等方法指定使用自定义的线程池,包括 ForkJoinPool。
5.3 与其他并发框架的对比
| 框架 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| ForkJoin | 可分解的计算密集型任务 | 高效利用CPU,自动负载均衡 | 不适合I/O任务 |
| ThreadPoolExecutor | 通用任务处理 | 灵活,可定制 | 处理依赖任务复杂 |
| CompletableFuture | 异步任务编排 | 功能强大,支持链式调用 | 学习曲线较陡 |
| Parallel Stream | 集合数据处理 | 声明式,简洁 | 控制粒度较粗 |
第六部分:深入源码(选读)
6.1 ForkJoinPool 的核心数据结构
ForkJoinPool 内部维护了一个 WorkQueue 数组 workQueues。每个 WorkQueue 是一个双端队列,存储着 ForkJoinTask。工作线程与队列的对应关系是:
- 下标为奇数的队列:由工作线程独占
- 下标为偶数的队列:用于存放外部提交的任务(共享队列)
ForkJoinPool 还维护了一个复杂的控制信号量 ctl,用于管理线程的状态(活跃、等待、终止等)。
6.2 工作窃取的实现细节
当工作线程自己的队列为空时,会调用 scan() 方法尝试窃取。它会随机选择一个其他线程的队列,从尾部获取一个任务。为了防止竞争,这个操作使用了 Unsafe 的 CAS 方法。
如果窃取也失败,线程会进入等待状态,将自己挂起。当有新任务提交时,挂起的线程会被唤醒。
6.3 提交任务的流程
当我们调用 pool.invoke(task) 时,流程如下:
- 将任务放入
ForkJoinPool的外部提交队列(偶数下标) - 如果当前没有活跃的工作线程,创建一个
- 工作线程从队列中取出任务执行
- 任务中的
fork()会将子任务放入当前工作线程自己的队列(奇数下标)
美国俄勒冈州立大学研发出集成感知、存储与处理的新型光敏器件,具备可编程遗忘机制。通过栅极电压调控电荷位置,可主动增强或衰减记忆,有效降低能耗,为高效低功耗人工智能硬件提供新方向。
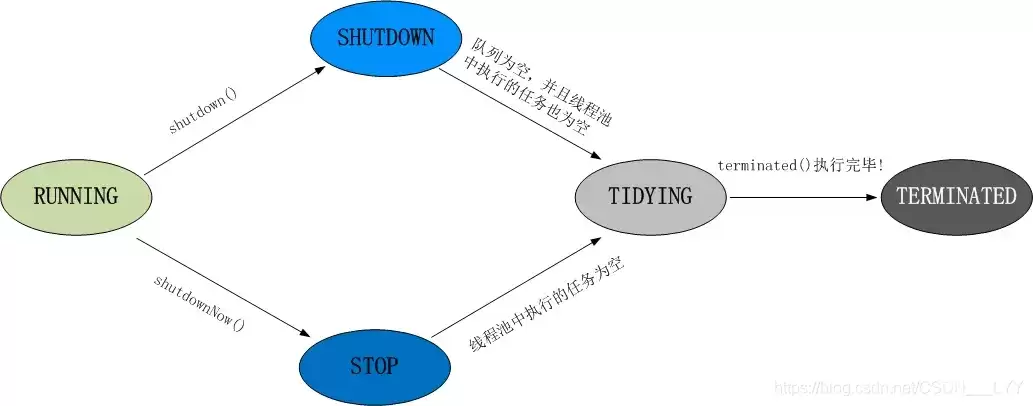
二进制操作在框架设计中被频繁使用,使用二进制在不同场景有提升计算速度、较少内存占用等多种优点;下面,我们依据线程池的状态管理,来看下怎么通过操作二进制对状态进行管理,过程中会发现编程之美~线程池状态首先,为了文章的完整性,我们还是先了解一下线程池的状态,总结如下如: 线程池状态分为5种:RUNNIN
以色列希伯来大学在《自然·通讯》发表研究,利用RNA反式剪接构建模块化人工遗传系统,使人类细胞能自主计算决策。系统内含全加法器与多路复用器,可并行处理多路信号并自带安全机制,未来可用于智能治疗细胞。
百度官方在线入口最新版网页版直达官网是https://www.baidu.com/,界面简洁无干扰、多端同步体验一致、内容聚合维度丰富、语音与图像识别稳定、隐私控制机制可见。
OpenAI发布GPT-5.6系列模型(Sol、Terra、Luna),结束12天受限预览。独立运行近一年的Codex应用并入ChatGPT桌面端,整合对话、编程与长程任务执行。新模型强调性能、速度与成本平衡,Sol在编程和Agent场景表现领先,但综合推理仍不及Claude系列。同步推出ChatGPTWork智能体,并实现Luna后训练由Sol自主完成。
必应Bing国际版官网入口是www.bing.com。该网址支持多语言和区域设置,提供多样化的搜索结果及个性化功能,如跨设备同步、主题更换和每日精选壁纸等。
百度官方网站入口链接是www.baidu.com,用户可通过该网址访问百度搜索及地图、网盘等服务,登录账号管理个人信息,并使用站长工具提交资源、分析数据。
Java游戏开发中常见性能卡顿、逻辑错误、维护困难及兼容性问题。应使用剖析工具定位性能瓶颈,关注并发与事件处理逻辑,通过单元测试验证。代码需遵循设计模式,保持模块独立。环境应确保JDK与依赖库版本兼容,并建立从单元到压力的多层次测试体系,结合重构持续优化。
Java游戏开发凭借跨平台特性广泛应用于移动端、网页及独立游戏领域。入门需掌握核心特性与框架选择,搭建开发环境。关键环节包括理解游戏循环、架构设计与图形渲染,并高效处理输入、更新与渲染。之后实现交互逻辑,进行性能与游戏性优化,最终打包发布,完成开发闭环。
数据处理服务因缓存策略缺陷导致内存过高和崩溃。通过监控工具定位问题后,修复了缓存逻辑、移除冗余缓存并完成测试验证。案例总结出高效解决问题的关键:准确定义问题、善用工具、分解步骤、深挖根源、验证预防,体现了系统性思维与经验积累的重要性。





火山引擎是字节跳动旗下企业级云与AI服务平台。聚焦大模型核心能力,依托字节自研豆包多模态大模型,凭借火山方舟一站式平台,提供模型精调、推理部署、智能应用搭建等全链路服务,结合高性能AI算力,助力各行业快速落地大模型数字化与智能化应用。



